高通正式推出 Snapdragon 870 5G 行動平台,小米、MOTO、一加等品牌將使用_網頁設計公司

※想知道最厲害的網頁設計公司嚨底家"!

RWD(響應式網頁設計)是透過瀏覽器的解析度來判斷要給使用者看到的樣貌

行動裝置處理器知名大廠高通技術公司(Qualcomm)今日宣布推出 Qualcomm Snapdragon™ 870 5G 行動平台,是Snapdragon 865 Plus旗艦行動平台的升級產品,採用台積電的第二代7奈米鰭式場效電晶體製程技術所打造,搭載核心時脈速度高達3.2 GHz的增強版高通Kryo™ 585 CPU與 Adreno650 GPU。與 S888 將 5G 基頻晶片封裝進處理器不同,Snapdragon 870 一樣採用外掛 X55 基頻方式設計,可視為 Snapdragon 865 的升級版。

高通正式推出 Snapdragon 870 5G 行動平台

由於三星負責生產的 5 奈米 S888 處理器發生耗電與發熱等問題,加上台積電產能滿載暫時可能也無法接手高通 S888 訂單,高通目前可能有意藉 Snapdragon 870 延長 Snapdragon 865 壽命,也讓消費者如果對 Snapdragon 888 有疑慮的話還有其他產品可以選擇。目前確定搭 Qualcomm Snapdragon 870 處理器的品牌包括Motorola、iQOO、OnePlus、 OPPO和小米將會在 2021 第一季推出相關產品。

中國媒體實測高通 S888 處理器後,竟用「翻車」形容!功耗高也非常燙

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

當全世界的人們隨著網路時代而改變向上時您還停留在『網站美醜不重要』的舊有思維嗎?機會是留給努力改變現況的人們,別再浪費一分一秒可以接觸商機的寶貴時間!

您也許會喜歡:

【推爆】終身$0月租 打電話只要1元/分

立達合法徵信社-讓您安心的選擇

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

透過資料庫的網站架設建置,建立公司的形象或購物系統,並提供最人性化的使用介面,讓使用者能即時接收到相關的資訊

Google 打算阻止在未經認證手機運行「訊息」應用,或從 3 月底開始實施_網頁設計

※推薦評價好的iphone維修中心

擁有專業的維修技術團隊,同時聘請資深iphone手機維修專家,現場說明手機問題,快速修理,沒修好不收錢

Google 訊息應用因為 RCS 和方便的網頁版等獨特功能,已經成為 Android 生態系統中除了社群軟體外頗受歡迎且不可缺少的應用程式,比許多手機廠商預載的訊息應用程式更加便利好用。不過看來在今年稍晚,Google 打算不再讓未經認證的手機運行這款應用。

Google 打算阻止在未經認證手機運行「訊息」應用,或從 3 月底開始實施

一款搭載 Android 系統的手機要正式被視為是 Android 認證設備,必須在產品發表前就完成了 Google 認證流程,然後才能安裝與提供整套的 Google Mobile Services (GMS)套裝應用,其中包含 Google Play 等屬於關鍵性的應用程式。在過去曾經可以藉由用戶手動安裝的方式在未經認證的 Android 上使用,值到 2 年前,Google 開始阻止未經認證的裝置,甚至不允許這些裝置登入 Google 帳號。

從廣義上來說, Google 訊息與未經認證的 Android 手機無關,因為在大多數設備上皆未預裝訊息應用程式,所以用戶必須從 Google Play 中手動下載安裝,但隨著 Google 訊息 7.2 測試版的推出,國外媒體 9to5Google 在應用程式代碼中發現一段新的通知訊息,表示從 3 月底開始,訊息應用將停止在未經認證的設備上運作。

這項政策改變的一個潛在原因在於最近 Google 在訊息應用中添加了點對點加密來強化安全性,在去年時,Google 重申華為手機用戶不應該將手機刷成 GMS 服務的,並且強調未經認證的設備因為沒有經過安全性驗證,因此訊息加密可能會因此而被破壞。

※台北網頁設計公司這麼多該如何選擇?

網動是一群專業、熱情、向前行的工作團隊,我們擁有靈活的組織與溝通的能力,能傾聽客戶聲音,激發創意的火花,呈現完美的作品

◎資料來源: 9to5Google 

您也許會喜歡:

【推爆】終身$0月租 打電話只要1元/分

立達合法徵信社-讓您安心的選擇

※網頁設計最專業,超強功能平台可客製化

窩窩以「數位行銷」「品牌經營」「網站與應用程式」「印刷品設計」等四大主軸,為每一位客戶客製建立行銷脈絡及洞燭市場先機。

Sony Mobile 中階新機 Xperia 10 III 高清晰渲染圖曝光:外型與前代相似、仍將保留3.5mm耳機孔_潭子電動車

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

有別於一般網頁架設公司,除了模組化的架站軟體,我們的營業主軸還包含:資料庫程式開發、網站建置、網頁設計、電子商務專案開發、系統整合、APP設計建置、專業網路行銷。

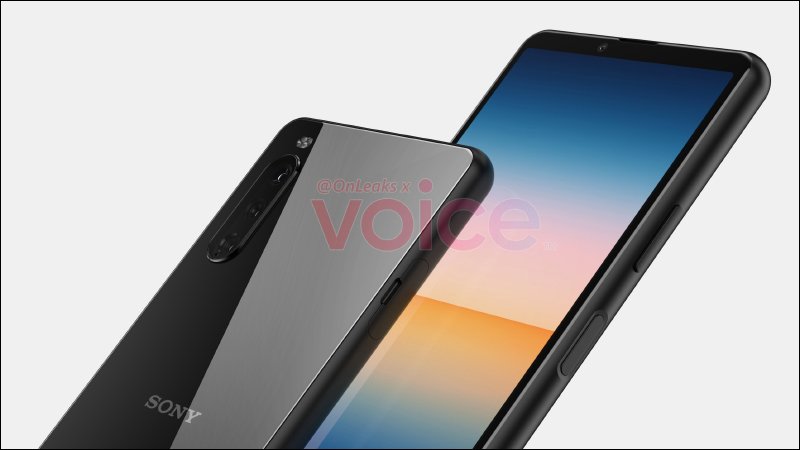
去年五月初, Sony Mobile 在台灣推出 Xperia 10 系列中階手機 Xperia 10 II ,在稍早爆料大神 @OnLeaks 也在 Voice 分享了次世代 Xperia 10 系列新機的外觀面貌,若依照過去的命名規則新一代應會命名為 Xperia 10 III 。外觀方面, Xperia 10 III 大致上仍延續過往 Xperia 手機的設計風格,新機仍將保留 3.5mm 耳機插孔。

▲圖片來源:OnLeaks(Voice)

Sony Mobile 中階新機 Xperia 10 III 高清晰渲染圖曝光:外型與前代相似、仍將保留3.5mm耳機孔

稍早 OnLeaks(Steve Hemmerstoffer)在 Voice 分享了首批曝光的 Xperia 10 III(Xperia 10 Mark 3)外觀渲染圖,並透露 Sony Mobile 很可能在接下來幾週內發表這款新機。

根據 OnLeaks 的爆料內容, Xperia 10 III 的機身尺寸約為 154.4*68.4*8.3mm(機身厚度計算後鏡頭高度為 9.1mm),螢幕尺寸將延續前一代採用 6 吋 21:9 比例終極寬螢幕設計,雖然螢幕邊框似乎沒有明顯更窄,也未目前手機市場常見的挖孔螢幕創造更大的螢幕尺碼,但這相對保守的設計仍有許多喜愛它的族群。

▲圖片來源:OnLeaks(Voice)

音效方面,在 Xperia 10 III 預計仍保留雙前置立體聲揚聲器,延續這項設計也是可預期的決定。相機部份, Xperia 10 III 傳聞將配備三鏡頭主相機,分別為 1200 萬像素主鏡頭、800 萬像素望遠鏡頭和 800 萬像素超廣角鏡頭,前相機則搭載 800 萬像素自拍鏡頭,不過關於相機方面規格的升級尚未有更多詳細的資訊。

▲圖片來源:OnLeaks(Voice)

值得慶幸的是 Xperia 10 III 仍將保留 3.5mm 耳機插孔,對於選購中階手機的用戶來說還是相當重要的。

▲圖片來源:OnLeaks(Voice)

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

日本、大陸,發現這些先進的國家已經早就讓電動車優先上路,而且先進國家空氣品質相當好,電動車節能減碳可以減少空污

消息來源:Steve H.McFly(Twitter/@OnLeaks)|OnLeaks(Voice)

延伸閱讀:
ROG Phone 5 真機動圖曝光!機身背面加入 ROG Vision 功能副螢幕,可顯示遊戲、充電、來電通知等訊息

您也許會喜歡:

【推爆】終身$0月租 打電話只要1元/分

立達合法徵信社-讓您安心的選擇

※超省錢租車方案

商務出差、學生出遊、旅遊渡假、臨時用車!GO 神州租賃有限公司!合法經營、合法連鎖、合法租賃小客車!

[統計信息系列7] Oracle 11g的自動統計信息收集_如何寫文案

※教你寫出一流的銷售文案?

銷售文案是什麼?A文案是廣告用的文字。舉凡任何宣傳、行銷、販賣商品時所用到的文字都是文案。在網路時代,文案成為行銷中最重要的宣傳方式,好的文案可節省大量宣傳資源,達成行銷目的。


(一)統計信息收集概述
在Oracle 11g中,默認有3個自動任務,分別是:自動統計信息收集、SQL調優顧問、段空間調整顧問,查看方法如下:

SQL> SELECT CLIENT_NAME,TASK_NAME,OPERATION_NAME,STATUS FROM dba_autotask_task;

CLIENT_NAME                      TASK_NAME                  OPERATION_NAME             STATUS
-------------------------------- -------------------------- -------------------------- --------
 sql tuning advisor               AUTO_SQL_TUNING_PROG       automatic sql tuning task  ENABLED
 auto optimizer stats collection gather_stats_prog auto optimizer stats job ENABLED
 auto space advisor               auto_space_advisor_prog    auto space advisor job     ENABLED

灰色背景行代表自動統計信息收集,使用的任務為gather_stats_prog。gather_stats_prog調用了DBMS_STATS.GATHER_DATABASE_STATS_JOB_PROC存儲過程

SQL> SELECT PROGRAM_NAME,PROGRAM_TYPE,PROGRAM_ACTION FROM dba_scheduler_programs  WHERE PROGRAM_NAME = 'GATHER_STATS_PROG';

PROGRAM_NAME                   PROGRAM_TYPE      PROGRAM_ACTION
------------------------------ ----------------  --------------------------------------------------------------------------------
 GATHER_STATS_PROG              STORED_PROCEDURE  dbms_stats.gather_database_stats_job_proc

在Oracle 11g中,一共配置了7個自動維護窗口,每天一個窗口

SQL> SELECT WINDOW_NAME,AUTOTASK_STATUS FROM dba_autotask_window_clients  ;

WINDOW_NAME                    AUTOTASK_STATUS
------------------------------ ---------------
MONDAY_WINDOW                  ENABLED
TUESDAY_WINDOW                 ENABLED
WEDNESDAY_WINDOW               ENABLED
THURSDAY_WINDOW                ENABLED
FRIDAY_WINDOW                  ENABLED
SATURDAY_WINDOW                ENABLED
SUNDAY_WINDOW                  ENABLED

每個窗口的運行時間如下:

SQL> SELECT a.WINDOW_NAME,a.REPEAT_INTERVAL,a.duration FROM dba_scheduler_windows a WHERE ENABLED = 'TRUE';

WINDOW_NAME         REPEAT_INTERVAL                                          DURATION         
 ------------------  -------------------------------------------------------  -----------------
 MONDAY_WINDOW       freq=daily;byday=MON;byhour=22;byminute=0; bysecond=0    +000 04:00:00
 TUESDAY_WINDOW      freq=daily;byday=TUE;byhour=22;byminute=0; bysecond=0    +000 04:00:00
 WEDNESDAY_WINDOW    freq=daily;byday=WED;byhour=22;byminute=0; bysecond=0    +000 04:00:00
 THURSDAY_WINDOW     freq=daily;byday=THU;byhour=22;byminute=0; bysecond=0    +000 04:00:00
 FRIDAY_WINDOW       freq=daily;byday=FRI;byhour=22;byminute=0; bysecond=0    +000 04:00:00
 SATURDAY_WINDOW     freq=daily;byday=SAT;byhour=6;byminute=0; bysecond=0     +000 20:00:00
 SUNDAY_WINDOW       freq=daily;byday=SUN;byhour=6;byminute=0; bysecond=0     +000 20:00:00

可以看到,從周一到周五,窗口運行時間為晚上22點開始,最多運行4個小時,周六周日從早上6點開始,最多運行20個小時。

在窗口任務啟動時,自動任務GATHER_STATS_PROG每次運行時會先生成ORA$AT_OS_OPT_xxx的作業,然後再執行這個作業。

SQL> SELECT a.JOB_NAME,a.ACTUAL_START_DATE,a.RUN_DURATION,a.STATUS
   2  FROM   dba_scheduler_job_run_details a
   3  WHERE  a.JOB_NAME LIKE 'ORA$AT_OS_OPT%';

JOB_NAME                ACTUAL_START_DATE                    RUN_DURATION        STATUS
---------------------   ----------------------------------   ----------------    ------------
 ORA$AT_OS_OPT_SY_1      25-MAY-20 10.00.02.042065 PM PRC     +000 00:01:24       SUCCEEDED
 ORA$AT_OS_OPT_SY_21     30-MAY-20 09.25.57.005710 AM PRC     +000 00:00:37       SUCCEEDED
 ORA$AT_OS_OPT_SY_41     30-MAY-20 01.26.30.842460 PM PRC     +000 00:00:43       SUCCEEDED
 ORA$AT_OS_OPT_SY_61     30-MAY-20 05.26.41.292037 PM PRC     +000 00:00:31       SUCCEEDED

總結:Oracle 11g自動統計信息收集是通過每天執行自動任務gather_stats_prog來實現的,它每天會自動生成ORA$AT_OS_OPT_xxx的作業,然後執行作業來收集統計信息,其本質也是執行了DBMS_STATS.GATHER_DATABASE_STATS_JOB_PROC存儲過程。


(二)統計信息收集策略
每次自動收集統計信息,並不是對所有表都進行收集,Oracle只對那些已經統計信息失效的對象進行收集,那麼Oracle如何判斷哪些對象的統計信息失效了呢?
在Oracle 11g中,如果參數STATISTICS_LEVEL的值為TYPICAL(默認)或者ALL,則DBA_TAB_MODIFICATIONS會記錄自上次自動統計信息收集完成之後對目標表的insert、update、delete的操作影響行數,並且還會記錄自從上次自動收集統計信息之後是否發生過truncate。需要注意的是DBA_TAB_MODIFICATIONS並不會實時更新,如果需要查看最新信息,可以手動更新該表的信息:

EXEC dbms_stats.flush_database_monitoring_info();

Oracle收集失效的統計信息的策略:自上次自動統計信息收集作業完成之後,如果DBA_TAB_MODIFICATIONS中記錄的INSERT+UPDATE+DELETE所影響的行記錄之和超過了DBA_TABLES中目標表記錄數的10%,或者是自上次統計信息收集完成之後目標表執行過truncate操作,那麼Oracle會認為目標表的統計信息已經失效,自動統計信息收集作業就會對目標表重新收集統計信息。


(三)禁用/啟用自動統計信息收集

在某些情況下,需要禁用自動統計信息的收集,可以使用以下3種方法,每種方法禁用範圍不同。

(3.1)使用以下方法可以禁用/啟用自動統計信息收集

SQL> EXEC dbms_auto_task_admin.disable(client_name=> 'auto optimizer stats collection',operation=> NULL,window_name=> NULL);

確認是否已經關閉:

SELECT WINDOW_NAME,AUTOTASK_STATUS,OPTIMIZER_STATS,SEGMENT_ADVISOR,SQL_TUNE_ADVISOR FROM DBA_AUTOTASK_WINDOW_CLIENTS


如果要啟用,可以使用如下方法重新打開自動統計信息收集:

SQL> EXEC dbms_auto_task_admin.enable(client_name=> 'auto optimizer stats collection',operation=> NULL,window_name=> NULL);

再次查詢,確認已經開啟:


※別再煩惱如何寫文案,掌握八大原則!

什麼是銷售文案服務?A就是幫你撰寫適合的廣告文案。當您需要販售商品、宣傳活動、建立個人品牌,撰寫廣告文案都是必須的工作。

(3.2)使用DBMS_SCHEDULER.DISABLE可以禁用維護窗口,從而禁用統計信息收集
例子1:禁掉周一的自動維護作業,包括統計信息收集、段顧問、sql調優顧問

EXEC dbms_scheduler.disable(NAME=> 'SYS.MONDAY_WINDOW',FORCE=> TRUE)

結果如下:

SELECT a.WINDOW_NAME,a.enabled FROM dba_scheduler_windows a where a.window_name = 'MONDAY_WINDOW';

啟用周一的自動維護作業,包括統計信息收集、段顧問、sql調優顧問

EXEC dbms_scheduler.enable(NAME=>'SYS.MONDAY_WINDOW');

(3.3)使用DBMS_SCHEDULER.DISABLE可以禁用維護窗口中的統計信息收集
例子2:禁掉周二的自動統計信息收集,段顧問、sql調優顧問保持開啟

EXEC dbms_auto_task_admin.disable(client_name=>'auto optimizer stats collection',operation=>NULL,window_name=>'TUESDAY_WINDOW');

查詢結果如下:

SELECT WINDOW_NAME,AUTOTASK_STATUS,OPTIMIZER_STATS,SEGMENT_ADVISOR,SQL_TUNE_ADVISOR FROM DBA_AUTOTASK_WINDOW_CLIENTS ;

再次開啟:

EXEC dbms_auto_task_admin.enable(client_name=>'auto optimizer stats collection',operation=>NULL,window_name=>'TUESDAY_WINDOW');

(四)調整自動統計信息收集
默認的統計信息如下,從周一到周五,窗口運行時間為晚上22點開始,最多運行4個小時,周六周日從早上6點開始,最多運行20個小時。

我們可以對其進行修改,修改的方法如下:
1.先禁用窗口:DBMS_SCHEDULER.DISABLE()
2.修改窗口的屬性:DBMS_SCHEDULER.SET_ATTRIBUTE()
3.啟用窗口:DBMS_SCHEDULER.ENABLE()

例子1:將周二的起始執行時間調整到23點

-- 1.禁用窗口
EXEC dbms_scheduler.disable(NAME=> 'SYS.MONDAY_WINDOW',FORCE=> TRUE)

-- 2.修改啟動時間為23點
EXEC dbms_scheduler.set_attribute(name => 'SYS.MONDAY_WINDOW',attribute => 'REPEAT_INTERVAL',value => 'freq=daily;byday=TUE;byhour=23;byminute=0; bysecond=0');

-- 3.啟用窗口
EXEC dbms_scheduler.enable(NAME=>'SYS.MONDAY_WINDOW');

查看結果:


(五)列的直方圖統計信息收集方式修改
在Oracle 11g中,Oracle默認直方圖的統計信息收集方式是AUTO,即Oracle會根據負載以及列的使用情況來確定對哪些列收集直方圖信息,為了更好地利用直方圖統計信息的同時保持執行計劃的穩定,推薦對直方圖統計信息的收集策略是對已經存在直方圖的列才收集直方圖統計信息,即以REPEAT方式收集。
查看默認的直方圖收集策略:

SQL> SELECT dbms_stats.get_prefs('METHOD_OPT') FROM dual;

DBMS_STATS.GET_PREFS('METHOD_O
--------------------------------------------------------------------------------
 FOR ALL COLUMNS SIZE AUTO

修改直方圖策略:

SQL> EXEC dbms_stats.set_global_prefs(pname => 'METHOD_OPT',pvalue => 'FOR ALL COLUMNS SIZE REPEAT');
 PL/SQL procedure successfully completed

查看修改后的默認的直方圖收集策略:

SQL> SELECT dbms_stats.get_prefs('METHOD_OPT') FROM dual;

DBMS_STATS.GET_PREFS('METHOD_O
--------------------------------------------------------------------------------
 FOR ALL COLUMNS SIZE REPEAT

(六)統計信息閾值修改
在Oracle 11g中,默認統計信息的收集閾值為10%,即10%的行數據發生變化或者執行了truncate,才會再次收集統計信息。我們可以使用下面的方法針對單個表修改閾值。

例子1:修改test01表的統計信息收集閾值為5%。

查看初始的閾值:

SQL> SELECT dbms_stats.get_prefs(pname => 'STALE_PERCENT',ownname => 'LIJIAMAN',tabname => 'TEST01') FROM dual;

DBMS_STATS.GET_PREFS(PNAME=>'S
 --------------------------------------------------------------------------------
 10

修改閾值為5:

SQL> EXEC dbms_stats.set_table_prefs(ownname => 'LIJIAMAN',tabname => 'TEST01',pname   => 'STALE_PERCENT',pvalue  => 5);
 PL/SQL procedure successfully completed

確認修改后的閾值:

SQL> SELECT dbms_stats.get_prefs(pname => 'STALE_PERCENT',ownname => 'LIJIAMAN',tabname => 'TEST01') FROM dual;

DBMS_STATS.GET_PREFS(PNAME=>'S
--------------------------------------------------------------------------------
5

需要注意的是:當閾值為0時,不管數據如何變化,每天都會自動收集統計信息。

【完】

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

擁有後台管理系統的網站,將擁有強大的資料管理與更新功能,幫助您隨時新增網站的內容並節省網站開發的成本。

一篇文章帶你吃透 Docker 原理_網頁設計公司

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

當全世界的人們隨著網路時代而改變向上時您還停留在『網站美醜不重要』的舊有思維嗎?機會是留給努力改變現況的人們,別再浪費一分一秒可以接觸商機的寶貴時間!

容器的實現原理

從本質上,容器其實就是一種沙盒技術。就好像把應用隔離在一個盒子內,使其運行。因為有了盒子邊界的存在,應用於應用之間不會相互干擾。並且像集裝箱一樣,拿來就走,隨處運行。其實這就是 PaaS 的理想狀態。

實現容器的核心,就是要生成限制應用運行時的邊界。我們知道,編譯后的可執行代碼加上數據,叫做程序。而把程序運行起來后,就變成了進程,也就是所謂的應用。如果能在應用啟動時,給其加上一個邊界,這樣不就能實現期待的沙盒嗎?

在 Linux 中,實現容器的邊界,主要有兩種技術 Cgroups 和 Namespace. Cgroups 用於對運行的容器進行資源的限制,Namespace 則會將容器隔離起來,實現邊界。

這樣看來,容器只是一種被限制的了特殊進程而已。

容器的隔離:Namespace

在介紹 Namespace 前,先看一個實驗:

# 使用 python3.6.8 的官方鏡像,建立了一個運行 django 的環境
# 進入該容器后,使用 ps 命令,查看運行的進程
root@8729260f784a:/src# ps -A
  PID TTY          TIME CMD
    1 ?        00:01:22 gunicorn
   22 ?        00:01:20 gunicorn
   23 ?        00:01:24 gunicorn
   25 ?        00:01:30 gunicorn
   27 ?        00:01:16 gunicorn
   41 pts/0    00:00:00 bash
   55 pts/0    00:00:00 ps

可以看到,容器內 PID =1 的進程,是 gunicorn 啟動的 django 應用。熟悉 Linux 的同學都知道,PID =1 的進程是系統啟動時的第一個進程,也稱 init 進程。其他的進程,都是由它管理產生的。而此時,PID=1 確實是 django 進程。

接着,退出容器,在宿主機執行 ps 命令

# 環境為 Centos7
[root@localhost ~]# ps -ef | grep gunicorn
root      9623  8409  0 21:29 pts/0    00:00:00 grep --color=auto gunicorn
root     30828 30804  0 May28 ?        00:01:22 /usr/local/bin/python /usr/local/bin/gunicorn -c gunicorn_config.py ctg.wsgi
root     31171 30828  0 May28 ?        00:01:20 /usr/local/bin/python /usr/local/bin/gunicorn -c gunicorn_config.py ctg.wsgi
root     31172 30828  0 May28 ?        00:01:24 /usr/local/bin/python /usr/local/bin/gunicorn -c gunicorn_config.py ctg.wsgi
root     31174 30828  0 May28 ?        00:01:30 /usr/local/bin/python /usr/local/bin/gunicorn -c gunicorn_config.py ctg.wsgi
root     31176 30828  0 May28 ?        00:01:16 /usr/local/bin/python /usr/local/bin/gunicorn -c gunicorn_config.py ctg.wsgi

如果以宿主機的視角,發現 django 進程 PID 變成了 30828. 這也就不難證明,在容器中,確實做了一些處理。把明明是 30828 的進程,變成了容器內的第一號進程,同時在容器還看不到宿主機的其他進程。這也說明容器內的環境確實是被隔離了。

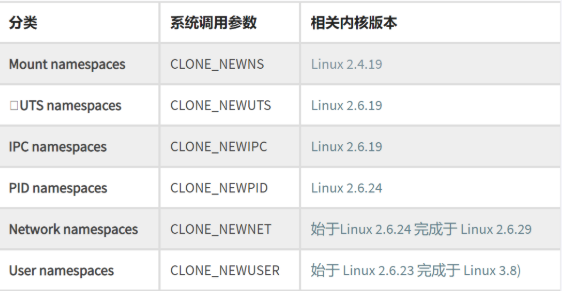
這種處理,其實就是 Linux 的 Namespace 機制。比如,上述將 PID 變成 1 的方法就是通過PID Namespace。在 Linux 中創建線程的方法是 clone, 在其中指定 CLONE_NEWPID 參數,這樣新創建的進程,就會看到一個全新的進程空間。而此時這個新的進程,也就變成了 PID=1 的進程。

int pid = clone(main_function, stack_size, CLONE_NEWPID | SIGCHLD, NULL); 

在 Linux 類似於 PID Namespace 的參數還有很多,比如:

容器的限制:Cgroups

通過 Namespace 技術,我們實現了容器和容器間,容器與宿主機之間的隔離。但這還不夠,想象這樣一種場景,宿主機上運行着兩個容器。雖然在容器間相互隔離,但以宿主機的視角來看的話,其實兩個容器就是兩個特殊的進程,而進程之間自然存在着競爭關係,自然就可以將系統的資源吃光。當然,我們不能允許這麼做的。

Cgroups 就是 Linux 內核中用來為進程設置資源的一個技術。

Linux Cgroups 全稱是 Linux Control Group,主要的作用就是限制進程組使用的資源上限,包括 CPU,內存,磁盤,網絡帶寬。

還可以對進程進行優先級設置,審計,掛起和恢復等操作。

在之前的版本中,可通過 libcgroup tools 來管理 cgroup, 在 RedHat7 后,已經改為通過 systemctl 來管理。

我們知道,systemd 在 Linux 中的功能就是管理系統的資源。而為了管理的方便,衍生出了一個叫 Unit 的概念,比如一個 unit 可以有比較寬泛的定義,比如可以表示抽象的服務,網絡的資源,設備,掛載的文件系統等。為了更好的區分,Linux 將 Unit 的類型主要分為 12 種。

類型 作用
.automount 用於自動掛載配置的掛載點
.swap 描述系統的交換區,反映了設備或文件的路徑
.target 在系統啟動或者改變狀態時,為其他 unit 提供同步點
.path 定義的文件路徑,用於激活。
.service 一個服務或者一個應用,具體定義在配置文件中。
.socket 一個網絡或者 IPC socket,FIFO buffer.
.device 描述一個需要被 systemd udev 或 sysfs 文件系統管理的設備
.mount 定義的掛載點
.timer 定時器
.snapshot 被 systemctl snapshot 命令自動創建的單元
.slice 用於關聯 Linux Control Group 節點,根據關聯的 slice 來限制進程。一個管理單元的組。Slice 並不包含任何進程,僅僅管理由 service 和 scope 組成的層級結構。
.scope systemd 從 bus 接口收到消息后自動創建。Scope 封裝了任意進程通過 fork() 函數開啟或停止的進程,並且在 systemd 運行時註冊。例如:用戶 sessions,容器和虛擬機。

在 Cgroup 中,主要使用的是 slice, scope and service 這三種類型。

如創建一個臨時 cgroup, 然後對其啟動的進程進行資源限制:

 # 創建一個叫 toptest 的服務,在名為 test 的 slice 中運行
[root@localhost ~]# systemd-run --unit=toptest --slice=test top -b
Running as unit toptest.service.

現在 toptest 的服務已經運行在後台了

# 通過 systemd-cgls 來查看 Cgroup 的信息
[root@localhost ~]#  systemd-cgls
├─1 /usr/lib/systemd/systemd --switched-root --system --deserialize 22
├─test.slice
│ └─toptest.service
│   └─6490 /usr/bin/top -b

# 通過 systemctl status 查看服務的狀態
[root@localhost ~]# systemctl status toptest
● toptest.service - /usr/bin/top -b
   Loaded: loaded (/run/systemd/system/toptest.service; static; vendor preset: disabled)
  Drop-In: /run/systemd/system/toptest.service.d
           └─50-Description.conf, 50-ExecStart.conf, 50-Slice.conf
   Active: active (running) since Tue 2020-06-02 14:01:01 CST; 3min 50s ago
 Main PID: 6490 (top)
   CGroup: /test.slice/toptest.service
           └─6490 /usr/bin/top -b

現在對運行的 toptest 服務進行資源的限制。

# 先看下,沒有被限制前的 Cgroup 的信息, 6490 為進程 PID
[root@localhost ~]# cat /proc/6490/cgroup
11:pids:/test.slice
10:blkio:/test.slice
9:hugetlb:/
8:cpuset:/
7:memory:/test.slice
6:devices:/test.slice
5:net_prio,net_cls:/
4:perf_event:/
3:freezer:/
2:cpuacct,cpu:/test.slice
1:name=systemd:/test.slice/toptest.service

# 對其使用的 CPU 和 內存進行限制
systemctl set-property toptest.service CPUShares=600 MemoryLimit=500M

# 再次查看 Cgroup 的信息,發現在 cpu 和 memory 追加了一些內容。
[root@localhost ~]# cat /proc/6490/cgroup
11:pids:/test.slice
10:blkio:/test.slice
9:hugetlb:/
8:cpuset:/
7:memory:/test.slice/toptest.service
6:devices:/test.slice
5:net_prio,net_cls:/
4:perf_event:/
3:freezer:/
2:cpuacct,cpu:/test.slice/toptest.service
1:name=systemd:/test.slice/toptest.service

這時可以在 /sys/fs/cgroup/memory/test.slice 和 /sys/fs/cgroup/cpu/test.slice 目錄下,多出了一個叫 toptest.service 的目錄。

在其目錄下 cat toptest.service/cpu.shares 可以發現,裏面的 CPU 被限制了 600.

回到 Docker,其實 docker 和我們上面做的操作基本一致,具體需要限制哪些資源就是在 docker run 里指定:

$ docker run -it --cpu-period=100000 --cpu-quota=20000 ubuntu /bin/bash

關於 docker 具體的限制,可以在 sys/fs/cgroup/cpu/docekr/ 等文件夾來查看。

容器的文件系統:容器鏡像 – rootfs

現在我們知道,容器技術的核心就是通過 Namespace 限制了容器看到的視野,通過 Cgroup限制了容器可訪問的資源。 但關於 Mount Namespace 還有一些特殊的地方,需要着重關注下。

Mount Namespace 特殊之處在於,除了在修改時需要進程對文件系統掛載點的認證,還需要顯式聲明需要掛載那些目錄。在 Linux 系統中,有一個叫 chroot 的命令,可以改變進程的根目錄到指定的位置。而 Mount Namespace 正是基於 chroot 的基礎上發展出來的。

在容器內,應該看到完全獨立的文件系統,而且不會受到宿主機以及其他容器的影響。這個獨立的文件系統,就叫做容器鏡像。它還有一個更專業的名字叫 rootfs. rootfs 中包含了一個操作系統所需要的文件,配置和目錄,但並不包含系統內核。 因為在 Linux 中,文件和內核是分開存放的,操作系統只有在開啟啟動時才會加載指定的內核。這也就意味着,所有的容器都會共享宿主機上操作系統的內核。

在 PaaS 時代,由於雲端和本地的環境不同,應用打包的過程,一直是比較痛苦的過程。但有了 rootfs ,這個問題就被很好的解決了。因為在鏡像內,打包的不僅僅是應用,還有所需要的依賴,都被封裝在一起。這就解決了無論是在哪,應用都可以很好的運行的原因。

不光這樣,rootfs 還解決了可重用性的問題,想象這個場景,你通過 rootfs 打包了一個包含 java 環境的 centos 鏡像,別人需要在容器內跑一個 apache 的服務,那麼他是否需要從頭開始搭建 java 環境呢?docker 在解決這個問題時,引入了一個叫層的概念,每次針對 rootfs 的修改,都只保存增量的內容,而不是 fork 一個新鏡像。

層級的想法,同樣來自於 Linux,一個叫 union file system (聯合文件系統)。它最主要的功能就是將不同位置的目錄聯合掛載到同一個目錄下。對應在 Docker 裏面,不同的環境則使用了不同的聯合文件系統。比如 centos7 下最新的版本使用的是 overlay2,而 Ubuntu 16.04 和 Docker CE 18.05 使用的是 AuFS.

可以通過 docker info 來查詢使用的存儲驅動,我這裏的是 overlay2。

[root@localhost ~]# docker info
Client:
 Debug Mode: false

Server:
 Containers: 4
  Running: 4
  Paused: 0
  Stopped: 0
 Images: 4
 Server Version: 19.03.8
 Storage Driver: overlay2

接着我們來了解下,Overlay2 的文件系統在 docker 中是如何使用的?

Overlay2

在 Linux 的主機上,OverlayFS 一般有兩個目錄,但在显示時具體會显示為一個目錄。這兩個目錄被稱為層,聯合在一起的過程稱為 union mount. 在其下層的目錄稱為 lowerdir, 上層的目錄稱為 upperdir. 兩者聯合后,暴露出來的視圖稱為 view. 聽起來有點抽象,先看下整體結構:

可以看到,lowerdir 其實對應的就是鏡像層,upperdir 對應的就是容器器。而 merged 對應的就是兩者聯合掛載之後的內容。而且我們發現,當鏡像層和容器層擁有相同的文件時,會以容器層的文件為準(最上層的文件為準)。通常來說,overlay2 支持最多 128 lower 層。

下面實際看下容器層和鏡像具體的體現,我這台 linux 主機上,運行着 4 個 container。

Docker 一般的存儲位置在 /var/lib/docker,先看下裏面的結構:

[root@localhost docker]# ls -l /var/lib/docker
total 16
drwx------.  2 root root   24 Mar  4 03:39 builder
drwx--x--x.  4 root root   92 Mar  4 03:39 buildkit
drwx------.  7 root root 4096 Jun  1 10:36 containers
drwx------.  3 root root   22 Mar  4 03:39 image
drwxr-x---.  3 root root   19 Mar  4 03:39 network
drwx------. 69 root root 8192 Jun  1 15:01 overlay2
drwx------.  4 root root   32 Mar  4 03:39 plugins
drwx------.  2 root root    6 Jun  1 15:00 runtimes
drwx------.  2 root root    6 Mar  4 03:39 swarm
drwx------.  2 root root    6 Jun  1 15:01 tmp
drwx------.  2 root root    6 Mar  4 03:39 trust
drwx------.  3 root root   45 May 18 10:28 volumes

需要着重關注的是 container, image, overlay2 這幾個文件夾。

  • container:這個不用多說,正在運行或創建的容器會在這個目錄下。
  • image:對應記錄的就是鏡像。
  • overlay2:記錄的是每個鏡像下包含的 lowerrdir.

之前提到,unionfs 的實現可能有多種,比如 overlay2,aufs,devicemapper 等。那麼自然在 image 文件夾下,就會存在多種驅動的文件夾,:

image/
└── overlay2
    ├── distribution
    ├── imagedb
    │   ├── content
    │   └── metadata
    ├── layerdb
    │   ├── mounts
    │   ├── sha256
    │   └── tmp
    └── repositories.json

這裏的 imagedb 和 layerdb, 就是存儲元數據的地方。之前我們了解到,容器的文件系統構成就是通過 image 層 和 container 層聯合構成的,而每個 image 可能是由多個層構成。這就意味着,每個層可能會被多個 image 引用。那麼之間是如何關聯的呢?答案就在 imagedb 這個文件下。

這裏我以 mysql 鏡像為例:

※想知道最厲害的網頁設計公司嚨底家"!

RWD(響應式網頁設計)是透過瀏覽器的解析度來判斷要給使用者看到的樣貌

# 查看 mysql 的鏡像 id
[root@localhost docker]# docker image ls
REPOSITORY          TAG                 IMAGE ID            CREATED             SIZE
ctg/mysql           5.7.29              84164b03fa2e        3 months ago        456MB

# 進入到 imagedb/content/sha256 目錄, 可以找到對應的鏡像 id
[root@localhost docker]# ls -l image/overlay2/imagedb/content/sha256/
...
-rw-------. 1 root root  6995 Apr 27 02:45 84164b03fa2ecb33e8b4c1f2636ec3286e90786819faa4d1c103ae147824196a

# 接着看下裏面記錄的內容, 這裏截取有用的部分
cat  image/overlay2/imagedb/content/sha256/84164b03fa2ecb33e8b4c1f2636ec3286e90786819faa4d1c103ae147824196a
{
.........
  "os": "linux",
  "rootfs": {
    "type": "layers",
    "diff_ids": [
      "sha256:f2cb0ecef392f2a630fa1205b874ab2e2aedf96de04d0b8838e4e728e28142da",
      "sha256:a9f6b7c7101b86ffaa53dc29638e577dabf5b24150577a59199d8554d7ce2921",
      "sha256:0c615b40cc37ed667e9cbaf33b726fe986d23e5b2588b7acbd9288c92b8716b6",
      "sha256:ad160f341db9317284bba805a3fe9112d868b272041933552df5ea14647ec54a",
      "sha256:1ea6ef84dc3af6506c26753e9e2cf7c0d6c1c743102b85ebd3ee5e357d7e9bc4",
      "sha256:6fce4d95d4af3777f3e3452e5d17612b7396a36bf0cb588ba2ae1b71d139bab9",
      "sha256:6de3946ea0137e75dcc43a3a081d10dda2fec0d065627a03800a99e4abe2ede4",
      "sha256:a35a4bacba4d5402b85ee6e898b95cc71462bc071078941cbe8c77a6ce2fca62",
      "sha256:1ff9500bdff4455fa89a808685622b64790c321da101d27c17b710f7be2e0e7e",
      "sha256:1cf663d0cb7a52a3a33a7c84ff5290b80966921ee8d3cb11592da332b4a9e016",
      "sha256:bcb387cbc5bcbc8b5c33fbfadbce4287522719db43d3e3a286da74492b7d6eca"
    ]
  }
}

可以看到 mysql 鏡像由 11 層組成,其中 f2cb 是最低層,bcb3 是最上層。

接着,我們看下 layerdb 的內容:

[root@localhost docker]# ls -l  image/overlay2/layerdb/
total 8
drwxr-xr-x.  6 root root 4096 May 13 13:38 mounts
drwxr-xr-x. 39 root root 4096 Apr 27 02:51 sha256
drwxr-xr-x.  2 root root    6 Apr 27 02:51 tmp

# 首先看下 sha256 目錄下的內容
[root@localhost docker]# ls -l  image/overlay2/layerdb/sha256/
total 0
....
drwx------. 2 root root 71 Apr 27 02:45 bbb9cccab59a16cb6da78f8879e9d07a19e3a8d49010ab9c98a2c348fa116c87
drwx------. 2 root root 71 Apr 27 02:45 f2cb0ecef392f2a630fa1205b874ab2e2aedf96de04d0b8838e4e728e28142da
....

可以發現,在這裏僅能找到最底層的層 ID,原因在於層之間的關聯是通過 chainID 的方式保存的,簡單來說就是通過 sha256 算法后能計算出一層的容器 id.

比如這裏,最底層 id 是 f2cb0ecef392f2a630fa1205b874ab2e2aedf96de04d0b8838e4e728e28142da , 上一層 id 是 a9f6b7c7101b86ffaa53dc29638e577dabf5b24150577a59199d8554d7ce2921, 那麼對應在 sha256 目錄下的下一層 id 的計算方法就是:

[root@localhost docker]# echo -n "sha256:f2cb0ecef392f2a630fa1205b874ab2e2aedf96de04d0b8838e4e728e28142da sha256:a9f6b7c7101b86ffaa53dc29638e577dabf5b24150577a59199d8554d7ce2921" | sha256sum
bbb9cccab59a16cb6da78f8879e9d07a19e3a8d49010ab9c98a2c348fa116c87  -

接着我們可以在 sha256 目錄下,找到 bbb9.. 這層的內容。

OK,現在我們已經把鏡像和層關聯起來,但之前說過,image 目錄下存的都是元數據。真實的 rootfs 其實在另一個地方 – /docker/overlay2 下。

# 通過查詢 cache-id,得到就是真實的 rootfs 層
[root@localhost docker]# cat  image/overlay2/layerdb/sha256/f2cb0ecef392f2a630fa1205b874ab2e2aedf96de04d0b8838e4e728e28142da/cache-id
2996b24990e75cbd304093139e665a45d96df8d7e49334527827dcff820dbf16[

進入到 /docker/overlay2 下查看:

[root@localhost docker]# ls -l overlay2/
total 4
...
drwx------. 3 root root   47 Apr 27 02:45 2996b24990e75cbd304093139e665a45d96df8d7e49334527827dcff820dbf16
...
drwx------. 2 root root 4096 May 13 13:38 l

這樣真實的 rootfs 層也被找到了。

這裏重新梳理下,我們先是在 mage/overlay2/imagedb/content/sha256/ ,根據 image id 查看該 image 具有所有的層ID,然後根據最底層ID和上層ID通過 sha256 計算得到,引用的上一層 ID, 依次類推,關聯所有的層。最後通過每一層的 cache-id,將元數據和真實的 rootfs 層數據對應起來了。

最後總結一下,rootfs 的構成。

每個 rootfs 由鏡像層(lowerdir)和 容器層(upperdir)構成,其中鏡像層只能只讀,而容器層則能讀寫。而且鏡像層可有最多128層構成。

其實,rootfs 構成還有另外一層,但由於在進行提交或編譯時,不會把這層加進去,所以就沒把這層算在rootfs裏面,但實際上存在的。

在之前我們查看 ls -l /var/lib/docker/overlay2/ 下鏡像層,會看到好幾個以 -init 結尾的目錄,而且數量恰好等於容器的數量。這層夾在鏡像層之上,容器層之下。是由 docker 內部單獨生成的一層,專門用於存放 etc/hosts、/etc/resolv.conf 等配置信息。存在的目的,是由於用戶在容器啟動時,需要配置一些特定的值,比如 hostname,dns 等,但這些配置僅對當前容器有效,放到其他環境下自然有別的配置,所以這層被單獨拿出來,在提交鏡像時,忽略這一層。

容器與虛擬機技術的對比

下面這張圖是 docker 官方中,截取下來的,基於上面我們學習的內容,重新分析下 docker 和 傳統 VM 的區別:

遷移性和性能:

  • 傳統 VM: 需要基於 Hypervisor 的硬件虛擬化技術,模擬出 CPU,內存等硬件。然後在其上搭建一套完整的操作系統,自然在性能上會有很大的損失。遷移自然更不用說,傳統的 ova 導出后就是一個完整的操作系統。
  • Docker:Docker 將 Hypervisor 的位置換成自己的 Docekr Engine. 然後運行的容器僅僅是一個特殊的進程,自然性能不會有太大的損失。並且可以應用和其所需要的系統文件打包成鏡像,無論在哪讀可以正常運行,而且相對於 ova 來說體積也小了更多。(需要內核支持)

一般來說,運行着 CentOS 的 KVM,啟動后,在不做優化的前提下,需要佔用 100~200 M 內存。在加上用戶對宿主機的調用,需要通過虛擬化軟件攔截和處理,又是一層性能損耗,特別是對計算資源,網絡和磁盤I/O等。

隔離性:

  • 傳統 VM:由於是虛擬化出一套完整的操作系統,所以隔離性非常好。比如微軟的 Azure 平台,就是在 Windows 服務器上,虛擬出大量的 Linux 虛擬機。

  • Docker:在隔離性上相差就很多了,因為本身上容器就是一種進程,而所有的進程都需要共享一個系統內核。

    • 這就意味着,在 Windows 上運行 Linux 容器,或者 Linux 宿主機運行高版本內核的容器就無法實現。

    • 在 Linux 內核中,有許多資源和對象不能 Namespace 化,如時間,比如通過 settimeofday(2) 系統調用 修改時間,整個宿主機的實際都會被修改。

    • 安全的問題,共享宿主機內核的事實,容器暴露出的攻擊面更大。

資源的限制:

  • 傳統 VM:非常便於管理,控制資源的使用,依賴於虛擬的操作系統。
  • Docker:由於 docker 內資源的限制通過 Cgroup 實現,而 Cgroup 有很多不完善的地方,比如
    • 對 /proc 的處理問題。進入容器后,執行 top 命令,看到的信息和宿主機是一樣的,而不是配置后的容器的數據。(可以通過 lxcfs 修正)。
    • 在運行 java 程序時,給容器內設置的內存為 4g,使用默認的 jvm 配置。而默認的 jvm 讀取的內存是宿主機(可能大於 4g),這樣就會出現 OOM 的情況。

解決的問題

  1. 容器是如何進行隔離的?

    在創建新進程時,通過 Namespace 技術,如 PID namespaces 等,實現隔離性。讓運行后的容器僅能看到本身的內容。

    比如,在容器運行時,會默認加上 PID, UTS, network, user, mount, IPC, cgroup 等 Namespace.

  2. 容器是如何進行資源限制的?

    通過 Linux Cgroup 技術,可為每個進程設定限制的 CPU,Memory 等資源,進而設置進程訪問資源的上限。

  3. 簡述下 docker 的文件系統?

    docker 的文件系統稱為 rootfs,它的實現的想法來自與 Linux unionFS 。將不同的目錄,掛載到一起,形成一個獨立的視圖。並且 docker 在此基礎上引入了層的概念,解決了可重用性的問題。

    在具體實現上,rootfs 的存儲區分根據 linux 內核和 docker 本身的版本,分為 overlay2 , overlay, aufs, devicemapper 等。rootfs(鏡像)其實就是多個層的疊加,當多層存在相同的文件時,上層的文件會將下層的文件覆蓋掉。

  4. 容器的啟動過程?

    1. 指定 Linux Namespace 配置
    2. 設置指定的 Cgroups 參數
    3. 切換進程的根目錄
  5. 容器內運行多個應用的問題?

    首先更正一個概念,我們都說容器是一個單進程的應用,其實這裏的單進程不是指在容器中只允許着一個進程,而是指只有一個進程時可控的。在容器內當然可以使用 ping,ssh 等進程,但這些進程時不受 docker 控制的。

    容器內的主進程,也就是 pid =1 的進程,一般是通過 DockerFile 中 ENTRYPOINT 或者 CMD 指定的。如果在一個容器內如果存在着多個服務(進程),就可能出現主進程正常運行,但是子進程退出掛掉的問題,而對於 docker 來說,僅僅控制主進程,無法對這種意外的情況作出處理,也就會出現,容器明明正常運行,但是服務已經掛掉的情況,這時編排系統就變得非常困難。而且多個服務,在也不容易進行排障和管理。

    所以如果真的想要在容器內運行多個服務,一般會通過帶有 systemd 或者 supervisord 這類工具進行管理,或者通過 --init 方法。其實這些方法的本質就是讓多個服務的進程擁有同一個父進程。

    但考慮到容器本身的設計,就是希望容器和服務能夠同生命周期。所以這樣做,有點背道而馳的意味。

    控制(回收和生命周期的管理)

參考

Cgroup 介紹

Overlay2介紹

docker 官網

在一個容器內搭建多個服務

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

透過資料庫的網站架設建置,建立公司的形象或購物系統,並提供最人性化的使用介面,讓使用者能即時接收到相關的資訊

Redis高可用-主從,哨兵,集群_網頁設計

※網頁設計最專業,超強功能平台可客製化

窩窩以「數位行銷」「品牌經營」「網站與應用程式」「印刷品設計」等四大主軸,為每一位客戶客製建立行銷脈絡及洞燭市場先機。

主從複製

Master-Slave主從概念

同時運行多個redis服務端,其中一個作為主(master),其他的一個或多個作為從(slave),主從之間通過網絡進行通訊,slave通過複製master的數據來保持與master的數據同步,實現數據冗餘;

在Redis中,配置主從複製非常簡單,Redis允許slave實例對master進行完整拷貝,在連接斷開時,slave會自動重新連接至主實例,並盡可能與master保持同步;

三個主要機制:

  • 當連接可用時,master將發送命令流到slave來使salve保持更新,以下操作將引發該操作,對msater數據的寫入操作(包括刪除更新),key過期;
  • master和slave節點都會進行超時檢測,當連接不穩定時,slave將儘快重新連接並進行部分重新同步,即不需要完全重新同步;
  • 若無法進行部分重新同步,則slave將發起完全重新同步,master會將最新的數據快照發送給slave,後續的操作仍然是發送命令流;

其他特性:

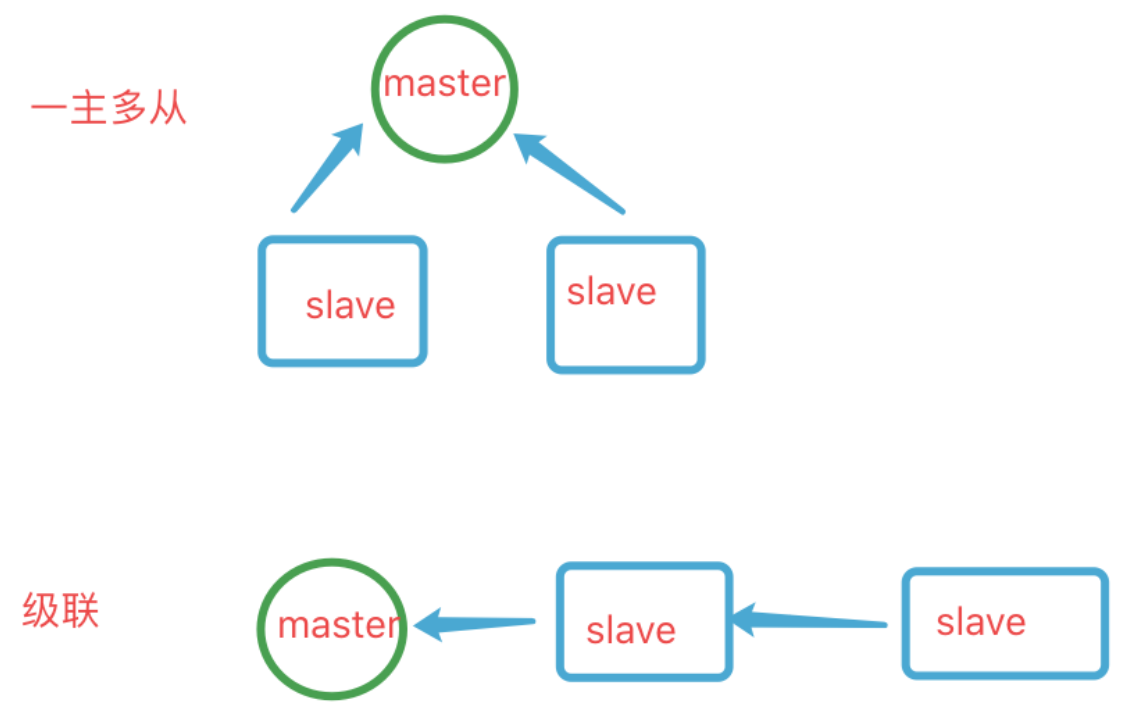
主從之間,採用異步複製,複製過程中依然可以正常響應客戶端操作,支持一主多從,且從節點還可以類似的級聯其他從節點,如圖所示:

主從複製的作用:

  • 使用主從複製,能夠避免Redis的單點故障,實現數據防災備份;
  • 可配置主節點執行寫入,多個從節點分擔查詢,實現讀寫分離獲得更好的性能

注意:使用主從來做讀寫分離時,意味主節點自身沒有任何持久化數據;如果配置了哨兵,一旦節點重啟,則將使用空數據進行同步,導致從節點覆蓋所有持久化數據,這是非常危險的,牆裂建議在主節點和從節點上開啟持久化,如果一定要關閉,則必須配置主節點禁止哨兵自動重啟故障節點;具體故障模式:連接

配置:

#配置文件中按以下方式添加主節點的ip 和端口即可
replicaof 192.168.1.1 6379
#若主節點配置了授權密碼則需要指定密碼
masterauth 密碼
#主節點通過以下方式設置授權密碼
requirepass 密碼
#客戶端連接后需要先驗證密碼
auth 密碼

#可通過以下指令查看當前連接的服務的主從信息
info replication

副本只讀:

默認情況下副本是只讀的,若需要可以通過配置replica-read-only為no來使副本變為可寫的,但是要強調的是副本寫入的數據,僅寫入到當前副本本地,不會同步至任何節點,包括當前副本的副本;當副本重啟后這寫數據將消失,即臨時數據;

哨兵

哨兵(Sentinel) 是為redis提供了高可用性(high available/HA),使用Sentinel部署Redis時,可實現在無需人工干預的情況下,自動完成固定類型的故障修復;是Redis盡可能處於正常工作狀態;

哨兵的主要功能:

  • 集群監控:監控redis各個節點是否正常工作;
  • 消息通知:當某個節點出現故障時,可通過API\通知系統管理員或是其他程序;
  • 故障轉移(failover):當master無法無法正常工作時,哨兵可以啟動故障轉移過程,該過程會將某一個slave節點提升為master節點,並主動通知使用redis服務器的應用程序要使用新的地址;
  • ​ 配置中心:當客戶端連接至哨兵時,可通過哨兵獲取可用的Redis服務信息;

哨兵的分佈式性質:

Sentinel本身是一個分佈式系統,即會有多個Sentinel進程通過網絡協同合作,具有以下優點:

  • 當多個哨兵就某一master不可用這一事實達成共識,才會進行故障轉移,降低了因網絡波動造成誤報的可能性;

  • 即使一些哨兵進程無法工作時,其他可用的哨兵仍然能夠正常工作,提供了整個系統應對故障的能力;

    反過來,如果只有單獨的一個哨兵進程實際上是沒有辦法提供高可用的;

啟動哨兵

哨兵的執行文件本質就是redis的服務端,只不過運行的模式不同了,另外運行哨兵必須提供配置文件,否則將拒絕啟動;

首先需要準備配置文件,在下載的源碼中找到sentinel.conf 為了後續方便修改可以將其複製到bin目錄下

指定master的地址和端口

sentinel monitor mymaster 127.0.0.1 6379 2

啟動哨兵的命令有兩種寫法:

#方式1
redis-sentinel sentinel.conf
#方式1
redis-server sentinel.conf --sentinel

若啟動哨兵成功可以在控制台中看到其輸出的master節點信息;

默認情況下哨兵監聽在26379端口上,若開啟了防火牆則需要開放該端口,否則哨兵無法正常工作;

完成故障切換的過程

故障切換的定義:

​ 當master不可用時將一個可用的slave提升稱為master,使結點保持正常訪問;

基於網絡存在不穩定性這個特性,一些時候某個哨兵進程可能無法與master正常通訊,但是這並不意味這master真的不可用了,哨兵無法就此認定master不可用這一事實,哨兵需要能夠檢測master是否客觀的不可用了,並在master不可用成為客觀事實后開始執行故障切換;

  1. 每個Sentinel(哨兵)進程以每秒鐘一次的頻率向整個集群中的Master主服務器,Slave從服務器 以及其他Sentinel(哨兵)進程發送一個 PING 命令
  2. 如果一個實例(instance)距離最後一次有效回復 PING 命令的時間超過 down-after- milliseconds 選項所指定的值,則這個實例會被 Sentinel(哨兵)進程標記為主觀下線(sdown)
  3. 如果一個Master主服務器被標記為主觀下線(SDOWN),則正在監視這個Master主服務器的所有Sentinel(哨兵)進程要以每秒一次的頻率確認Master主服務器的確進入了主觀下線狀態。
  4. 當有足夠數量的 Sentinel(哨兵)進程(大於等於配置文件指定的值)在指定的時間範圍內確認Master主服務器進入了主觀下線狀態(SDOWN), 則Master主服務器會被標記為客觀下線(ODOWN)。
  5. 在一般情況下, 每個Sentinel(哨兵)進程會以每 10 秒一次的頻率向集群中的所有Master主服務器、Slave從服務器發送 INFO 命令。
  6. 當Master主服務器被 Sentinel(哨兵)進程標記為客觀下線(ODOWN)時,Sentinel(哨兵)進程向下線的 Master主服務器的所有 Slave從服務器發送 INFO 命令的頻率會從 10 秒一次改為每秒一次。
  7. 若沒有足夠數量的 Sentinel(哨兵)進程同意 Master主服務器下線, Master主服務器的客觀下線狀態就會被移除。若 Master主服務器重新向 Sentinel(哨兵)進程發送 PING 命令返回有效回 復,Master主服務器的主觀下線狀態就會被移除。

故障切換涉及到的事件和參數:

  • sdown:主觀下線,當某個哨兵與master之間在指定時間內無法正常通訊后該哨兵將產生sdown事件

  • quorum(仲裁數):是一個整數,表示master從主觀下線變為客觀下線所需要的哨兵數量(但有quorum個哨兵與master通訊失敗則master進入主觀下線)

  • odown:當sdown的事件的數量達到指定值(quorum)時,將產odown事件,表示master客觀下線了;

  • majority(大多數):是一個整數,該值通過計算自動得出,計算公式為floor(哨兵總數量/2)+1 floor為下取整

當odown產生時,會選出一個哨兵準備進行故障切換,在切換前該哨兵還需要獲得大多數(majority)哨兵的授權,授權成功則開始進行故障切換;

故障切換完成后,若先前宕機的節點(原來的master)恢復正常,則該節點會降為slave;

部署Sentinel的基本知識

  • 哨兵應與分佈式的形式存在,若哨兵僅部署一個則實際上沒有辦法提高可用性,當僅有的哨兵進程遇到問題退出后,則無法完成故障恢復;

  • 一個健壯的部署至少需要三個Sentinel實例

  • 三個哨兵應該部署在相互的獨立的計算機或虛擬機中;

  • Sentinel無法保證在執行故障轉移期間的寫入的數據是否能夠保留下來;

部署案例:

下例圖中名稱的釋義:
S:sentinel

M:master

R:replace(slave)

1.不要採用下例部署

上述部署中若M1(包括S1,因為在同一個機器上)宕機,剩下的S2雖然可以認定M1主觀下線,但是卻無法得到大多數哨兵的授權並開始故障切換,因為此時majority為2;

2.簡單且實用的部署

上述部署由三個節點組成,每個節點都運行着Redis進程和Sentinel進程,結構簡單,安全性也有了提高;

當M1發生故障時,S2和S3可以就該故障達成一致,並且能夠授權進行故障切換,從而使得客戶端可以正常使用;但也存在丟失已寫入數據的情況,因為redis內部使用異步複製,Master和Slave之間的數據在某個時間點可能不一致;

注意:

由於網絡存在分區性質,若客戶端C1和M1處於同一分區,但是該分區與S1,S2所在的分區無法通訊時,C1可以繼續向M1寫入數據,這寫數據將丟失,因為當網絡恢復時,M1可會被降為slave,而丟棄自己原本的數據;

使用下例配置可緩解該問題:

min-replicas-to-write 1
min-replicas-max-lag 5

上述配置表示,只要master無法寫入數據到任何一個slave超過5秒,則master停止接受寫入;

3.在客戶端部署哨兵

若某些原因導致沒有足夠的服務器節點用於部署哨兵,則可以將哨兵部署至客戶端,如下所示

※推薦評價好的iphone維修中心

擁有專業的維修技術團隊,同時聘請資深iphone手機維修專家,現場說明手機問題,快速修理,沒修好不收錢

若M1出現故障,則S1,S2,S3可順利的進行故障切換;但要注意該部署可能出現案例2中的問題

當然你也可以在客戶端和服務端同時部署哨兵;

配置示例:

#指出master地址和端口  以及仲裁數
sentinel monitor mymaster 127.0.0.1 6379 2
# 與master通訊超時時間,達到超時時間則sdown+1
sentinel down-after-milliseconds mymaster 60000
# 同一個master,開始新的故障轉移的時間(將是上一次的兩倍)
# 若slave連接到錯誤的master超過這個時間后slave將被重新連接到正確的master
# 取消正在進行中的故障轉移等待時間
# 按照parallel-syncs指定的配置進行複製的時間,超時候將不再受parallel-syncs的限制
sentinel failover-timeout mymaster 180000
# 發生故障轉移后,同時進行同步的副本數量
sentinel parallel-syncs mymaster 1

集群

Redis 集群是一個提供在多個Redis間節點間共享數據的程序集。

Redis集群並不支持處理多個keys的命令(如mset),因為這需要在不同的節點間移動數據,從而達不到像Redis那樣的性能,在高負載的情況下可能會導致不可預料的錯誤.

Redis 集群通過分區來提供一定程度的可用性,在實際環境中當某個節點宕機或者不可達的情況下繼續處理命令. Redis 集群的優勢:

  • 自動分割數據到不同的節點上。
  • 整個集群的部分節點失敗或者不可達的情況下能夠繼續處理命令。

示意圖:

集群的數據分片

Redis 集群沒有使用一致性hash, 而是引入了 哈希槽的概念.

Redis 集群有16384個哈希槽,每個key通過CRC16算法校驗后對16384取模來決定放置哪個槽.集群的每個節點負責一部分hash槽,舉個例子,比如當前集群有3個節點,那麼:

  • 節點 A 包含 0 到 5500號哈希槽.
  • 節點 B 包含5501 到 11000 號哈希槽.
  • 節點 C 包含11001 到 16384號哈希槽.

這種結構很容易添加或者刪除節點. 比如如果我想新添加個節點D, 我需要從節點 A, B, C中得部分槽到D上. 如果我想移除節點A,需要將A中的槽移到B和C節點上,然後將沒有任何槽的A節點從集群中移除即可. 由於從一個節點將哈希槽移動到另一個節點並不會停止服務,所以無論添加刪除或者改變某個節點的哈希槽的數量都不會造成集群不可用的狀態.

客戶端可以訪問任意節點進行讀寫操作,若哈希槽不在當前訪問的節點redis會自動的將指令移動到相關節點上;

主從複製模型

為了使在部分節點失敗或者大部分節點無法通信的情況下集群仍然可用,集群使用了主從複製模型,每個節點都會有至少一個slave;

集群在沒有slave的情況下,如果某個節點故障了,那麼整個集群就會以為缺少一部分槽而不可用.

然而如果在創建集群時為每個節點都添加了從節點,在某個節點故障后,其從節點將被選舉為新的主節點,整個集群就不會因找不到槽而不可用,當然若某個節點與其所有子節點都故障了那麼整個節點將不可用;

一致性保證

Redis 並不能保證數據的強一致性. 這意味這在實際中集群在特定的條件下可能會丟失寫操作,主要有兩方面原因:

  • 主節點到從節點之間的指令複製是異步完成的,主從之間在某個時間點可能不一致
  • 出現網絡分區,導致主節點可正常寫入,但是從節點已經被其他分區節點選舉為新的master,寫入的數據將丟失

容錯性

當某master節點故障時,其他master節點將發起投票,若一半以上的master認為其不可用,則從該節點的從節點中(若存在)選舉新的master;

若該master沒有從節點,則集群將不可用

另外當集群一半以上的節點都不可用時則無論這些節點是否有從節點,集群立即不可用;

創建集群:

Redis在5.0版本時放棄了Ruby集群的方式,改為C語言編寫的 redis-cli方式,使得集群的構建方式複雜度大大降低。

集群至少需要三個節點,每個節點一個從節點總共為6個

  1. 配置:

    若要以集群方式運行,則需要按以下方式修改配置文件,以啟用集群:

    cluster-enabled yes
    

    在實際開發中仍然建議使用單獨的虛擬機來部署所有的redis節點,下例為了簡化操作,在同一台虛擬機上搭建集群來進行測試:

  2. 添加上述配置后將bin目錄複製6分名稱為7001-7006,端口從7001-7006

  3. 分別啟動6個redis示例

  4. 使用redis-cli創建集群

    redis-cli --cluster create 10.211.55.9:7001 10.211.55.9:7002 10.211.55.9:7003 10.211.55.9:7004 10.211.55.9:7005 10.211.55.9:7006 --cluster-replicas 1
    

    過程中集群將重寫配置文件,需輸入yes確認

    創建完成后提示如下信息:

    ![image-20200602174849244](/Users/jerry/Library/Application Support/typora-user-images/image-20200602174849244.png)

    可以看到,集群自動為每個master平均分配了哈希槽,並且設置了一個slave

  5. 連接集群

    ./redis-cli -h 10.211.55.9 -p 7001 -c
    # 參數 -c 即表示連接到集群
    
  6. 查看集群狀態

    cluster info
    
  7. 查看節點信息,包括ip,port,id,槽,主/從;

    cluster nodes
    

添加節點

Redis集群支持動態擴展,期間redis可正常響應客戶端訪問

  1. 首先製作新的redis實例端口為7007並啟動

  2. 添加到集群中

    ./redis-cli --cluster add-node 10.211.55.9:7007 10.211.55.9:7001
    

    添加成功:

  3. 新的節點默認作為master,但是該master沒有分配槽位,使用前必須分配哈希槽

    下例表示從id為cc2e48268ccdd52d1c7840c8f9d2d7f15cc74c1b的節點移動1000個槽到cda3828e42e23dcbdb141db2fed221bc07c59f65節點

    ./redis-cli --cluster reshard 10.211.55.9:7001 --cluster-from cc2e48268ccdd52d1c7840c8f9d2d7f15cc74c1b --cluster-to cda3828e42e23dcbdb141db2fed221bc07c59f65 --cluster-slots 1000
    #--cluster-from  來源節點 多個之前用逗號隔開, all 表示從所有節點中平均分配
    #--cluster-to    目標節點
    #--cluster-slots 1000  移動哈希槽數量
    
  4. 為新的master添加從節點

  • 再次啟動一個新的實例

    • 添加至集群並指定為某master的slave

      ./redis-cli --cluster add-node 10.211.55.9:7008 10.211.55.9:7001 --cluster-slave --cluster-master-id cda3828e42e23dcbdb141db2fed221bc07c59f65
      #--cluster-slave 指定新節點作為slave
      #--cluster-master-id 指定新節點的master
      

刪除節點

  1. 刪除從節點7008

    ./redis-cli --cluster del-node 10.211.55.9:7008 887d2f115f6a94bda86863576d73a131f12229d5
    #指定集群host:port  和要刪除的節點id
    
  2. 將主節點的哈希槽分配給其他的主節點

    /redis-cli --cluster reshard 10.211.55.9:7001 --cluster-from cda3828e42e23dcbdb141db2fed221bc07c59f65 --cluster-to cc2e48268ccdd52d1c7840c8f9d2d7f15cc74c1b 
    
  3. 刪除主節點

    ./redis-cli --cluster del-node 10.211.55.9:7007 887d2f115f6a94bda86863576d73a131f12229d5
    #指定集群host:port  和要刪除的節點id
    
  4. 哈希槽均衡,該操作檢查各節點的槽均衡情況,若差異較大則自動重新分配

    ./redis-cli --cluster rebalance 10.211.55.9:7001
    

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※台北網頁設計公司這麼多該如何選擇?

網動是一群專業、熱情、向前行的工作團隊,我們擁有靈活的組織與溝通的能力,能傾聽客戶聲音,激發創意的火花,呈現完美的作品

“造輪運動”之 ORM框架系列(二)~ 說說我心目中的ORM框架,“造輪運動”之 ORM框架系列(一)~談談我在實際業務中的增刪改查_租車

※超省錢租車方案

商務出差、學生出遊、旅遊渡假、臨時用車!GO 神州租賃有限公司!合法經營、合法連鎖、合法租賃小客車!

ORM概念解析

   首先梳理一下ORM的概念,ORM的全拼是Object Relation Mapping (對象關係映射),其中Object就是面向對象語言中的對象,本文使用的是c#語言,所以就是.net對象;Relation Mapping則是關係映射,在數據庫的系統中指的就是.net對象與數據庫表之間的關係映射。

  為什麼.net對象與數據庫表之間要進行關係映射呢?

  答案當然是顯而易見的,因為數據庫表的結構與對象的結構非常的相似,如果將兩者之間建立起映射關係,我們就可以很容易地在面向對象語言中像操作普通對象一樣去進行數據庫表的操作,那對程序員來說簡直就是福音。那麼這兩者之間的關係由誰來建立呢,畢竟不能讓它倆憑空去產生關係,當中要有“媒人”撮合,這個“媒人”就叫做ORM框架,也可以叫做數據庫持久層框架。

  在上一篇 “造輪運動”之 ORM框架系列(一)~談談我在實際業務中的增刪改查 中,談了一下我遇到的增刪改查,並分析了原生sql、Lambda to sql、存儲過程等方式的利弊,在這其中我也慢慢地形成了自己對ORM框架的認識,也逐漸繪製出了一幅我心目中完美的ORM框架藍圖。

  描繪藍圖之前先給我的ORM框架取個名字,叫做CoffeeSQL,這個名字的由來是因為我希望自己用了這個框架以後可以給我節省出工作中能享受一杯Coffee的時間~


1、實體映射

   c#的對象想要與數據庫表建立映射關係,那就要記錄映射關係的配置信息,我更喜歡採用一種一目瞭然的方式來進行配置:直接在類的字段上標識Attribute。

  基本使用方式如下代碼所示:

 1  /// <summary>
 2  /// 實體類
 3  /// </summary>
 4  [Table("T_Students")]
 5  public class Student : EntityBase
 6  {
 7      [PrimaryKey]
 8      [Column]
 9      public string Id { get; set; }
10  
11      [Column("Name")]
12      public string StudentName { get; set; }
13  
14      [Column]
15      public int Age { get; set; }
16  }

  我們可以看到在這個實體類中我們使用了三個Attribute,分別為 TableAttribute(標識映射表)、 PrimaryKeyAttribute(標識主鍵)、CloumnAttribute(標識數據列),相信這些都很好理解。


2、lambda操作,增刪改查,強類型

   在一些最基礎的信息增刪改查功能中,對於單表的sql操作是非常頻繁的,我建議使用lambda的形式操作,第一是因為方便,第二是因為單表操作Lambda TO SQL轉化后的sql是最簡便的,所以不用擔心它的性能。

  具體的代碼操作如下:

  1)增

1  //Add
2  dbContext.Add<Student>(new Student { Id = newId, StudentName = "王二", Age = 20 });

   2)刪

1  //delete
2  dbContext.Delete<Student>(s => s.Id.Equals(newId));

   3)改

1  //update
2  dbContext.Update<Student>(s => new { s.StudentName }, new Student { StudentName = name })  //更新字段
3           .Where(s => s.Id.Equals(newId))                                                   //where條件
4           .Done();

   4)查

1  //select
2  dbContext.Queryable<Student>()
3           .Select(s => new { s.StudentName, s.Id })             //字段查詢
4           .Where(s => s.Age > 10 && s.StudentName.Equals(name)) //where條件
5           .Paging(1, 10)                                        //分頁查詢
6           .ToList();


3、原生sql操作,弱類型,非實體類字段的存儲的方式 => 索引器

   上面介紹的lambda表達式的操作方式只適用於單表的查詢,如果需要進行聯多表查詢或者需要進行更複雜的查詢,那麼我更傾向於進行原生sql的查詢。當然,原生sql的查詢也提供結果映射到對象的功能,類似於Dapper的用法。

  具體操作如下:

1  //原生sql查詢用法
2  string complexSQL = "select xxx from t_xxx A,t_yyy B where xx = {0} and yy = {1}";
3  object[] sqlParams = new Object[2] { DateTime.Now, 2 };
4  var resList = dbContext.Queryable(complexSQL, sqlParams).ToList<Student>();

   對上面的代碼稍微進行一下解釋,complexSQL 中的 {0} 和 {1} 是參數化查詢參數的佔位符,在原生sql的查詢用法中你可以使用任意c#的基本變量去填充佔位符,最終獲得sql參數化查詢的效果,用法非常方便。

  當然你可能會困惑:假如我查詢的結果中包含了不是Student對象中字段的值怎麼辦?

  答案是,你可以用索引的方式將非Student對象中字段的值取出,下面做一個示範,假如你希望查出 xxx 字段,你可以這樣做:

1  Student resList1 = resList[0];
2  var segmentValue = (string)resList1["xxx"];  //查詢結果中的任何字段值都可以以索引的方式查出,記得轉換為字段的實際類型

   是不是So Easy!


4、更複雜的sql邏輯,那得用存儲過程

   製造生產類的企業的業務邏輯離不開流程加表單,表單的查詢與數據寫入就是屬於比較複雜的sql了。

  但是這其實還不算什麼,更複雜的是,由於現在流行的大數據概念,車間的主管們往往也想沾沾邊,所以會在車間的大屏上展現各種數據統計的看板,這其中就涉及到巨多表的查詢邏輯。曾經開發過一個看板功能,特地數了一下,單單一條sql就接近200行的代碼量,一點都不誇張。像這種邏輯很複雜的查詢,還可能涉及到依據不同條件執行不同sql的場景,我當然不會在高級語言中拼接原生sql了,因為那樣容易把自己搞暈哦。這個時候就要祭出最後的大殺技——存儲過程。

  在CoffeeSQL中你可以這樣使用存儲過程:

 1     using (ShowYouDbContext dbContext = new ShowYouDbContext())
 2     {
 3         string strsp = "xxx_storeprocedureName";
 4 
 5         OracleParameter[] paras = new OracleParameter[]
 6         {
 7             new OracleParameter("V_DATE",OracleDbType.Varchar2,50),
 8             new OracleParameter("V_SITE",OracleDbType.Varchar2,50),
 9             new OracleParameter("V_SCREEN",OracleDbType.Varchar2,50),
10             new OracleParameter("V_SHIFT",OracleDbType.Varchar2,50),
11             new OracleParameter("V_CURSOR",OracleDbType.RefCursor)
13 }; 14 15 paras[0].Value = info.date; 16 paras[1].Value = info.site; 17 paras[2].Value = info.screenKey; 18 paras[3].Value = info.shift; 19 paras[4].Direction = ParameterDirection.Output;21 22 DataSet ds = dbContext.StoredProcedureQueryable(strsp, paras).ToDataSet(); 23 24 return ds; 25 }

  這裏的用法並沒有做什麼包裝,值得一提的就是可以將查詢結果轉換為對象。當然,這是貫穿整個ORM框架的一大主要功能,無處不在。


5、數據庫連接管理,一主多從

  現如今大多數的數據庫都不是單一部署的,比較流行的數據庫部署方式是“一主多從”的方式,即一台數據庫作為寫入數據的數據庫(主庫),其他多台數據庫作為讀取數據的數據庫(從庫)去同步主庫的數據,從而實現了讀寫分離的功能,降低了主庫的訪問壓力,大大提高了數據庫的訪問性能。當然,我們現在所討論的這個ORM框架就理所當然地要支持這種“一主多從”的數據庫部署方式的數據庫操作。

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

有別於一般網頁架設公司,除了模組化的架站軟體,我們的營業主軸還包含:資料庫程式開發、網站建置、網頁設計、電子商務專案開發、系統整合、APP設計建置、專業網路行銷。

  具體“一主多從”的數據庫連接配置方式如下:

 1     public class ShowYouDbContext : OracleDbContext<ShowYouDbContext>
 2     {
 3         private static string writeConnStr = "xxxxxxx_1";
 4         private static string[] readConnStrs = new string[] {
 5 
 6             "xxxxxxxxx_2",
 7             "xxxxxxxxx_3",
 8             "xxxxxxxxx_4",
 9             "xxxxxxxxx_5",
10             "xxxxxxxxx_6"
11         };
12 
13         public ShowYouDbContext() : base(writeConnStr, readConnStrs)
14         {
15         }
16     }

  對DBContext類對象進行構造時將數據庫連接字符串當做構造參數傳入即可,第一條為主庫(寫數據庫)連接字符串,以後的都為從庫(讀數據庫)連接字符串。 


6、實體數據驗證,作為數據格式規範的防線

  實體數據驗證的概念很好理解:一個數據表中的每一個字段都有其長度、大小等限制,那麼每一個與數據表對應的實體也應當有相應的字段約束來作為數據格式規範的防線,讓持久化到數據表中的數據符合其所規定的的格式,也就相當於貨物在進入倉庫前做一個安全檢查。

  我們可以像這樣去配置一個實體類的數據驗證規則:

 1     [Table("B_DICTIONARY")]
 2     public class Dictionary : EntityCommon
 3     {
 4         [Length(1,50)]
 5         [Column]
 6         public string Name { get; set; }
 7         [Column]
 8         public string Value { get; set; }
 9         [Column]
10         public string Type { get; set; }
11     }

  這個實體類中的Name字段就標識了一個LengthAttribute標籤,規定了該字段的長度範圍為1~50,如果不符合則會拋出異常。當然,實體數據的驗證規則不止這一條,後期會根據需求再進行添加,或者用戶可以根據自己的需求進行擴展。


7、事務的操作形式,個人習慣,喜歡把transaction明確寫出來,不喜歡過度封裝

  事務是數據庫系統中的重要概念,事務的特性是ACID(原子性、一致性、隔離性、持久性),當然這裏不會去討論事務的概念,我要展示的是在CoffeeSql中如何使用事務:

 1     try
 2     {
 3         dbContext.DBTransaction.Begin();
 4 
 5         dbContext.Update<Machine_Match_Relation>(d => new { d.Del_Flag }, new Machine_Match_Relation { Del_Flag = 1 })
            .Where(d => d.Screen_Machine_Id.Equals(displayDeviceId)).Done(); 6 7 foreach(string bindDeviceId in bindDeviceIds) 8 { 9 dbContext.Add(new Machine_Match_Relation 10 { 11 Id = Utils.GetGuidStr(), 12 Screen_Machine_Id = displayDeviceId, 13 Machine_Id = bindDeviceId, 14 Creater = updater 15 }); 16 } 17 18 dbContext.DBTransaction.Commit(); 19 } 20 catch(Exception ex) 21 { 22 dbContext.DBTransaction.Rollback(); 23 throw ex; 24 }

  有人會說為什麼這裏不封裝一個方法,只要傳入業務操作代碼的委託Action就行了,當然可以,但是說實在的,真沒必要,如果你喜歡就自己封裝去吧。


8、可適配擴展多款不同的數據庫 

  作為一個能跟的上潮流的ORM,當然得具備適配多種數據庫的特性了,Oracle、Mysql、SqlServer等等數據庫,想怎麼適配就怎麼適配。

 1     //Mysql
 2     public class WQSDbContext : MysqlDbContext<WQSDbContext>
 3     {
 4         public WQSDbContext() : base(mysqlConnStr)
 5         {
 6             this.OpenQueryCache = false;
 7             this.Log = context =>
 8             {
 9                 Console.WriteLine($"sql:{context.SqlStatement}");
10                 Console.WriteLine($"time:{DateTime.Now}");
11             };
12         }
13     }
14 
15     //Oracle
16     public class WQSDbContext : OracleDbContext<WQSDbContext>
17     {
18         public WQSDbContext() : base(oracleConnStr)
19         {
20             this.OpenQueryCache = false;
21             this.Log = context =>
22             {
23                 Console.WriteLine($"sql:{context.SqlStatement}");
24                 Console.WriteLine($"time:{DateTime.Now}");
25             };
26         }
27     }

   目前CoffeeSQL實現了兩種數據庫的擴展,Oracle與Mysql。當然,如果你還想適配更多的數據庫的話,你也可以嘗試擴展,只不過我目前用到的這兩種數據庫。


9、緩存功能,提高性能

  還記得當初一次校招的面試,面試官問我:“你覺得ORM的速度快還是Ado.net的速度快?”

     我傻傻地脫口而出:“那當然是Ado.net更快了,相比於ORM,它少了linq語句到sql的轉換步驟,而且ORM還比直接使用Ado.net多了查詢結果映射到對象的步驟。”

  看面像和發量就知道這個面試官 心(老)地(奸)善(巨)良(滑),他和我對視了3秒,然後說:

  “好,今天就到這,回去等通知吧!”

   等通知的後果那也就顯而易見了……


  直到後來我深入地了解了ORM框架的原理才知道,那個問題並不是我回答的一句話那麼簡單,因為我忽略了ORM緩存。

   CoffeeSql中也會有ORM緩存,ORM的緩存分為表緩存(二級緩存)與sql語句緩存(一級緩存):表緩存一般用於數據量較小且經常會進行查詢操作的表,會將整個表的數據緩存到緩存介質中;sql語句緩存可以適用各種類型的表,它是以sql查詢語句作為緩存鍵的。

  當然,你如果並不想要知道太多其中的細節,在使用時你只需要像這樣簡單的配置:

  (ORM緩存開關)

1     public class WQSDbContext : OracleDbContext<WQSDbContext>
2     {
3         public WQSDbContext() : base(oracleConnStr)
4         {
5             this.OpenTableCache = true;
6             this.OpenQueryCache = true;
7         }
8     }

  (表緩存的實體配置)

 1     [TableCaching]
 2     [Table("B_DICTIONARY")]
 3     public class Dictionary : EntityCommon
 4     {
 5         [Column]
 6         public string Name { get; set; }
 7         [Column]
 8         public string Value { get; set; }
 9         [Column]
10         public string Type { get; set; }
11     }

   如果在實體類上標記TableCachingAttribute而且打開了表緩存,那麼就會對當前的數據表進行全表數據的緩存。

  要注意,表緩存一般只用在小數據量且查詢頻繁的表中。因為表緩存功能啟用後會事先去將全表的數據掃描然後存儲到本地緩存,直接在緩存中進行表數據的查詢操作,所以如果你將那種數據量很大且查詢並不是很頻繁的表開啟了表緩存,那你可以想象一下這個肯定會是一個得不償失的行為。


   以上的代碼操作是我當初對CoffeeSQL的預想,當然,現在都成為了現實。以上的內容實際上就相當於CoffeeSQL的操作手冊,因為上面的代碼完全是按照實際的CoffeeSQL的框架操作來進行展示的。

     有關於CoffeeSQL更詳細的使用細節我會在源碼的測試代碼中給出,觀眾們可以移步去看源碼:

   https://gitee.com/xiaosen123/CoffeeSqlORM

  本文為作者原創,轉載請註明出處:https://www.cnblogs.com/MaMaNongNong/p/12896757.html


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

日本、大陸,發現這些先進的國家已經早就讓電動車優先上路,而且先進國家空氣品質相當好,電動車節能減碳可以減少空污

這些SUV男人們都好想買 但是……_如何寫文案

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

擁有後台管理系統的網站,將擁有強大的資料管理與更新功能,幫助您隨時新增網站的內容並節省網站開發的成本。

所以在城市道路開着一輛硬派SUV,說得不好聽就是折磨啊。油耗肯定是個大頭所謂多個香爐多隻鬼,更何況硬派SUV身上多了那麼多的部件,車身的重量相對城市SUV肯定會更大,大家都知道車子的油耗跟車重是脫不了干係的,車重了,油耗肯定就更大了。

和很多車迷一樣,也是一名SUV愛好者,每次看到微博大V或者各種越野愛好者開着他們的LC、霸道,開着他們的牧馬人、奔馳G去攀山涉水,進西藏,走新疆的時候,難免都會腦袋一熱,要不,我也買一輛硬派SUV然後像他們一樣去馳騁野外吧,那應該就是我想要的生活。

然而,事實上那些我們所青睞的硬派SUV,銷量其實都不樂觀,標杆產品普拉多還算好,9月份賣出了3737輛,但對比動輒月銷上萬的城市SUV,普拉多的銷量並不閃亮。至於自主品牌,賣得最好的硬派SUV要數馭勝的S350,但銷量也就2943輛,這已經是賣得最好的自主硬派SUV了。

就納悶了,我們都那麼喜歡這些硬派SUV(別不認哈,在硬派SUV的文章里看過你們的留言,一個個都是垂涎欲滴的),為什麼到我們要掏錢買車的時候,卻不願意選擇它們?其實這現象的出現並不是沒有道理的,整理了一下,硬派SUV不受待見,主要是以下的原因:

先天就有制約條件

硬派SUV的動力、底盤等的調校都是圍繞越野來做的,所以在城市道路的行駛質感、乘坐體驗都不及轎車或者城市SUV,說白了,就是舒適性不夠。

由於硬派SUV多數都是非承載式車身,而且是帶有前後整體橋的,

※教你寫出一流的銷售文案?

銷售文案是什麼?A文案是廣告用的文字。舉凡任何宣傳、行銷、販賣商品時所用到的文字都是文案。在網路時代,文案成為行銷中最重要的宣傳方式,好的文案可節省大量宣傳資源,達成行銷目的。

底盤的部件本來就多,所以大部分的硬派SUV車身都會比較高。車身較高的硬派SUV在城市道路中進行頻繁的啟動停止和轉彎切線等等的動作時,側傾就會相對明顯;同時這麼高的車身也不利於空氣動力學的設計,從而造成了較差的駕乘體驗。

硬派SUV並不適合城市駕駛

除了車身的高度需要妥協,硬派SUV的油門響應會調校得比較遲滯,因為太過於靈敏的油門響應不利於越野工況下的脫困;再有一個就是剎車,因為車子本身的重心較高,太靈敏的剎車不利於車身的穩定行駛,所以硬派SUV的剎車都會調校的比較軟,每次剎車都需要深踩,在市區啟停幾次之後,右腳還是會蠻累的。

最後要說一個的就是底盤,為了維持車身的整體性和剛度,防止重心較高的車子發生側翻,所以硬派SUV的底盤調校都會偏硬,當然這也有利於在越野過程中減少多餘的跳動。而這種硬朗的底盤調校風格,放到城市道路上就會造成不舒適,路面很小的顛簸都會傳遞到車內形成明顯的震動,乘坐感並不友好。所以在城市道路開着一輛硬派SUV,說得不好聽就是折磨啊。

油耗肯定是個大頭

所謂多個香爐多隻鬼,更何況硬派SUV身上多了那麼多的部件,車身的重量相對城市SUV肯定會更大,大家都知道車子的油耗跟車重是脫不了干係的,車重了,油耗肯定就更大了。像3.5L排量的行業標杆普拉多,官方百公里油耗都去到11.4L,更別說這已經是理想化的数字了,也更別說你在市區經常要走走停停了。算下來,每天通勤的油費都夠嗆。

重點是這個:硬派SUV都不便宜啊

其實普拉多還好,懸挂的前段都會有一點軟,所以在城市道路也不至於太難受,而普拉多的入門價格都去到36.98萬了。至於越野粉充值信仰的良物,Jeep牧馬人,最便宜的車型也要去到42.95萬元。要知道這個價格足夠買一輛操控一流的寶馬3系有餘了。唯有自主品牌的馭勝S350比較便宜,15萬元的級別,然而這輛車子的“越野”,更多的體現在它的外觀,而不是性能。

本站聲明:網站內容來源於http://www.auto6s.com/,如有侵權,請聯繫我們,我們將及時處理

※別再煩惱如何寫文案,掌握八大原則!

什麼是銷售文案服務?A就是幫你撰寫適合的廣告文案。當您需要販售商品、宣傳活動、建立個人品牌,撰寫廣告文案都是必須的工作。

為什麼要找教授買車?看完這裏給您答案_網頁設計公司

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

當全世界的人們隨著網路時代而改變向上時您還停留在『網站美醜不重要』的舊有思維嗎?機會是留給努力改變現況的人們,別再浪費一分一秒可以接觸商機的寶貴時間!

粉絲“小珊”是一名廣州在讀的女研究生,老家在廣東陽江,這次購買的車是皇冠2。0T,車是幫她爸爸買的,找到我們幫忙是因為爸爸在老家當地一直談不到滿意的價格,恰巧小珊一直有關注玩車並且知道可以幫忙購車,就抱着試一試的心態找到我們,結果是給到了小珊爸爸一個很滿意的價格,並且從訂車到提車只用了一周的時間。

又是新一天的開始,迅速進入工作狀態,回復用戶諮詢訂單;接聽用戶諮詢電話;幫用戶找車談價格;邀約用戶到店看車;幫助用戶成功買車;協助用戶驗車提車。

以上是每天在重複的工作,這既有規律又重複的事情在很多人看來是枯燥而乏味的,但是卻每天都樂在其中,因為每當看到用戶充滿笑容的提車照片時所有的辛苦都可以拋之腦後,而為了讓大家也能感受到和車主的那份喜悅,我們特意邀請了三位粉絲車主錄了一段視頻專訪來給大家展示。

粉絲“小珊”是一名廣州在讀的女研究生,老家在廣東陽江,這次購買的車是皇冠2.0T,車是幫她爸爸買的,找到我們幫忙是因為爸爸在老家當地一直談不到滿意的價格,恰巧小珊一直有關注玩車並且知道可以幫忙購車,

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

透過資料庫的網站架設建置,建立公司的形象或購物系統,並提供最人性化的使用介面,讓使用者能即時接收到相關的資訊
就抱着試一試的心態找到我們,結果是給到了小珊爸爸一個很滿意的價格,並且從訂車到提車只用了一周的時間。

粉絲“阿全”是一名土生土養的廣州90后,目標車型是鋒范,作為一名“老粉”,阿全一開始就找到了,當時剛好是9月初,各大經銷商為了十一黃金周沖銷量9月份的車價都開始收緊了,為了滿足阿全近期提車的要求,找到了合作較好的廣本經銷商,在市場都收緊價格的情況下為阿全爭取到了接近收價前的優惠,並且在原本沒現車的情況下也和經銷商協調回來了一台現車。

粉絲“阿曾”是一名廣州當地醫院的內科醫生,平時工作十分忙,根本就沒有時間去看車談價,所以從一開始就找到了幫忙找車談價,目標車型是雅閣,卻在糾結2.0L還是2.4L版本,然後分析過阿曾平時大部分時間是在市區用車,因為工作忙跑高速的機會是少之又少,所以給推薦了2.0L版本的雅閣,市區用車省油之餘保養費用也較2.4L版本要經濟,最後阿曾接納了的建議,也在取得滿意的價格后一周左右的時間就提車了

本站聲明:網站內容來源於http://www.auto6s.com/,如有侵權,請聯繫我們,我們將及時處理

※想知道最厲害的網頁設計公司嚨底家"!

RWD(響應式網頁設計)是透過瀏覽器的解析度來判斷要給使用者看到的樣貌

印度洪災逾630人死 莫迪:建洪水預警系統_如何寫文案

※別再煩惱如何寫文案,掌握八大原則!

什麼是銷售文案服務?A就是幫你撰寫適合的廣告文案。當您需要販售商品、宣傳活動、建立個人品牌,撰寫廣告文案都是必須的工作。

摘錄自2020年8月10日中央社報導

印度雨季豪雨成災,影響1750萬人、至少造成630人喪生,總理莫迪今天(10日)與受災的6省省長視訊討論災情,認為中央與地方應建立一套永久洪水預報系統。

雨季帶來的豪雨和洪水重創印度阿薩姆省(Assam)、北方省(UP)、克勒拉省(Kerala)、卡納塔卡省(Karnataka)和馬哈拉什特拉省(Maharashtra)等6省,根據紅十字會與紅新月會國際聯合會(IFRC)8月初公布的資料,迄今已有近1750萬人受到影響,超過630人死於洪水帶來的相關災害。

※教你寫出一流的銷售文案?

銷售文案是什麼?A文案是廣告用的文字。舉凡任何宣傳、行銷、販賣商品時所用到的文字都是文案。在網路時代,文案成為行銷中最重要的宣傳方式,好的文案可節省大量宣傳資源,達成行銷目的。

莫迪(Narendra Modi)在會議中說,所有中央機構和地方政府之間應加強協調聯繫,應建立一套永久的洪水預報系統,並採用創新技術改善預報和預警系統。

莫迪說,過去幾年,中央氣象局(IMD)和中央水資源委員會(Central Water Commission)等預報機構一直共同努力,以制定更好、更有用的洪水預報系統,目前正在試點採用人工智慧等創新科技改善具體地點的洪水預報。

國際新聞
印度
暴雨
洪水

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

擁有後台管理系統的網站,將擁有強大的資料管理與更新功能,幫助您隨時新增網站的內容並節省網站開發的成本。