※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!
當全世界的人們隨著網路時代而改變向上時您還停留在『網站美醜不重要』的舊有思維嗎?機會是留給努力改變現況的人們,別再浪費一分一秒可以接觸商機的寶貴時間!
容器的實現原理
從本質上,容器其實就是一種沙盒技術。就好像把應用隔離在一個盒子內,使其運行。因為有了盒子邊界的存在,應用於應用之間不會相互干擾。並且像集裝箱一樣,拿來就走,隨處運行。其實這就是 PaaS 的理想狀態。
實現容器的核心,就是要生成限制應用運行時的邊界。我們知道,編譯后的可執行代碼加上數據,叫做程序。而把程序運行起來后,就變成了進程,也就是所謂的應用。如果能在應用啟動時,給其加上一個邊界,這樣不就能實現期待的沙盒嗎?
在 Linux 中,實現容器的邊界,主要有兩種技術 Cgroups 和 Namespace. Cgroups 用於對運行的容器進行資源的限制,Namespace 則會將容器隔離起來,實現邊界。
這樣看來,容器只是一種被限制的了特殊進程而已。
容器的隔離:Namespace
在介紹 Namespace 前,先看一個實驗:
# 使用 python3.6.8 的官方鏡像,建立了一個運行 django 的環境
# 進入該容器后,使用 ps 命令,查看運行的進程
root@8729260f784a:/src# ps -A
  PID TTY          TIME CMD
    1 ?        00:01:22 gunicorn
   22 ?        00:01:20 gunicorn
   23 ?        00:01:24 gunicorn
   25 ?        00:01:30 gunicorn
   27 ?        00:01:16 gunicorn
   41 pts/0    00:00:00 bash
   55 pts/0    00:00:00 ps
可以看到,容器內 PID =1 的進程,是 gunicorn 啟動的 django 應用。熟悉 Linux 的同學都知道,PID =1 的進程是系統啟動時的第一個進程,也稱 init 進程。其他的進程,都是由它管理產生的。而此時,PID=1 確實是 django 進程。
接着,退出容器,在宿主機執行 ps 命令
# 環境為 Centos7
[root@localhost ~]# ps -ef | grep gunicorn
root      9623  8409  0 21:29 pts/0    00:00:00 grep --color=auto gunicorn
root     30828 30804  0 May28 ?        00:01:22 /usr/local/bin/python /usr/local/bin/gunicorn -c gunicorn_config.py ctg.wsgi
root     31171 30828  0 May28 ?        00:01:20 /usr/local/bin/python /usr/local/bin/gunicorn -c gunicorn_config.py ctg.wsgi
root     31172 30828  0 May28 ?        00:01:24 /usr/local/bin/python /usr/local/bin/gunicorn -c gunicorn_config.py ctg.wsgi
root     31174 30828  0 May28 ?        00:01:30 /usr/local/bin/python /usr/local/bin/gunicorn -c gunicorn_config.py ctg.wsgi
root     31176 30828  0 May28 ?        00:01:16 /usr/local/bin/python /usr/local/bin/gunicorn -c gunicorn_config.py ctg.wsgi
如果以宿主機的視角,發現 django 進程 PID 變成了 30828. 這也就不難證明,在容器中,確實做了一些處理。把明明是 30828 的進程,變成了容器內的第一號進程,同時在容器還看不到宿主機的其他進程。這也說明容器內的環境確實是被隔離了。
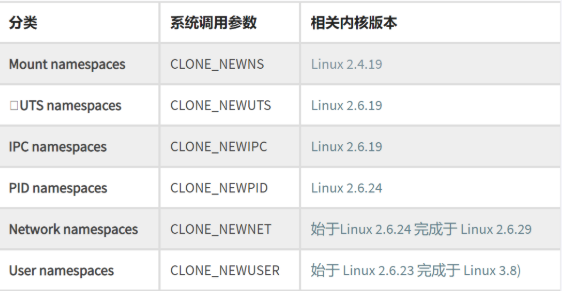
這種處理,其實就是 Linux 的 Namespace 機制。比如,上述將 PID 變成 1 的方法就是通過PID Namespace。在 Linux 中創建線程的方法是 clone, 在其中指定 CLONE_NEWPID 參數,這樣新創建的進程,就會看到一個全新的進程空間。而此時這個新的進程,也就變成了 PID=1 的進程。
int pid = clone(main_function, stack_size, CLONE_NEWPID | SIGCHLD, NULL);
在 Linux 類似於 PID Namespace 的參數還有很多,比如:
容器的限制:Cgroups
通過 Namespace 技術,我們實現了容器和容器間,容器與宿主機之間的隔離。但這還不夠,想象這樣一種場景,宿主機上運行着兩個容器。雖然在容器間相互隔離,但以宿主機的視角來看的話,其實兩個容器就是兩個特殊的進程,而進程之間自然存在着競爭關係,自然就可以將系統的資源吃光。當然,我們不能允許這麼做的。
Cgroups 就是 Linux 內核中用來為進程設置資源的一個技術。
Linux Cgroups 全稱是 Linux Control Group,主要的作用就是限制進程組使用的資源上限,包括 CPU,內存,磁盤,網絡帶寬。
還可以對進程進行優先級設置,審計,掛起和恢復等操作。
在之前的版本中,可通過 libcgroup tools 來管理 cgroup, 在 RedHat7 后,已經改為通過 systemctl 來管理。
我們知道,systemd 在 Linux 中的功能就是管理系統的資源。而為了管理的方便,衍生出了一個叫 Unit 的概念,比如一個 unit 可以有比較寬泛的定義,比如可以表示抽象的服務,網絡的資源,設備,掛載的文件系統等。為了更好的區分,Linux 將 Unit 的類型主要分為 12 種。
| 類型 | 作用 |
|---|---|
.automount |
用於自動掛載配置的掛載點 |
.swap |
描述系統的交換區,反映了設備或文件的路徑 |
.target |
在系統啟動或者改變狀態時,為其他 unit 提供同步點 |
.path |
定義的文件路徑,用於激活。 |
.service |
一個服務或者一個應用,具體定義在配置文件中。 |
.socket |
一個網絡或者 IPC socket,FIFO buffer. |
.device |
描述一個需要被 systemd udev 或 sysfs 文件系統管理的設備 |
.mount |
定義的掛載點 |
.timer |
定時器 |
.snapshot |
被 systemctl snapshot 命令自動創建的單元 |
.slice |
用於關聯 Linux Control Group 節點,根據關聯的 slice 來限制進程。一個管理單元的組。Slice 並不包含任何進程,僅僅管理由 service 和 scope 組成的層級結構。 |
.scope |
systemd 從 bus 接口收到消息后自動創建。Scope 封裝了任意進程通過 fork() 函數開啟或停止的進程,並且在 systemd 運行時註冊。例如:用戶 sessions,容器和虛擬機。 |
在 Cgroup 中,主要使用的是 slice, scope and service 這三種類型。
如創建一個臨時 cgroup, 然後對其啟動的進程進行資源限制:
 # 創建一個叫 toptest 的服務,在名為 test 的 slice 中運行
[root@localhost ~]# systemd-run --unit=toptest --slice=test top -b
Running as unit toptest.service.
現在 toptest 的服務已經運行在後台了
# 通過 systemd-cgls 來查看 Cgroup 的信息
[root@localhost ~]#  systemd-cgls
├─1 /usr/lib/systemd/systemd --switched-root --system --deserialize 22
├─test.slice
│ └─toptest.service
│   └─6490 /usr/bin/top -b

# 通過 systemctl status 查看服務的狀態
[root@localhost ~]# systemctl status toptest
● toptest.service - /usr/bin/top -b
   Loaded: loaded (/run/systemd/system/toptest.service; static; vendor preset: disabled)
  Drop-In: /run/systemd/system/toptest.service.d
           └─50-Description.conf, 50-ExecStart.conf, 50-Slice.conf
   Active: active (running) since Tue 2020-06-02 14:01:01 CST; 3min 50s ago
 Main PID: 6490 (top)
   CGroup: /test.slice/toptest.service
           └─6490 /usr/bin/top -b
現在對運行的 toptest 服務進行資源的限制。
# 先看下,沒有被限制前的 Cgroup 的信息, 6490 為進程 PID
[root@localhost ~]# cat /proc/6490/cgroup
11:pids:/test.slice
10:blkio:/test.slice
9:hugetlb:/
8:cpuset:/
7:memory:/test.slice
6:devices:/test.slice
5:net_prio,net_cls:/
4:perf_event:/
3:freezer:/
2:cpuacct,cpu:/test.slice
1:name=systemd:/test.slice/toptest.service

# 對其使用的 CPU 和 內存進行限制
systemctl set-property toptest.service CPUShares=600 MemoryLimit=500M

# 再次查看 Cgroup 的信息,發現在 cpu 和 memory 追加了一些內容。
[root@localhost ~]# cat /proc/6490/cgroup
11:pids:/test.slice
10:blkio:/test.slice
9:hugetlb:/
8:cpuset:/
7:memory:/test.slice/toptest.service
6:devices:/test.slice
5:net_prio,net_cls:/
4:perf_event:/
3:freezer:/
2:cpuacct,cpu:/test.slice/toptest.service
1:name=systemd:/test.slice/toptest.service
這時可以在 /sys/fs/cgroup/memory/test.slice 和 /sys/fs/cgroup/cpu/test.slice 目錄下,多出了一個叫 toptest.service 的目錄。
在其目錄下 cat toptest.service/cpu.shares 可以發現,裏面的 CPU 被限制了 600.
回到 Docker,其實 docker 和我們上面做的操作基本一致,具體需要限制哪些資源就是在 docker run 里指定:
$ docker run -it --cpu-period=100000 --cpu-quota=20000 ubuntu /bin/bash
關於 docker 具體的限制,可以在 sys/fs/cgroup/cpu/docekr/ 等文件夾來查看。
容器的文件系統:容器鏡像 – rootfs
現在我們知道,容器技術的核心就是通過 Namespace 限制了容器看到的視野,通過 Cgroup限制了容器可訪問的資源。 但關於 Mount Namespace 還有一些特殊的地方,需要着重關注下。
Mount Namespace 特殊之處在於,除了在修改時需要進程對文件系統掛載點的認證,還需要顯式聲明需要掛載那些目錄。在 Linux 系統中,有一個叫 chroot 的命令,可以改變進程的根目錄到指定的位置。而 Mount Namespace 正是基於 chroot 的基礎上發展出來的。
在容器內,應該看到完全獨立的文件系統,而且不會受到宿主機以及其他容器的影響。這個獨立的文件系統,就叫做容器鏡像。它還有一個更專業的名字叫 rootfs. rootfs 中包含了一個操作系統所需要的文件,配置和目錄,但並不包含系統內核。 因為在 Linux 中,文件和內核是分開存放的,操作系統只有在開啟啟動時才會加載指定的內核。這也就意味着,所有的容器都會共享宿主機上操作系統的內核。
在 PaaS 時代,由於雲端和本地的環境不同,應用打包的過程,一直是比較痛苦的過程。但有了 rootfs ,這個問題就被很好的解決了。因為在鏡像內,打包的不僅僅是應用,還有所需要的依賴,都被封裝在一起。這就解決了無論是在哪,應用都可以很好的運行的原因。
不光這樣,rootfs 還解決了可重用性的問題,想象這個場景,你通過 rootfs 打包了一個包含 java 環境的 centos 鏡像,別人需要在容器內跑一個 apache 的服務,那麼他是否需要從頭開始搭建 java 環境呢?docker 在解決這個問題時,引入了一個叫層的概念,每次針對 rootfs 的修改,都只保存增量的內容,而不是 fork 一個新鏡像。
層級的想法,同樣來自於 Linux,一個叫 union file system (聯合文件系統)。它最主要的功能就是將不同位置的目錄聯合掛載到同一個目錄下。對應在 Docker 裏面,不同的環境則使用了不同的聯合文件系統。比如 centos7 下最新的版本使用的是 overlay2,而 Ubuntu 16.04 和 Docker CE 18.05 使用的是 AuFS.
可以通過 docker info 來查詢使用的存儲驅動,我這裏的是 overlay2。
[root@localhost ~]# docker info
Client:
 Debug Mode: false

Server:
 Containers: 4
  Running: 4
  Paused: 0
  Stopped: 0
 Images: 4
 Server Version: 19.03.8
 Storage Driver: overlay2
接着我們來了解下,Overlay2 的文件系統在 docker 中是如何使用的?
Overlay2
在 Linux 的主機上,OverlayFS 一般有兩個目錄,但在显示時具體會显示為一個目錄。這兩個目錄被稱為層,聯合在一起的過程稱為 union mount. 在其下層的目錄稱為 lowerdir, 上層的目錄稱為 upperdir. 兩者聯合后,暴露出來的視圖稱為 view. 聽起來有點抽象,先看下整體結構:
可以看到,lowerdir 其實對應的就是鏡像層,upperdir 對應的就是容器器。而 merged 對應的就是兩者聯合掛載之後的內容。而且我們發現,當鏡像層和容器層擁有相同的文件時,會以容器層的文件為準(最上層的文件為準)。通常來說,overlay2 支持最多 128 lower 層。
下面實際看下容器層和鏡像具體的體現,我這台 linux 主機上,運行着 4 個 container。
Docker 一般的存儲位置在 /var/lib/docker,先看下裏面的結構:
[root@localhost docker]# ls -l /var/lib/docker
total 16
drwx------.  2 root root   24 Mar  4 03:39 builder
drwx--x--x.  4 root root   92 Mar  4 03:39 buildkit
drwx------.  7 root root 4096 Jun  1 10:36 containers
drwx------.  3 root root   22 Mar  4 03:39 image
drwxr-x---.  3 root root   19 Mar  4 03:39 network
drwx------. 69 root root 8192 Jun  1 15:01 overlay2
drwx------.  4 root root   32 Mar  4 03:39 plugins
drwx------.  2 root root    6 Jun  1 15:00 runtimes
drwx------.  2 root root    6 Mar  4 03:39 swarm
drwx------.  2 root root    6 Jun  1 15:01 tmp
drwx------.  2 root root    6 Mar  4 03:39 trust
drwx------.  3 root root   45 May 18 10:28 volumes
需要着重關注的是 container, image, overlay2 這幾個文件夾。
container:這個不用多說,正在運行或創建的容器會在這個目錄下。- image:對應記錄的就是鏡像。
overlay2:記錄的是每個鏡像下包含的lowerrdir.
之前提到,unionfs 的實現可能有多種,比如 overlay2,aufs,devicemapper 等。那麼自然在 image 文件夾下,就會存在多種驅動的文件夾,:
image/
└── overlay2
    ├── distribution
    ├── imagedb
    │   ├── content
    │   └── metadata
    ├── layerdb
    │   ├── mounts
    │   ├── sha256
    │   └── tmp
    └── repositories.json
這裏的 imagedb 和 layerdb, 就是存儲元數據的地方。之前我們了解到,容器的文件系統構成就是通過 image 層 和 container 層聯合構成的,而每個 image 可能是由多個層構成。這就意味着,每個層可能會被多個 image 引用。那麼之間是如何關聯的呢?答案就在 imagedb 這個文件下。
這裏我以 mysql 鏡像為例:
※想知道最厲害的網頁設計公司嚨底家"!
RWD(響應式網頁設計)是透過瀏覽器的解析度來判斷要給使用者看到的樣貌
# 查看 mysql 的鏡像 id
[root@localhost docker]# docker image ls
REPOSITORY          TAG                 IMAGE ID            CREATED             SIZE
ctg/mysql           5.7.29              84164b03fa2e        3 months ago        456MB

# 進入到 imagedb/content/sha256 目錄, 可以找到對應的鏡像 id
[root@localhost docker]# ls -l image/overlay2/imagedb/content/sha256/
...
-rw-------. 1 root root  6995 Apr 27 02:45 84164b03fa2ecb33e8b4c1f2636ec3286e90786819faa4d1c103ae147824196a

# 接着看下裏面記錄的內容, 這裏截取有用的部分
cat  image/overlay2/imagedb/content/sha256/84164b03fa2ecb33e8b4c1f2636ec3286e90786819faa4d1c103ae147824196a
{
.........
  "os": "linux",
  "rootfs": {
    "type": "layers",
    "diff_ids": [
      "sha256:f2cb0ecef392f2a630fa1205b874ab2e2aedf96de04d0b8838e4e728e28142da",
      "sha256:a9f6b7c7101b86ffaa53dc29638e577dabf5b24150577a59199d8554d7ce2921",
      "sha256:0c615b40cc37ed667e9cbaf33b726fe986d23e5b2588b7acbd9288c92b8716b6",
      "sha256:ad160f341db9317284bba805a3fe9112d868b272041933552df5ea14647ec54a",
      "sha256:1ea6ef84dc3af6506c26753e9e2cf7c0d6c1c743102b85ebd3ee5e357d7e9bc4",
      "sha256:6fce4d95d4af3777f3e3452e5d17612b7396a36bf0cb588ba2ae1b71d139bab9",
      "sha256:6de3946ea0137e75dcc43a3a081d10dda2fec0d065627a03800a99e4abe2ede4",
      "sha256:a35a4bacba4d5402b85ee6e898b95cc71462bc071078941cbe8c77a6ce2fca62",
      "sha256:1ff9500bdff4455fa89a808685622b64790c321da101d27c17b710f7be2e0e7e",
      "sha256:1cf663d0cb7a52a3a33a7c84ff5290b80966921ee8d3cb11592da332b4a9e016",
      "sha256:bcb387cbc5bcbc8b5c33fbfadbce4287522719db43d3e3a286da74492b7d6eca"
    ]
  }
}
可以看到 mysql 鏡像由 11 層組成,其中 f2cb 是最低層,bcb3 是最上層。
接着,我們看下 layerdb 的內容:
[root@localhost docker]# ls -l  image/overlay2/layerdb/
total 8
drwxr-xr-x.  6 root root 4096 May 13 13:38 mounts
drwxr-xr-x. 39 root root 4096 Apr 27 02:51 sha256
drwxr-xr-x.  2 root root    6 Apr 27 02:51 tmp

# 首先看下 sha256 目錄下的內容
[root@localhost docker]# ls -l  image/overlay2/layerdb/sha256/
total 0
....
drwx------. 2 root root 71 Apr 27 02:45 bbb9cccab59a16cb6da78f8879e9d07a19e3a8d49010ab9c98a2c348fa116c87
drwx------. 2 root root 71 Apr 27 02:45 f2cb0ecef392f2a630fa1205b874ab2e2aedf96de04d0b8838e4e728e28142da
....
可以發現,在這裏僅能找到最底層的層 ID,原因在於層之間的關聯是通過 chainID 的方式保存的,簡單來說就是通過 sha256 算法后能計算出一層的容器 id.
比如這裏,最底層 id 是 f2cb0ecef392f2a630fa1205b874ab2e2aedf96de04d0b8838e4e728e28142da , 上一層 id 是 a9f6b7c7101b86ffaa53dc29638e577dabf5b24150577a59199d8554d7ce2921, 那麼對應在 sha256 目錄下的下一層 id 的計算方法就是:
[root@localhost docker]# echo -n "sha256:f2cb0ecef392f2a630fa1205b874ab2e2aedf96de04d0b8838e4e728e28142da sha256:a9f6b7c7101b86ffaa53dc29638e577dabf5b24150577a59199d8554d7ce2921" | sha256sum
bbb9cccab59a16cb6da78f8879e9d07a19e3a8d49010ab9c98a2c348fa116c87  -
接着我們可以在 sha256 目錄下,找到 bbb9.. 這層的內容。
OK,現在我們已經把鏡像和層關聯起來,但之前說過,image 目錄下存的都是元數據。真實的 rootfs 其實在另一個地方 – /docker/overlay2 下。
# 通過查詢 cache-id,得到就是真實的 rootfs 層
[root@localhost docker]# cat  image/overlay2/layerdb/sha256/f2cb0ecef392f2a630fa1205b874ab2e2aedf96de04d0b8838e4e728e28142da/cache-id
2996b24990e75cbd304093139e665a45d96df8d7e49334527827dcff820dbf16[
進入到 /docker/overlay2 下查看:
[root@localhost docker]# ls -l overlay2/
total 4
...
drwx------. 3 root root   47 Apr 27 02:45 2996b24990e75cbd304093139e665a45d96df8d7e49334527827dcff820dbf16
...
drwx------. 2 root root 4096 May 13 13:38 l
這樣真實的 rootfs 層也被找到了。
這裏重新梳理下,我們先是在 mage/overlay2/imagedb/content/sha256/ ,根據 image id 查看該 image 具有所有的層ID,然後根據最底層ID和上層ID通過 sha256 計算得到,引用的上一層 ID, 依次類推,關聯所有的層。最後通過每一層的 cache-id,將元數據和真實的 rootfs 層數據對應起來了。
最後總結一下,rootfs 的構成。
每個 rootfs 由鏡像層(lowerdir)和 容器層(upperdir)構成,其中鏡像層只能只讀,而容器層則能讀寫。而且鏡像層可有最多128層構成。
其實,rootfs 構成還有另外一層,但由於在進行提交或編譯時,不會把這層加進去,所以就沒把這層算在rootfs裏面,但實際上存在的。
在之前我們查看 ls -l /var/lib/docker/overlay2/ 下鏡像層,會看到好幾個以 -init 結尾的目錄,而且數量恰好等於容器的數量。這層夾在鏡像層之上,容器層之下。是由 docker 內部單獨生成的一層,專門用於存放 etc/hosts、/etc/resolv.conf 等配置信息。存在的目的,是由於用戶在容器啟動時,需要配置一些特定的值,比如 hostname,dns 等,但這些配置僅對當前容器有效,放到其他環境下自然有別的配置,所以這層被單獨拿出來,在提交鏡像時,忽略這一層。
容器與虛擬機技術的對比
下面這張圖是 docker 官方中,截取下來的,基於上面我們學習的內容,重新分析下 docker 和 傳統 VM 的區別:
遷移性和性能:
- 傳統 VM: 需要基於 Hypervisor 的硬件虛擬化技術,模擬出 CPU,內存等硬件。然後在其上搭建一套完整的操作系統,自然在性能上會有很大的損失。遷移自然更不用說,傳統的 ova 導出后就是一個完整的操作系統。
- Docker:Docker 將 Hypervisor 的位置換成自己的 Docekr Engine. 然後運行的容器僅僅是一個特殊的進程,自然性能不會有太大的損失。並且可以應用和其所需要的系統文件打包成鏡像,無論在哪讀可以正常運行,而且相對於 ova 來說體積也小了更多。(需要內核支持)
一般來說,運行着 CentOS 的 KVM,啟動后,在不做優化的前提下,需要佔用 100~200 M 內存。在加上用戶對宿主機的調用,需要通過虛擬化軟件攔截和處理,又是一層性能損耗,特別是對計算資源,網絡和磁盤I/O等。
隔離性:
-
傳統 VM:由於是虛擬化出一套完整的操作系統,所以隔離性非常好。比如微軟的 Azure 平台,就是在 Windows 服務器上,虛擬出大量的 Linux 虛擬機。
-
Docker:在隔離性上相差就很多了,因為本身上容器就是一種進程,而所有的進程都需要共享一個系統內核。
-
這就意味着,在 Windows 上運行 Linux 容器,或者 Linux 宿主機運行高版本內核的容器就無法實現。
-
在 Linux 內核中,有許多資源和對象不能 Namespace 化,如時間,比如通過
settimeofday(2) 系統調用修改時間,整個宿主機的實際都會被修改。 -
安全的問題,共享宿主機內核的事實,容器暴露出的攻擊面更大。
-
資源的限制:
- 傳統 VM:非常便於管理,控制資源的使用,依賴於虛擬的操作系統。
- Docker:由於 docker 內資源的限制通過 Cgroup 實現,而 Cgroup 有很多不完善的地方,比如
- 對 /proc 的處理問題。進入容器后,執行
top命令,看到的信息和宿主機是一樣的,而不是配置后的容器的數據。(可以通過 lxcfs 修正)。 - 在運行 java 程序時,給容器內設置的內存為 4g,使用默認的 jvm 配置。而默認的 jvm 讀取的內存是宿主機(可能大於 4g),這樣就會出現 OOM 的情況。
- 對 /proc 的處理問題。進入容器后,執行
解決的問題
-
容器是如何進行隔離的?
在創建新進程時,通過 Namespace 技術,如 PID namespaces 等,實現隔離性。讓運行后的容器僅能看到本身的內容。
比如,在容器運行時,會默認加上 PID, UTS, network, user, mount, IPC, cgroup 等 Namespace.
-
容器是如何進行資源限制的?
通過 Linux Cgroup 技術,可為每個進程設定限制的 CPU,Memory 等資源,進而設置進程訪問資源的上限。
-
簡述下 docker 的文件系統?
docker 的文件系統稱為 rootfs,它的實現的想法來自與 Linux unionFS 。將不同的目錄,掛載到一起,形成一個獨立的視圖。並且 docker 在此基礎上引入了層的概念,解決了可重用性的問題。
在具體實現上,rootfs 的存儲區分根據 linux 內核和 docker 本身的版本,分為
overlay2,overlay,aufs,devicemapper等。rootfs(鏡像)其實就是多個層的疊加,當多層存在相同的文件時,上層的文件會將下層的文件覆蓋掉。 -
容器的啟動過程?
- 指定 Linux Namespace 配置
- 設置指定的 Cgroups 參數
- 切換進程的根目錄
-
容器內運行多個應用的問題?
首先更正一個概念,我們都說容器是一個單進程的應用,其實這裏的單進程不是指在容器中只允許着一個進程,而是指只有一個進程時可控的。在容器內當然可以使用 ping,ssh 等進程,但這些進程時不受 docker 控制的。
容器內的主進程,也就是 pid =1 的進程,一般是通過 DockerFile 中 ENTRYPOINT 或者 CMD 指定的。如果在一個容器內如果存在着多個服務(進程),就可能出現主進程正常運行,但是子進程退出掛掉的問題,而對於 docker 來說,僅僅控制主進程,無法對這種意外的情況作出處理,也就會出現,容器明明正常運行,但是服務已經掛掉的情況,這時編排系統就變得非常困難。而且多個服務,在也不容易進行排障和管理。
所以如果真的想要在容器內運行多個服務,一般會通過帶有
systemd或者supervisord這類工具進行管理,或者通過--init方法。其實這些方法的本質就是讓多個服務的進程擁有同一個父進程。但考慮到容器本身的設計,就是希望容器和服務能夠同生命周期。所以這樣做,有點背道而馳的意味。
控制(回收和生命周期的管理)
參考
Cgroup 介紹
Overlay2介紹
docker 官網
在一個容器內搭建多個服務
本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!
透過資料庫的網站架設建置,建立公司的形象或購物系統,並提供最人性化的使用介面,讓使用者能即時接收到相關的資訊