使用 Prometheus-Operator 監控 Calico

原文鏈接:https://fuckcloudnative.io/posts/monitoring-calico-with-prometheus-operator/

Calico 中最核心的組件就是 Felix,它負責設置路由表和 ACL 規則等,以便為該主機上的 endpoints 資源正常運行提供所需的網絡連接。同時它還負責提供有關網絡健康狀況的數據(例如,報告配置其主機時發生的錯誤和問題),這些數據會被寫入 etcd,以使其對網絡中的其他組件和操作人員可見。

由此可見,對於我們的監控來說,監控 Calico 的核心便是監控 Felix,Felix 就相當於 Calico 的大腦。本文將學習如何使用 Prometheus-Operator 來監控 Calico。

本文不會涉及到 Calico 和 Prometheus-Operator 的部署細節,如果不知道如何部署,請查閱官方文檔和相關博客。

1. 配置 Calico 以啟用指標

默認情況下 Felix 的指標是被禁用的,必須通過命令行管理工具 calicoctl 手動更改 Felix 配置才能開啟,需要提前配置好命令行管理工具。

本文使用的 Calico 版本是 v3.15.0,其他版本類似。先下載管理工具:

$ wget https://github.com/projectcalico/calicoctl/releases/download/v3.15.0/calicoctl -O /usr/local/bin/calicoctl
$ chmod +x /usr/local/bin/calicoctl

接下來需要設置 calicoctl 配置文件(默認是 /etc/calico/calicoctl.cfg)。如果你的 Calico 後端存儲使用的是 Kubernetes API,那麼配置文件內容如下:

apiVersion: projectcalico.org/v3
kind: CalicoAPIConfig
metadata:
spec:
  datastoreType: "kubernetes"
  kubeconfig: "/root/.kube/config"

如果 Calico 後端存儲使用的是 etcd,那麼配置文件內容如下:

apiVersion: projectcalico.org/v3
kind: CalicoAPIConfig
metadata:
spec:
  datastoreType: "etcdv3"
  etcdEndpoints: https://192.168.57.51:2379,https://192.168.57.52:2379,https://192.168.57.53:2379
  etcdKeyFile: /opt/kubernetes/ssl/server-key.pem
  etcdCertFile: /opt/kubernetes/ssl/server.pem
  etcdCACertFile: /opt/kubernetes/ssl/ca.pem

你需要將其中的證書路徑換成你的 etcd 證書路徑。

配置好了 calicoctl 之後就可以查看或修改 Calico 的配置了,先來看一下默認的 Felix 配置:

$ calicoctl get felixConfiguration default -o yaml

apiVersion: projectcalico.org/v3
kind: FelixConfiguration
metadata:
  creationTimestamp: "2020-06-25T14:37:28Z"
  name: default
  resourceVersion: "269031"
  uid: 52146c95-ff97-40a9-9ba7-7c3b4dd3ba57
spec:
  bpfLogLevel: ""
  ipipEnabled: true
  logSeverityScreen: Info
  reportingInterval: 0s

可以看到默認的配置中沒有啟用指標,需要手動修改配置,命令如下:

$ calicoctl patch felixConfiguration default  --patch '{"spec":{"prometheusMetricsEnabled": true}}'

Felix 暴露指標的端口是 9091,可通過檢查監聽端口來驗證是否開啟指標:

$ ss -tulnp|grep 9091
tcp    LISTEN     0      4096   [::]:9091               [::]:*                   users:(("calico-node",pid=13761,fd=9))

$ curl -s http://localhost:9091/metrics
# HELP felix_active_local_endpoints Number of active endpoints on this host.
# TYPE felix_active_local_endpoints gauge
felix_active_local_endpoints 1
# HELP felix_active_local_policies Number of active policies on this host.
# TYPE felix_active_local_policies gauge
felix_active_local_policies 0
# HELP felix_active_local_selectors Number of active selectors on this host.
# TYPE felix_active_local_selectors gauge
felix_active_local_selectors 0
...

2. Prometheus 採集 Felix 指標

啟用了 Felix 的指標后,就可以通過 Prometheus-Operator 來採集指標數據了。Prometheus-Operator 在部署時會創建 Prometheus、PodMonitor、ServiceMonitor、AlertManager 和 PrometheusRule 這 5 個 CRD 資源對象,然後會一直監控並維持這 5 個資源對象的狀態。其中 Prometheus 這個資源對象就是對 Prometheus Server 的抽象。而 PodMonitor 和 ServiceMonitor 就是 exporter 的各種抽象,是用來提供專門提供指標數據接口的工具,Prometheus 就是通過 PodMonitor 和 ServiceMonitor 提供的指標數據接口去 pull 數據的。

ServiceMonitor 要求被監控的服務必須有對應的 Service,而 PodMonitor 則不需要,本文選擇使用 PodMonitor 來採集 Felix 的指標。

PodMonitor 雖然不需要應用創建相應的 Service,但必須在 Pod 中指定指標的端口和名稱,因此需要先修改 DaemonSet calico-node 的配置,指定端口和名稱。先用以下命令打開 DaemonSet calico-node 的配置:

$ kubectl -n kube-system edit ds calico-node

然後在線修改,在 spec.template.sepc.containers 中加入以下內容:

        ports:
        - containerPort: 9091
          name: http-metrics
          protocol: TCP

創建 Pod 對應的 PodMonitor:

# prometheus-podMonitorCalico.yaml
apiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
  labels:
    k8s-app: calico-node
  name: felix
  namespace: monitoring
spec:
  podMetricsEndpoints:
  - interval: 15s
    path: /metrics
    port: http-metrics
  namespaceSelector:
    matchNames:
    - kube-system
  selector:
    matchLabels:
      k8s-app: calico-node
$ kubectl apply -f prometheus-podMonitorCalico.yaml

有幾個參數需要注意:

  • PodMonitor 的 name 最終會反應到 Prometheus 的配置中,作為 job_name。

  • podMetricsEndpoints.port 需要和被監控的 Pod 中的 ports.name 相同,此處為 http-metrics。

  • namespaceSelector.matchNames 需要和被監控的 Pod 所在的 namespace 相同,此處為 kube-system。

  • selector.matchLabels 的標籤必須和被監控的 Pod 中能唯一標明身份的標籤對應。

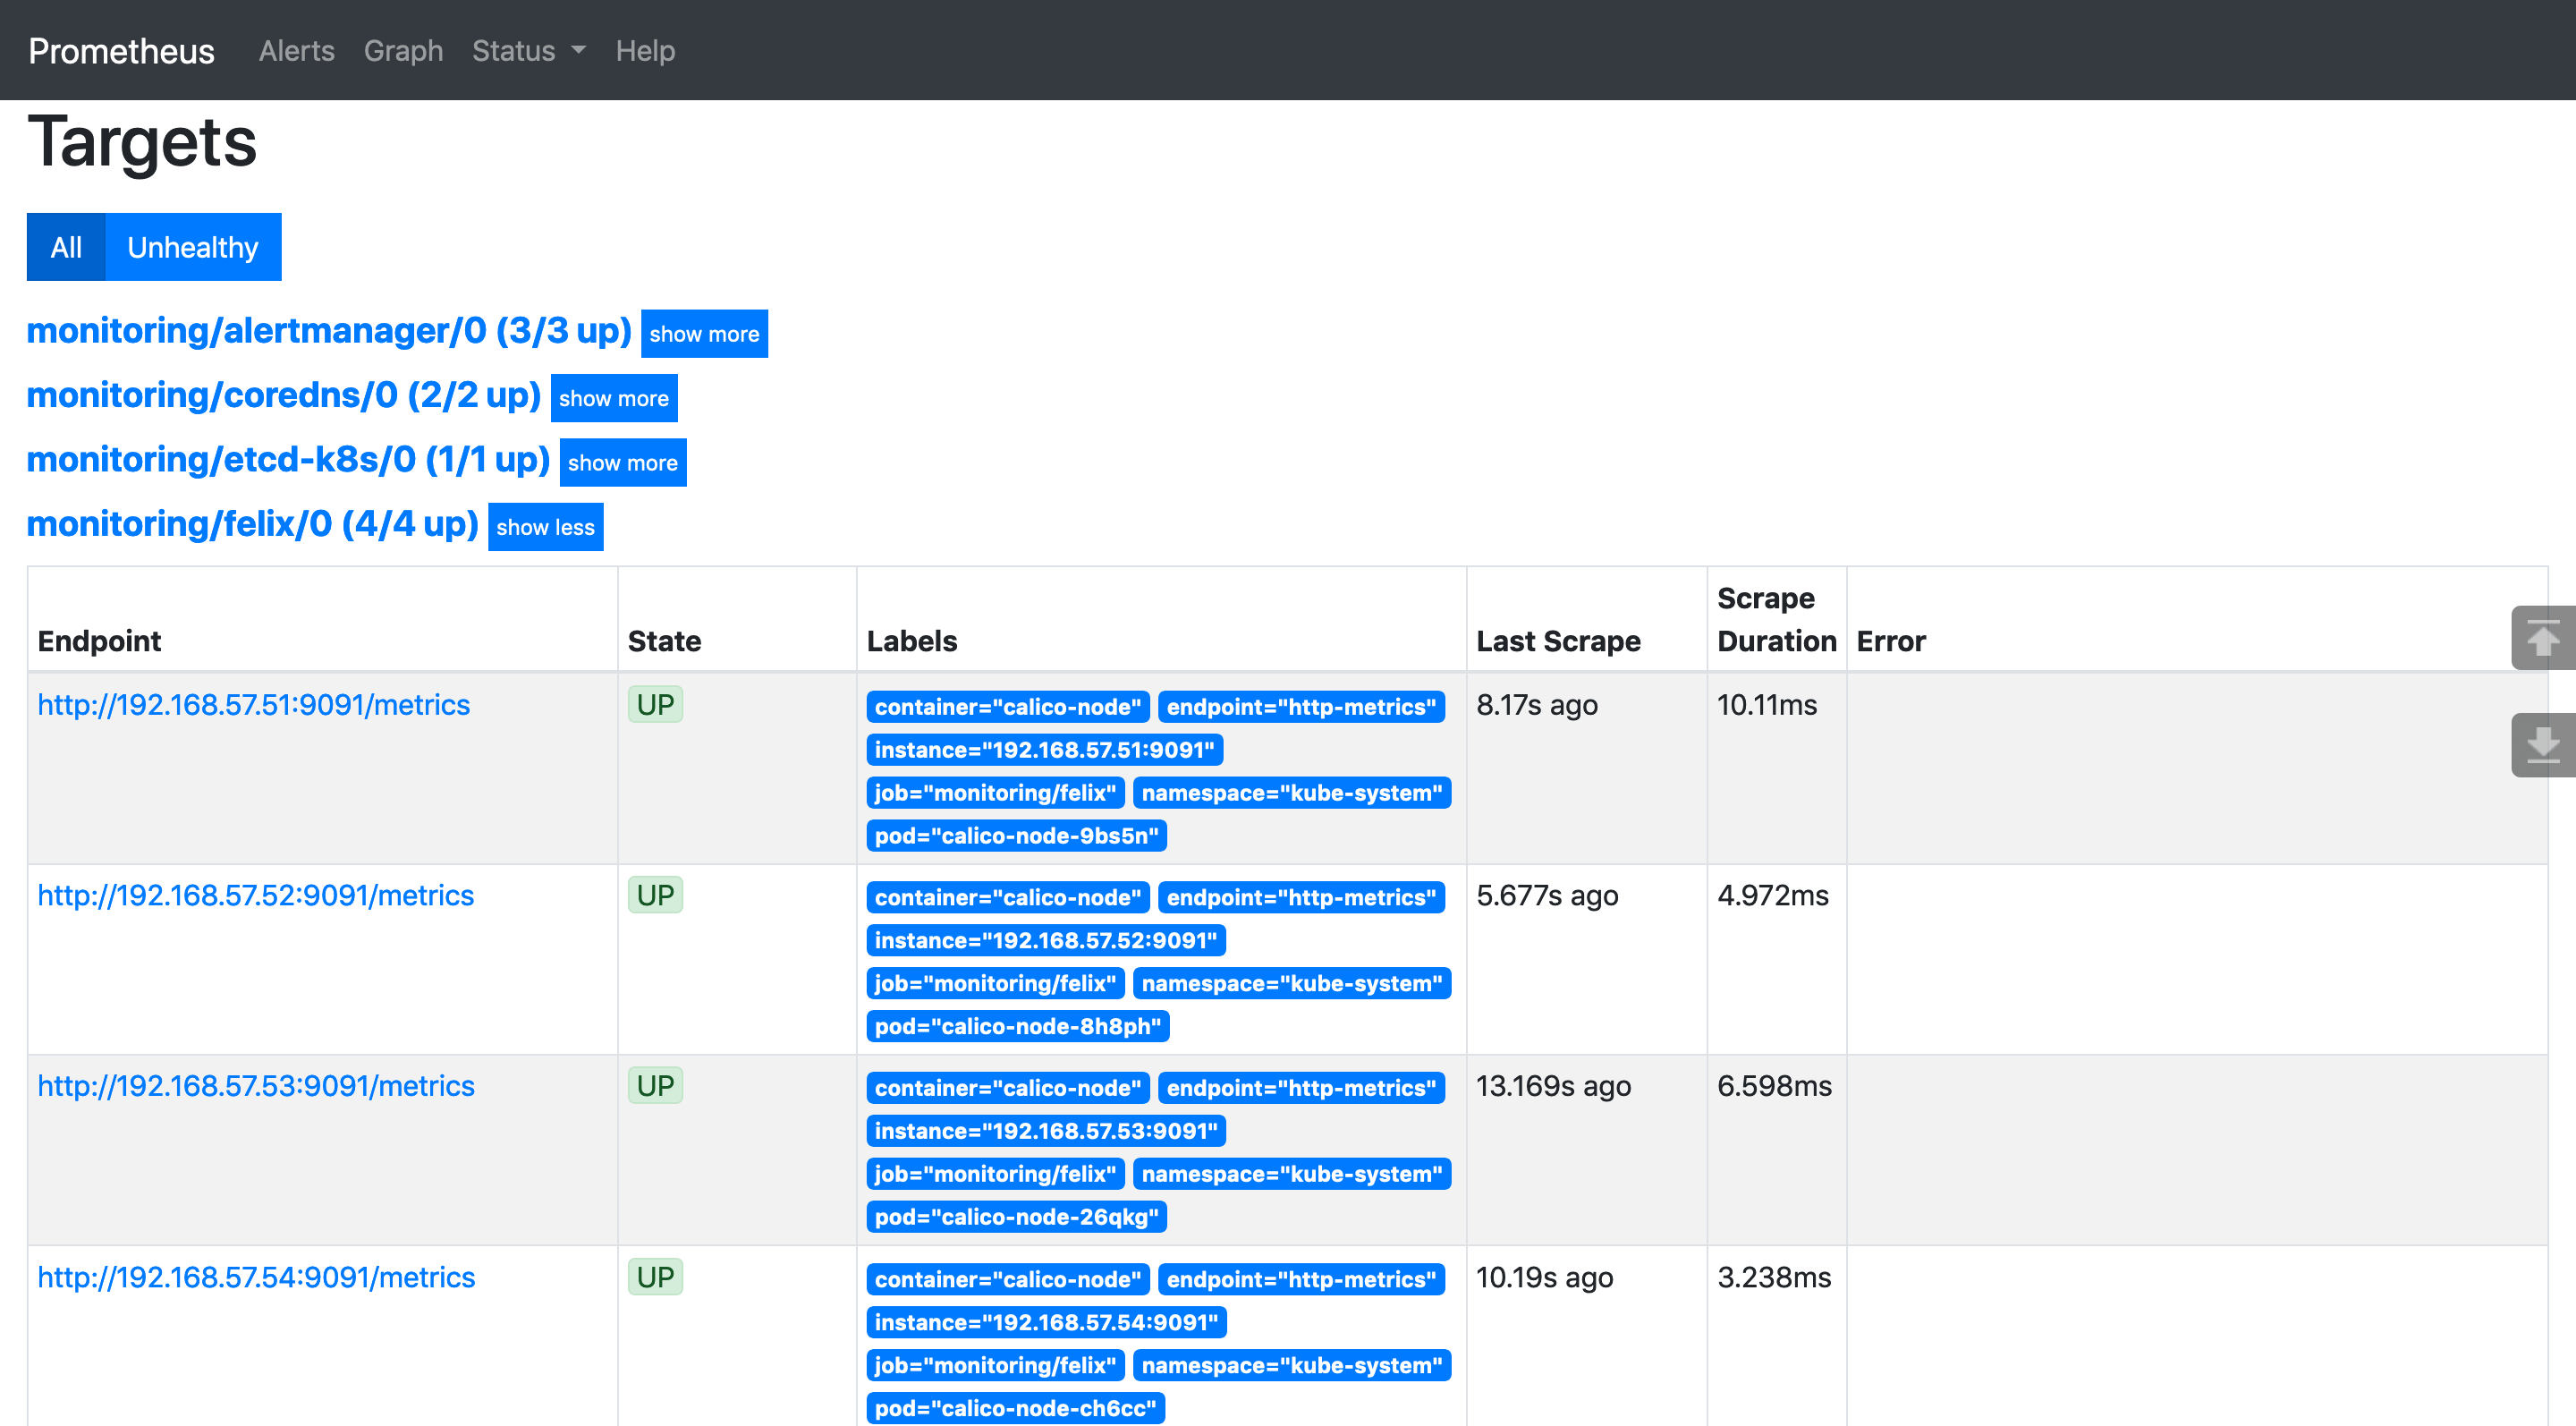
最終 Prometheus-Operator 會根據 PodMonitor 來修改 Prometheus 的配置文件,以實現對相關的 Pod 進行監控。可以打開 Prometheus 的 UI 查看監控目標:

注意 Labels 中有 pod="calico-node-xxx",表明監控的是 Pod。

3. 可視化監控指標

採集完指標之後,就可以通過 Grafana 的儀錶盤來展示監控指標了。Prometheus-Operator 中部署的 Grafana 無法實時修改儀錶盤的配置(必須提前將儀錶盤的 json 文件掛載到 Grafana Pod 中),而且也不是最新版(7.0 以上版本),所以我選擇刪除 Prometheus-Operator 自帶的 Grafana,自行部署 helm 倉庫中的 Grafana。先進入 kube-prometheus 項目的 manifests 目錄,然後將 Grafana 相關的部署清單都移到同一個目錄下,再刪除 Grafana:

$ cd kube-prometheus/manifests
$ mkdir grafana
$ mv grafana-* grafana/
$ kubectl delete -f grafana/

然後通過 helm 部署最新的 Grafana:

$ helm install grafana stable/grafana -n monitoring

訪問 Grafana 的密碼保存在 Secret 中,可以通過以下命令查看:

$ kubectl -n monitoring get secret grafana -o yaml

apiVersion: v1
data:
  admin-password: MnpoV3VaMGd1b3R3TDY5d3JwOXlIak4yZ3B2cTU1RFNKcVY0RWZsUw==
  admin-user: YWRtaW4=
  ldap-toml: ""
kind: Secret
metadata:
...

對密碼進行解密:

$ echo -n "MnpoV3VaMGd1b3R3TDY5d3JwOXlIak4yZ3B2cTU1RFNKcVY0RWZsUw=="|base64 -d

解密出來的信息就是訪問密碼。用戶名是 admin。通過用戶名和密碼登錄 Grafana 的 UI:

添加 Prometheus-Operator 的數據源:

Calico 官方沒有單獨 dashboard json,而是將其放到了 ConfigMap 中,我們需要從中提取需要的 json,提取出 felix-dashboard.json 的內容,然後將其中的 datasource 值替換為 prometheus。你可以用 sed 替換,也可以用編輯器,大多數編輯器都有全局替換的功能。如果你實在不知道如何提取,可以使用我提取好的 json:

修改完了之後,將 json 內容導入到 Grafana:

最後得到的 Felix 儀錶盤如下圖所示:

如果你對我截圖中 Grafana 的主題配色很感興趣,可以參考這篇文章:Grafana 自定義主題。

Kubernetes 1.18.2 1.17.5 1.16.9 1.15.12離線安裝包發布地址http://store.lameleg.com ,歡迎體驗。 使用了最新的sealos v3.3.6版本。 作了主機名解析配置優化,lvscare 掛載/lib/module解決開機啟動ipvs加載問題, 修復lvscare社區netlink與3.10內核不兼容問題,sealos生成百年證書等特性。更多特性 https://github.com/fanux/sealos 。歡迎掃描下方的二維碼加入釘釘群 ,釘釘群已經集成sealos的機器人實時可以看到sealos的動態。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※教你寫出一流的銷售文案?

YoyoGo基於ASP.NET Core設計的Golang實現

YoyoGo

YoyoGo 是一個用 Go 編寫的簡單,輕便,快速的 微服務框架,目前已實現了Web框架的能力,但是底層設計已支持多種服務架構。

Github

https://github.com/yoyofx/yoyogo

特色

  • 漂亮又快速的路由器
  • 中間件支持 (handler func & custom middleware)
  • 對 REST API 友好
  • 支持 MVC 模式
  • 受到許多出色的 Go Web 框架的啟發

框架安裝

go get github.com/yoyofx/yoyogo

安裝依賴 (由於某些原因國內下載不了依賴)

go version < 1.13

window 下在 cmd 中執行:
set GO111MODULE=on
set  GOPROXY=https://goproxy.cn

linux  下執行:
export GO111MODULE=on
export GOPROXY=https://goproxy.cn

go version >= 1.13

go env -w GOPROXY=https://goproxy.cn,direct

簡單的例子

package main
import ...

func main() {
    YoyoGo.CreateDefaultBuilder(func(router Router.IRouterBuilder) {
        router.GET("/info",func (ctx *Context.HttpContext) {    // 支持Group方式
            ctx.JSON(200, Context.M{"info": "ok"})
        })
    }).Build().Run()       //默認端口號 :8080
}

實現進度

標準功能

  • [X] 打印Logo和日誌(YoyoGo)
  • [X] 統一程序輸入參數和環境變量 (YoyoGo)
  • [X] 簡單路由器綁定句柄功能
  • [X] HttpContext 上下文封裝(請求,響應)
  • [X] 靜態文件端點(靜態文件服務器)
  • [X] JSON 序列化結構(Context.M)
  • [X] 獲取請求文件並保存
  • [X] 獲取請求數據(form-data,x-www-form-urlencoded,Json ,XML,Protobuf 等)
  • [X] Http 請求的綁定模型(Url, From,JSON,XML,Protobuf)

響應渲染功能

  • [X] Render Interface
  • [X] JSON Render
  • [X] JSONP Render
  • [X] Indented Json Render
  • [X] Secure Json Render
  • [X] Ascii Json Render
  • [X] Pure Json Render
  • [X] Binary Data Render
  • [X] TEXT
  • [X] Protobuf
  • [X] MessagePack
  • [X] XML
  • [X] YAML
  • [X] File
  • [X] Image
  • [X] Template
  • [X] Auto formater Render

中間件

  • [X] Logger
  • [X] StaticFile
  • [X] Router Middleware
  • [ ] Session
  • [ ] CORS
  • [ ] GZip
  • [X] Binding
  • [ ] Binding Valateion

路由

  • [x] GET,POST,HEAD,PUT,DELETE 方法支持
  • [x] 路由解析樹與表達式支持
  • [x] RouteData路由數據 (/api/:version/) 與 Binding的集成
  • [x] 路由組功能
  • [ ] MVC默認模板功能
  • [ ] 路由過濾器 Filter

MVC

  • [x] 路由請求觸發Controller&Action
  • [X] Action方法參數綁定
  • [ ] 內部對象的DI化
  • [ ] 關鍵對象的參數傳遞

Dependency injection

  • [X] 抽象集成第三方DI框架
  • [X] MVC模式集成
  • [X] 框架級的DI支持功能

擴展

  • [ ] 配置
  • [ ] WebSocket
  • [ ] JWT
  • [ ] swagger
  • [ ] GRpc
  • [ ] OAuth2
  • [ ] Prometheus
  • [ ] 安全

進階範例

package main
import ...

func main() {
	webHost := CreateCustomWebHostBuilder().Build()
	webHost.Run()
}

// 自定義HostBuilder並支持 MVC 和 自動參數綁定功能,簡單情況也可以直接使用CreateDefaultBuilder 。
func CreateCustomBuilder() *Abstractions.HostBuilder {
	return YoyoGo.NewWebHostBuilder().
		SetEnvironment(Context.Prod).
		UseFastHttp().
		//UseServer(YoyoGo.DefaultHttps(":8080", "./Certificate/server.pem", "./Certificate/server.key")).
		Configure(func(app *YoyoGo.WebApplicationBuilder) {
			app.UseStatic("Static")
			app.UseEndpoints(registerEndpointRouterConfig)
			app.UseMvc(func(builder *Mvc.ControllerBuilder) {
				builder.AddController(contollers.NewUserController)
			})
		}).
		ConfigureServices(func(serviceCollection *DependencyInjection.ServiceCollection) {
			serviceCollection.AddTransientByImplements(models.NewUserAction, new(models.IUserAction))
		}).
		OnApplicationLifeEvent(getApplicationLifeEvent)
}

//region endpoint 路由綁定函數
func registerEndpoints(router Router.IRouterBuilder) {
	router.GET("/error", func(ctx *Context.HttpContext) {
		panic("http get error")
	})

    //POST 請求: /info/:id ?q1=abc&username=123
	router.POST("/info/:id", func (ctx *Context.HttpContext) {
        qs_q1 := ctx.Query("q1")
        pd_name := ctx.Param("username")

        userInfo := &UserInfo{}
        
        _ = ctx.Bind(userInfo)    // 手動綁定請求對象

        strResult := fmt.Sprintf("Name:%s , Q1:%s , bind: %s", pd_name, qs_q1, userInfo)

        ctx.JSON(200, Std.M{"info": "hello world", "result": strResult})
    })

    // 路由組功能實現綁定 GET 請求:  /v1/api/info
	router.Group("/v1/api", func(router *Router.RouterGroup) {
		router.GET("/info", func (ctx *Context.HttpContext) {
	        ctx.JSON(200, Std.M{"info": "ok"})
        })
	})
    
    // GET 請求: HttpContext.RequiredServices獲取IOC對象
	router.GET("/ioc", func (ctx *Context.HttpContext) {
        var userAction models.IUserAction
        _ = ctx.RequiredServices.GetService(&userAction)
        ctx.JSON(200, Std.M{"info": "ok " + userAction.Login("zhang")})
    })
}

//endregion

//region 請求對象
type UserInfo struct {
	UserName string `param:"username"`
	Number   string `param:"q1"`
	Id       string `param:"id"`
}

// ----------------------------------------- MVC 定義 ------------------------------------------------------

// 定義Controller
type UserController struct {
	*Controller.ApiController
	userAction models.IUserAction    // IOC 對象參數
}

// 構造器依賴注入
func NewUserController(userAction models.IUserAction) *UserController {
	return &UserController{userAction: userAction}
}

// 請求對象的參數化綁定
type RegiserRequest struct {
	Controller.RequestParam
	UserName string `param:"username"`
	Password string `param:"password"`
}

// Register函數自動綁定參數
func (this *UserController) Register(ctx *Context.HttpContext, request *RegiserRequest) ActionResult.IActionResult {
	result := Controller.ApiResult{Success: true, Message: "ok", Data: request}
	return ActionResult.Json{Data: result}
}

// use userAction interface by ioc  
func (this *UserController) GetInfo() Controller.ApiResult {
	return this.OK(this.userAction.Login("zhang"))
}


// Web程序的開始與停止事件
func fireApplicationLifeEvent(life *YoyoGo.ApplicationLife) {
	printDataEvent := func(event YoyoGo.ApplicationEvent) {
		fmt.Printf("[yoyogo] Topic: %s; Event: %v\n", event.Topic, event.Data)
	}
	for {
		select {
		case ev := <-life.ApplicationStarted:
			go printDataEvent(ev)
		case ev := <-life.ApplicationStopped:
			go printDataEvent(ev)
			break
		}
	}
}

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

※新北清潔公司,居家、辦公、裝潢細清專業服務

重學 Java 設計模式:實戰備忘錄模式「模擬互聯網系統上線過程中,配置文件回滾場景」

作者:小傅哥
博客:https://bugstack.cn – 原創系列專題文章

沉澱、分享、成長,讓自己和他人都能有所收穫!

一、前言

實現不了是研發的借口?

實現不了,有時候是功能複雜度較高難以實現,有時候是工期較短實現不完。而編碼的行為又是一個不太好量化的過程,同樣一個功能每個人的實現方式不一樣,遇到開發問題解決問題的速度也不一樣。除此之外還很不好給產品解釋具體為什麼要這個工期時間,這就像蓋樓的圖紙最終要多少水泥砂漿一樣。那麼這時研發會盡可能的去通過一些經驗,制定流程規範、設計、開發、評審等,確定一個可以完成的時間範圍,又避免風險的時間點后。再被壓縮,往往會出一些矛盾點,能壓縮要解釋為什麼之前要那麼多時間,不能壓縮又有各方不斷施加的壓力。因此有時候不一定是借口,是要考慮如何讓整個團隊健康的發展。

鼓勵有時比壓力要重要!

在學習的過程中,很多時候我們聽到的都是,你要怎樣,怎樣,你瞧瞧誰誰誰,哪怕今天聽不到這樣的聲音了,但因為曾經反覆聽到過而導致內心抗拒。雖然也知道自己要去學,但是很難堅持,學着學着就沒有了方向,看到還有那麼多不會的就更慌了,以至於最後心態崩了,更不願意學。其實程序員的壓力並不小,想成長几乎是需要一直的學習,就像似乎再也不敢說精通java了一樣,知識量實在是隨着學習的深入,越來越深,越來越廣。所以需要,開心學習,快樂成長!

臨陣的你好像一直很着急!

經常的聽到;老師明天就要了你幫我弄弄吧、你給我寫一下完事我就學這次着急、現在這不是沒時間學嗎快給我看看。其實看到的類似的還有很多,很納悶你的着急怎麼來的,不太可能,人在家中坐,禍從天上落。老師怎麼就那個時間找你了,老闆怎麼就今天管你要了,還不是日積月累你沒有學習,臨時抱佛腳亂着急!即使後來真的有人幫你了,但最好不要放鬆,要儘快學會,躲得過初一還有初二呢!

二、開發環境

  1. JDK 1.8
  2. Idea + Maven
  3. 涉及工程一個,可以通過關注公眾號:bugstack蟲洞棧,回復源碼下載獲取(打開獲取的鏈接,找到序號18)
工程 描述
itstack-demo-design-17-00 開發配置文件備忘錄

三、備忘錄模式介紹

備忘錄模式是以可以恢復或者說回滾,配置、版本、悔棋為核心功能的設計模式,而這種設計模式屬於行為模式。在功能實現上是以不破壞原對象為基礎增加備忘錄操作類,記錄原對象的行為從而實現備忘錄模式。

這個設計在我們平常的生活或者開發中也是比較常見的,比如:後悔葯、孟婆湯(一下回滾到0),IDEA編輯和撤銷、小霸王遊戲機存檔。當然還有我們非常常見的Photoshop,如下;

四、案例場景模擬

在本案例中我們模擬系統在發布上線的過程中記錄線上配置文件用於緊急回滾

在大型互聯網公司系統的發布上線一定是易用、安全、可處理緊急狀況的,同時為了可以隔離線上和本地環境,一般會把配置文件抽取出來放到線上,避免有人誤操作導致本地的配置內容發布出去。同時線上的配置文件也會在每次變更的時候進行記錄,包括;版本號、時間、MD5、內容信息和操作人。

在後續上線時如果發現緊急問題,系統就會需要回滾操作,如果執行回滾那麼也可以設置配置文件是否回滾。因為每一個版本的系統可能會隨着帶着一些配置文件的信息,這個時候就可以很方便的讓系統與配置文件一起回滾操作。

我們接下來就使用備忘錄模式,模擬如何記錄配置文件信息。實際的使用過程中還會將信息存放到庫中進行保存,這裏暫時只是使用內存記錄。

五、備忘錄模式記錄配置文件版本信息

備忘錄的設計模式實現方式,重點在於不更改原有類的基礎上,增加備忘錄類存放記錄。可能平時雖然不一定非得按照這個設計模式的代碼結構來實現自己的需求,但是對於功能上可能也完成過類似的功能,記錄系統的信息。

除了現在的這個案例外,還可以是運營人員在後台erp創建活動對信息的記錄,方便運營人員可以上下修改自己的版本,而不至於因為誤操作而丟失信息。

1. 工程結構

itstack-demo-design-17-00
└── src
    ├── main
    │   └── java
    │       └── org.itstack.demo.design
    │           ├── Admin.java
    │           ├── ConfigFile.java
    │           ├── ConfigMemento.java
    │           └── ConfigOriginator.java
    └── test
        └── java
            └── org.itstack.demo.design.test
                └── ApiTest.java

備忘錄模式模型結構

  • 以上是工程結構的一個類圖,其實相對來說並不複雜,除了原有的配置類(ConfigFile)以外,只新增加了三個類。
  • ConfigMemento:備忘錄類,相當於是對原有配置類的擴展
  • ConfigOriginator:記錄者類,獲取和返回備忘錄類對象信息
  • Admin:管理員類,用於操作記錄備忘信息,比如你一些列的順序執行了什麼或者某個版本下的內容信息

2. 代碼實現

2.1 配置信息類

public class ConfigFile {

    private String versionNo; // 版本號
    private String content;   // 內容
    private Date dateTime;    // 時間
    private String operator;  // 操作人
    
    // ...get/set
}
  • 配置類可以是任何形式的,這裏只是簡單的描述了一個基本的配置內容信息。

2.2 備忘錄類

public class ConfigMemento {

    private ConfigFile configFile;

    public ConfigMemento(ConfigFile configFile) {
        this.configFile = configFile;
    }

    public ConfigFile getConfigFile() {
        return configFile;
    }

    public void setConfigFile(ConfigFile configFile) {
        this.configFile = configFile;
    }
    
}
  • 備忘錄是對原有配置類的擴展,可以設置和獲取配置信息。

2.3 記錄者類

public class ConfigOriginator {

    private ConfigFile configFile;

    public ConfigFile getConfigFile() {
        return configFile;
    }

    public void setConfigFile(ConfigFile configFile) {
        this.configFile = configFile;
    }

    public ConfigMemento saveMemento(){
        return new ConfigMemento(configFile);
    }

    public void getMemento(ConfigMemento memento){
        this.configFile = memento.getConfigFile();
    }

}
  • 記錄者類除了對ConfigFile配置類增加了獲取和設置方法外,還增加了保存saveMemento()、獲取getMemento(ConfigMemento memento)。
  • saveMemento:保存備忘錄的時候會創建一個備忘錄信息,並返回回去,交給管理者處理。
  • getMemento:獲取的之後並不是直接返回,而是把備忘錄的信息交給現在的配置文件this.configFile,這部分需要注意。

2.4 管理員類

public class Admin {

    private int cursorIdx = 0;
    private List<ConfigMemento> mementoList = new ArrayList<ConfigMemento>();
    private Map<String, ConfigMemento> mementoMap = new ConcurrentHashMap<String, ConfigMemento>();

    public void append(ConfigMemento memento) {
        mementoList.add(memento);
        mementoMap.put(memento.getConfigFile().getVersionNo(), memento);
        cursorIdx++;
    }

    public ConfigMemento undo() {
        if (--cursorIdx <= 0) return mementoList.get(0);
        return mementoList.get(cursorIdx);
    }

    public ConfigMemento redo() {
        if (++cursorIdx > mementoList.size()) return mementoList.get(mementoList.size() - 1);
        return mementoList.get(cursorIdx);
    }

    public ConfigMemento get(String versionNo){
        return mementoMap.get(versionNo);
    }

}
  • 在這個類中主要實現的核心功能就是記錄配置文件信息,也就是備忘錄的效果,之後提供可以回滾和獲取的方法,拿到備忘錄的具體內容。
  • 同時這裏設置了兩個數據結構來存放備忘錄,實際使用中可以按需設置。List<ConfigMemento>、Map<String, ConfigMemento>。
  • 最後是提供的備忘錄操作方法;存放(append)、回滾(undo)、返回(redo)、定向獲取(get),這樣四個操作方法。

3. 測試驗證

3.1 編寫測試類

@Test
public void test() {
    Admin admin = new Admin();
    ConfigOriginator configOriginator = new ConfigOriginator();
    configOriginator.setConfigFile(new ConfigFile("1000001", "配置內容A=哈哈", new Date(), "小傅哥"));
    admin.append(configOriginator.saveMemento()); // 保存配置
    configOriginator.setConfigFile(new ConfigFile("1000002", "配置內容A=嘻嘻", new Date(), "小傅哥"));
    admin.append(configOriginator.saveMemento()); // 保存配置
    configOriginator.setConfigFile(new ConfigFile("1000003", "配置內容A=么么", new Date(), "小傅哥"));
    admin.append(configOriginator.saveMemento()); // 保存配置
    configOriginator.setConfigFile(new ConfigFile("1000004", "配置內容A=嘿嘿", new Date(), "小傅哥"));
    admin.append(configOriginator.saveMemento()); // 保存配置  

    // 歷史配置(回滾)
    configOriginator.getMemento(admin.undo());
    logger.info("歷史配置(回滾)undo:{}", JSON.toJSONString(configOriginator.getConfigFile()));  

    // 歷史配置(回滾)
    configOriginator.getMemento(admin.undo());
    logger.info("歷史配置(回滾)undo:{}", JSON.toJSONString(configOriginator.getConfigFile()));  

    // 歷史配置(前進)
    configOriginator.getMemento(admin.redo());
    logger.info("歷史配置(前進)redo:{}", JSON.toJSONString(configOriginator.getConfigFile()));   

    // 歷史配置(獲取)
    configOriginator.getMemento(admin.get("1000002"));
    logger.info("歷史配置(獲取)get:{}", JSON.toJSONString(configOriginator.getConfigFile()));
}
  • 這個設計模式的學習有一部分重點是體現在了單元測試類上,這裏包括了四次的信息存儲和備忘錄歷史配置操作。
  • 通過上面添加了四次配置后,下面分別進行操作是;回滾1次、再回滾1次,之後向前進1次,最後是獲取指定的版本配置。具體的效果可以參考測試結果。

3.2 測試結果

23:12:09.512 [main] INFO  org.itstack.demo.design.test.ApiTest - 歷史配置(回滾)undo:{"content":"配置內容A=嘿嘿","dateTime":159209829432,"operator":"小傅哥","versionNo":"1000004"}
23:12:09.514 [main] INFO  org.itstack.demo.design.test.ApiTest - 歷史配置(回滾)undo:{"content":"配置內容A=么么","dateTime":159209829432,"operator":"小傅哥","versionNo":"1000003"}
23:12:09.514 [main] INFO  org.itstack.demo.design.test.ApiTest - 歷史配置(前進)redo:{"content":"配置內容A=嘿嘿","dateTime":159209829432,"operator":"小傅哥","versionNo":"1000004"}
23:12:09.514 [main] INFO  org.itstack.demo.design.test.ApiTest - 歷史配置(獲取)get:{"content":"配置內容A=嘻嘻","dateTime":159320989432,"operator":"小傅哥","versionNo":"1000002"}

Process finished with exit code 0
  • 從測試效果上可以看到,歷史配置按照我們的指令進行了回滾和前進,以及最終通過指定的版本進行獲取,符合預期結果。

六、總結

  • 此種設計模式的方式可以滿足在不破壞原有屬性類的基礎上,擴充了備忘錄的功能。雖然和我們平時使用的思路是一樣的,但在具體實現上還可以細細品味,這樣的方式在一些源碼中也有所體現。
  • 在以上的實現中我們是將配置模擬存放到內存中,如果關機了會導致配置信息丟失,因為在一些真實的場景里還是需要存放到數據庫中。那麼此種存放到內存中進行回復的場景也不是沒有,比如;Photoshop、運營人員操作ERP配置活動,那麼也就是即時性的一般不需要存放到庫中進行恢復。另外如果是使用內存方式存放備忘錄,需要考慮存儲問題,避免造成內存大量消耗。
  • 設計模式的學習都是為了更好的寫出可擴展、可管理、易維護的代碼,而這個學習的過程需要自己不斷的嘗試實際操作,理論的知識與實際結合還有很長一段距離。切記多多上手!

七、推薦閱讀

  • 1. 重學 Java 設計模式:實戰工廠方法模式「多種類型商品不同接口,統一發獎服務搭建場景」
  • 2. 重學 Java 設計模式:實戰原型模式「上機考試多套試,每人題目和答案亂序排列場景」
  • 3. 重學 Java 設計模式:實戰橋接模式「多支付渠道(微信、支付寶)與多支付模式(刷臉、指紋)場景」
  • 4. 重學 Java 設計模式:實戰組合模式「營銷差異化人群發券,決策樹引擎搭建場景」
  • 5. 重學 Java 設計模式:實戰外觀模式「基於SpringBoot開發門面模式中間件,統一控制接口白名單場景」
  • 6. 重學 Java 設計模式:實戰享元模式「基於Redis秒殺,提供活動與庫存信息查詢場景」
  • 7. 重學 Java 設計模式:實戰備忘錄模式「模擬互聯網系統上線過程中,配置文件回滾場景」

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※評比南投搬家公司費用收費行情懶人包大公開

※幫你省時又省力,新北清潔一流服務好口碑

dubbo源碼解析之負載均衡

在分佈式系統中,負載均衡是必不可少的一個模塊,dubbo 中提供了五種負載均衡的實現,在閱讀這塊源碼之前,建議先學習負載均衡的基礎知識。把看源碼當做一個印證自己心中所想的過程,這樣會得到事半功倍的效果

以下源碼分析基於 dubbo 2.77 版本

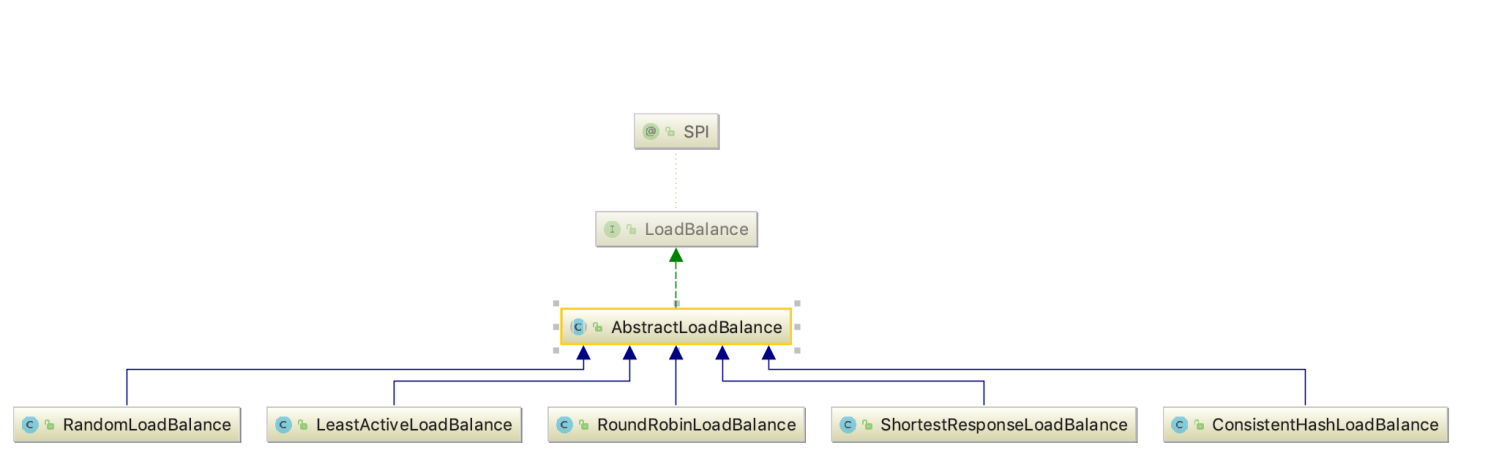
類結構

先來看一下這一塊的類結構圖

大部分算法都是在權重比的基礎上進行負載均衡,RandomLoadBalance 是默認的算法

類型 描述 是否默認 是否加權
RandomLoadBalance 隨機 是 是,默認權重相同
RoundRobinLoadBalance 輪訓 否 是,默認權重相同
LeastActiveLoadBalance 最少活躍數調用 否 不完全是,默認權重相同,僅在活躍數相同時按照權重比隨機
ConsistentHashLoadBalance 一致性hash 否 否
ShortestResponseLoadBalance 最短時間調用 否 不完全是,默認權重相同,僅在預估調用相同時按照權重比隨機

AbstractLoadBalance

AbstractLoadBalance 對一些通用的操作做了處理,是一個典型的模板方法模式的實現

select 方法只做一些簡單的範圍校驗,具體的實現有子類通過 doSelect 方法去實現

    @Override
    public <T> Invoker<T> select(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        if (CollectionUtils.isEmpty(invokers)) {
            return null;
        }
        if (invokers.size() == 1) {
            return invokers.get(0);
        }
        return doSelect(invokers, url, invocation);
    }

getWeight方法封裝了獲取一個調用者的權重值的方法,並加入了預熱處理

    int getWeight(Invoker<?> invoker, Invocation invocation) {
        int weight;
        URL url = invoker.getUrl();
        // Multiple registry scenario, load balance among multiple registries.
        // 註冊中心不需要預熱
        if (REGISTRY_SERVICE_REFERENCE_PATH.equals(url.getServiceInterface())) {
            weight = url.getParameter(REGISTRY_KEY + "." + WEIGHT_KEY, DEFAULT_WEIGHT);
        } else {
            // 獲取配置的權重值
            weight = url.getMethodParameter(invocation.getMethodName(), WEIGHT_KEY, DEFAULT_WEIGHT);
            if (weight > 0) {
                // 獲取服務提供者啟動時的時間戳
                long timestamp = invoker.getUrl().getParameter(TIMESTAMP_KEY, 0L);
                if (timestamp > 0L) {
                    //  獲取啟動時長
                    long uptime = System.currentTimeMillis() - timestamp;
                    // 當前時間小於服務提供者啟動時間,直接給一個最小權重1
                    if (uptime < 0) {
                        return 1;
                    }
                    // 獲取預熱時間
                    int warmup = invoker.getUrl().getParameter(WARMUP_KEY, DEFAULT_WARMUP);
                    // 如果小於預熱時間,計算權重
                    if (uptime > 0 && uptime < warmup) {
                        weight = calculateWarmupWeight((int)uptime, warmup, weight);
                    }
                }
            }
        }
        // 取與零比較的最大值,保證不會出現負值權重
        return Math.max(weight, 0);
    }

calculateWarmupWeight 方法用來計算權重,保證隨着預熱時間的增加,權重逐漸達到設置的權重

    static int calculateWarmupWeight(int uptime, int warmup, int weight) {
        // 運行時間/(預熱時間/權重)
        int ww = (int) ( uptime / ((float) warmup / weight));
        // 保證計算的權重最小值是1,並且不能超過設置的權重
        return ww < 1 ? 1 : (Math.min(ww, weight));
    }

RandomLoadBalance

隨機調用是負載均衡算法中最常用的算法之一,也是 dubbo 的默認負載均衡算法,實現起來也較為簡單
隨機調用的缺點是在調用量比較少的情況下,有可能出現不均勻的情況

	@Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // Number of invokers
        int length = invokers.size();
        // Every invoker has the same weight?
        boolean sameWeight = true;
        // the weight of every invokers
        int[] weights = new int[length];
        // the first invoker's weight
        int firstWeight = getWeight(invokers.get(0), invocation);
        weights[0] = firstWeight;
        // The sum of weights
        int totalWeight = firstWeight;
        for (int i = 1; i < length; i++) {
            int weight = getWeight(invokers.get(i), invocation);
            // save for later use
            // 依次把權重放到數組對應的位置
            weights[i] = weight;
            // Sum
            // 累加權重
            totalWeight += weight;
            // 如果出現權重不一樣的,sameWeight 設為false
            if (sameWeight && weight != firstWeight) {
                sameWeight = false;
            }
        }
        if (totalWeight > 0 && !sameWeight) {
            // If (not every invoker has the same weight & at least one invoker's weight>0), select randomly based on totalWeight.
            // 在總權重裏面隨機選擇一個偏移量
            int offset = ThreadLocalRandom.current().nextInt(totalWeight);
            // Return a invoker based on the random value.
            for (int i = 0; i < length; i++) {
                offset -= weights[i];
                // 依次用偏移量減去當前權重,小於0說明選中
                if (offset < 0) {
                    return invokers.get(i);
                }
            }
        }
        // If all invokers have the same weight value or totalWeight=0, return evenly.
        // 如果所有的調用者有同樣的權重或者總權重為0,則隨機選擇一個
        return invokers.get(ThreadLocalRandom.current().nextInt(length));
    }

RoundRobinLoadBalance

輪訓算法避免了隨機算法在小數據量產生的不均勻問題,我個人認為,輪訓算法可以理解為隨機算法的一種特例,在大量請求的情況下,從調用次數看,和隨機並無區別,主要區別在於短時間內的調用分配上

加權輪訓算法給人的直觀感受,實現起來並不複雜,算出一權重總量,依次調用即可
例如A,B,C 三個節點的權重比依次 1,200,1000,如果依次輪訓調用,就會出現先調用A 10 次,再調用B 200次,最後調用 C 1000次,不斷重複前面的過程
但這樣有一個問題,我們可以發現C 被練習調用1000次,會對C瞬間造成很大的壓力

dubbo的新版本採用的是平滑加權輪詢算法,輪訓的過程中節點之間穿插調用,可以避免了上面說的問題,因此這塊源碼看起來會稍有難度

輪訓算法 在dubbo 在升級的過程中,做過多次優化,有興趣的可以去了解下該算法的優化過程,也是件很有意思的事情

public class RoundRobinLoadBalance extends AbstractLoadBalance {
    public static final String NAME = "roundrobin";

    private static final int RECYCLE_PERIOD = 60000;

    protected static class WeightedRoundRobin {
        // 權重值
        private int weight;
        // 當前權重值
        private AtomicLong current = new AtomicLong(0);
        // 最後一次使用該對象時間
        private long lastUpdate;

        public int getWeight() {
            return weight;
        }

        public void setWeight(int weight) {
            this.weight = weight;
            current.set(0);
        }

        // 獲取自增權重基數的當前權重值
        public long increaseCurrent() {
            return current.addAndGet(weight);
        }

        public void sel(int total) {
            current.addAndGet(-1 * total);
        }

        public long getLastUpdate() {
            return lastUpdate;
        }

        // 設置最後一次更新時間戳
        public void setLastUpdate(long lastUpdate) {
            this.lastUpdate = lastUpdate;
        }
    }

    private ConcurrentMap<String, ConcurrentMap<String, WeightedRoundRobin>> methodWeightMap = new ConcurrentHashMap<String, ConcurrentMap<String, WeightedRoundRobin>>();

    /**
     * get invoker addr list cached for specified invocation
     * <p>
     * <b>for unit test only</b>
     *
     * @param invokers
     * @param invocation
     * @return
     */
    protected <T> Collection<String> getInvokerAddrList(List<Invoker<T>> invokers, Invocation invocation) {
        String key = invokers.get(0).getUrl().getServiceKey() + "." + invocation.getMethodName();
        Map<String, WeightedRoundRobin> map = methodWeightMap.get(key);
        if (map != null) {
            return map.keySet();
        }
        return null;
    }

    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // {group}/{interfaceName}:{version} + methoName 獲取當前消費者的唯一標示
        String key = invokers.get(0).getUrl().getServiceKey() + "." + invocation.getMethodName();
        // 獲取對應的 WeightedRoundRobin map,如果不存在,new 一個map放進去
        ConcurrentMap<String, WeightedRoundRobin> map = methodWeightMap.computeIfAbsent(key, k -> new ConcurrentHashMap<>());
        int totalWeight = 0;
        long maxCurrent = Long.MIN_VALUE;
        long now = System.currentTimeMillis();
        Invoker<T> selectedInvoker = null;
        WeightedRoundRobin selectedWRR = null;
        for (Invoker<T> invoker : invokers) {
            // 服務提供者在的唯一標識
            String identifyString = invoker.getUrl().toIdentityString();
            int weight = getWeight(invoker, invocation);
            WeightedRoundRobin weightedRoundRobin = map.computeIfAbsent(identifyString, k -> {
                WeightedRoundRobin wrr = new WeightedRoundRobin();
                wrr.setWeight(weight);
                return wrr;
            });
            // 如果權重改變了,更新 weightedRoundRobin 裏面權重的值
            if (weight != weightedRoundRobin.getWeight()) {
                //weight changed
                weightedRoundRobin.setWeight(weight);
            }
            // 當前權重自增自身權重
            long cur = weightedRoundRobin.increaseCurrent();
            // 設置最後一次更新時間戳
            weightedRoundRobin.setLastUpdate(now);
            // 如果當前權重大於最大當前權重
            if (cur > maxCurrent) {
                // 重置最大當前權重的值
                maxCurrent = cur;
                // 把當前提供者設為選中的提供者
                selectedInvoker = invoker;
                // 把當前輪訓權重實例設為選中
                selectedWRR = weightedRoundRobin;
            }
            // 累計總權重
            totalWeight += weight;
        }
        // 提供者有變化
        if (invokers.size() != map.size()) {
            // 超過60s沒有使用,刪除掉
            map.entrySet().removeIf(item -> now - item.getValue().getLastUpdate() > RECYCLE_PERIOD);
        }
        if (selectedInvoker != null) {
            // 減去總權重
            // 關於這個地方為什麼要減去總權重,是一個很容易造成迷惑的地方
            // 我的理解:每一次調用循環 每個提供者的 當前權重 都會自增自己的權重
            // 因此在選中后(只有一個被選中),再減去總權重,正好保證了所有 WeightedRoundRobin 中當前權重之和永遠等於0
            selectedWRR.sel(totalWeight);
            return selectedInvoker;
        }
        // 理論上不會走到這個地方
        // should not happen here
        return invokers.get(0);
    }

}

LeastActiveLoadBalance

最少活躍數調用算法是指在調用時判斷此時每個服務提供者此時正在處理的請求個數,選取最小的調用

dubbo 在實現該算法時的具體邏輯如下

  1. 選取所有活躍數最少的提供者
  2. 如果只有一個,直接返回
  3. 如果權重不同,加權隨機選擇一個
  4. 如果權重相同,隨機選擇一個
    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // Number of invokers
        int length = invokers.size();
        // The least active value of all invokers
        // 最少活躍數量
        int leastActive = -1;
        // The number of invokers having the same least active value (leastActive)
        // 有同樣活躍值的提供者數量
        int leastCount = 0;
        // The index of invokers having the same least active value (leastActive)
        int[] leastIndexes = new int[length];
        // the weight of every invokers
        // 每一個提供者的權重
        int[] weights = new int[length];
        // The sum of the warmup weights of all the least active invokers
        // 最少活躍提供者的總權重
        int totalWeight = 0;
        // The weight of the first least active invoker
        int firstWeight = 0;
        // Every least active invoker has the same weight value?
        // 所有的最少活躍提供者是否擁有同樣的權重值
        boolean sameWeight = true;


        // Filter out all the least active invokers
        for (int i = 0; i < length; i++) {
            Invoker<T> invoker = invokers.get(i);
            // Get the active number of the invoker
            // 活躍數量
            int active = RpcStatus.getStatus(invoker.getUrl(), invocation.getMethodName()).getActive();
            // Get the weight of the invoker's configuration. The default value is 100.
            // 獲取權重值
            int afterWarmup = getWeight(invoker, invocation);
            // save for later use
            // 保存權重留着後面用
            weights[i] = afterWarmup;
            // If it is the first invoker or the active number of the invoker is less than the current least active number
            // 如果是第一個提供者,或者當前活躍數量比最少的少
            if (leastActive == -1 || active < leastActive) {
                // Reset the active number of the current invoker to the least active number
                // 重置最少活躍數量
                leastActive = active;
                // Reset the number of least active invokers
                // 重置最少活躍提供者的數量
                leastCount = 1;
                // Put the first least active invoker first in leastIndexes
                // 把最少活躍提供者的索引保存起來
                leastIndexes[0] = i;
                // Reset totalWeight
                // 重置總權重
                totalWeight = afterWarmup;
                // Record the weight the first least active invoker
                // 記錄第一個最少活躍提供者的權重
                firstWeight = afterWarmup;
                // Each invoke has the same weight (only one invoker here)
                // 每個最少活躍提供者是否有同樣的權重???
                sameWeight = true;
                // If current invoker's active value equals with leaseActive, then accumulating.
                // 如果當前活躍數量等於最少活躍數量
            } else if (active == leastActive) {
                // Record the index of the least active invoker in leastIndexes order
                // 最少活躍提供者的索引依次放入 leastIndexes
                leastIndexes[leastCount++] = i;
                // Accumulate the total weight of the least active invoker
                // 累計最少活躍提供者的總權重
                totalWeight += afterWarmup;
                // If every invoker has the same weight?
                // 如果當前權重和第一個最少活躍的權重不同,sameWeight 設為false
                if (sameWeight && afterWarmup != firstWeight) {
                    sameWeight = false;
                }
            }
        }
        // Choose an invoker from all the least active invokers
        // 最少活躍提供者只有一個,直接返回
        if (leastCount == 1) {
            // If we got exactly one invoker having the least active value, return this invoker directly.
            return invokers.get(leastIndexes[0]);
        }
        // 如擁有不同的權重,在權重的基礎上隨機選取一個,可以參考 RandomLoadBalance,有同樣的寫法
        if (!sameWeight && totalWeight > 0) {
            // If (not every invoker has the same weight & at least one invoker's weight>0), select randomly based on 
            // totalWeight.
            int offsetWeight = ThreadLocalRandom.current().nextInt(totalWeight);
            // Return a invoker based on the random value.
            for (int i = 0; i < leastCount; i++) {
                int leastIndex = leastIndexes[i];
                offsetWeight -= weights[leastIndex];
                if (offsetWeight < 0) {
                    return invokers.get(leastIndex);
                }
            }
        }
        // 權重相同,隨機選取一個
        // If all invokers have the same weight value or totalWeight=0, return evenly.
        return invokers.get(leastIndexes[ThreadLocalRandom.current().nextInt(leastCount)]);
    }

ShortestResponseLoadBalance

最短時間調用調用算法是指預估出來每個處理完請求的提供者所需時間,然後又選擇最少最短時間的提供者進行調用,整體處理邏輯和最少活躍數算法基本相似

dubbo 在實現該算法時的具體邏輯如下

  1. 選取所有預估處理時間最短的提供者
  2. 如果只有一個,直接返回
  3. 如果權重不同,加權隨機選擇一個
  4. 如果權重相同,隨機選擇一個
    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // Number of invokers
        int length = invokers.size();
        // Estimated shortest response time of all invokers
        // 最少響應時間
        long shortestResponse = Long.MAX_VALUE;
        // The number of invokers having the same estimated shortest response time
        // 最少響應時間的提供者數量
        int shortestCount = 0;
        // The index of invokers having the same estimated shortest response time
        int[] shortestIndexes = new int[length];
        // the weight of every invokers
        int[] weights = new int[length];
        // The sum of the warmup weights of all the shortest response  invokers
        // 最少響應時間的提供者的總權重
        int totalWeight = 0;
        // The weight of the first shortest response invokers
        // 第一個最少響應時間的權重
        int firstWeight = 0;
        // Every shortest response invoker has the same weight value?
        // 所有的最少響應時間提供者是否擁有同樣的權重值
        boolean sameWeight = true;

        // Filter out all the shortest response invokers
        for (int i = 0; i < length; i++) {
            Invoker<T> invoker = invokers.get(i);
            RpcStatus rpcStatus = RpcStatus.getStatus(invoker.getUrl(), invocation.getMethodName());
            // Calculate the estimated response time from the product of active connections and succeeded average elapsed time.
            //  平均響應成功時間
            long succeededAverageElapsed = rpcStatus.getSucceededAverageElapsed();
            // 活躍的連接連接數量
            int active = rpcStatus.getActive();
            // 預估響應時間
            long estimateResponse = succeededAverageElapsed * active;
            // 獲取權重值
            int afterWarmup = getWeight(invoker, invocation);
            // 保存權重留着後面用
            weights[i] = afterWarmup;
            // Same as LeastActiveLoadBalance
            // 如果預估時間小於最少的響應時間
            if (estimateResponse < shortestResponse) {
                // 重置最少響應時間
                shortestResponse = estimateResponse;
                // 最少響應時間的提供者數量設為1
                shortestCount = 1;
                // 保存提供者下標
                shortestIndexes[0] = i;
                // 重置最少響應時間的提供者的總權重
                totalWeight = afterWarmup;
                // 重置第一個最少響應時間的權重
                firstWeight = afterWarmup;
                sameWeight = true;
                // 如果當前最少響應時間等於最少響應時間
            } else if (estimateResponse == shortestResponse) {
                // 最少最少響應時間的下標依次放入 shortestIndexes
                shortestIndexes[shortestCount++] = i;
                // 累計最少響應時間的總權重
                totalWeight += afterWarmup;
                // 如果當前權重和第一個最少響應時間的權重不同,sameWeight 設為false
                if (sameWeight && i > 0
                        && afterWarmup != firstWeight) {
                    sameWeight = false;
                }
            }
        }
        // 最少最少響應時間只有一個,直接返回
        if (shortestCount == 1) {
            return invokers.get(shortestIndexes[0]);
        }
        // 如擁有不同的權重,在權重的基礎上隨機選取一個,可以參考 RandomLoadBalance,有同樣的寫法
        if (!sameWeight && totalWeight > 0) {
            int offsetWeight = ThreadLocalRandom.current().nextInt(totalWeight);
            for (int i = 0; i < shortestCount; i++) {
                int shortestIndex = shortestIndexes[i];
                offsetWeight -= weights[shortestIndex];
                if (offsetWeight < 0) {
                    return invokers.get(shortestIndex);
                }
            }
        }
        // 權重相同,隨機選取一個
        return invokers.get(shortestIndexes[ThreadLocalRandom.current().nextInt(shortestCount)]);
    }

ConsistentHashLoadBalance

一致性hash算法是一種廣泛應用與分佈式緩存中的算法,該算法的優勢在於新增和刪除節點后,只有少量請求發生變動,大部分請求仍舊映射到原來的節點
為了防止節點過少,造成節點分佈不均勻,一般採用虛擬節點的方式,dubbo默認的是160個虛擬節點

網上關於一致性hash算法的文章有很多,這裏就不再多贅述,以下是dubbo中的實現,需要說明的是, 一致性hash算法中權重配置不起作用

    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        String methodName = RpcUtils.getMethodName(invocation);
        // {group}/{interfaceName}:{version} + methoName 獲取當前消費者的唯一標示
        String key = invokers.get(0).getUrl().getServiceKey() + "." + methodName;
        // using the hashcode of list to compute the hash only pay attention to the elements in the list
        int invokersHashCode = invokers.hashCode();
        // 獲取當前消費者的一致性hash選擇器
        ConsistentHashSelector<T> selector = (ConsistentHashSelector<T>) selectors.get(key);
        // 如果 selector 還沒初始化,或者 invokers 已經變化,重新初始化 selector
        if (selector == null || selector.identityHashCode != invokersHashCode) {
            selectors.put(key, new ConsistentHashSelector<T>(invokers, methodName, invokersHashCode));
            selector = (ConsistentHashSelector<T>) selectors.get(key);
        }
        return selector.select(invocation);
    }
    // 一致性hash選擇器
    private static final class ConsistentHashSelector<T> {

        // 存儲hash環的數據結構 節點 -> 提供者
        private final TreeMap<Long, Invoker<T>> virtualInvokers;

        // 虛擬節點數量
        private final int replicaNumber;

        // 用來標示所有提供者是唯一標示
        private final int identityHashCode;
        // 用來存儲計算hash值參數下標的數組,例如計算第一個和第三個參數 該數組為[0,2]
        private final int[] argumentIndex;

        ConsistentHashSelector(List<Invoker<T>> invokers, String methodName, int identityHashCode) {
            this.virtualInvokers = new TreeMap<Long, Invoker<T>>();
            this.identityHashCode = identityHashCode;
            URL url = invokers.get(0).getUrl();
            // 虛擬節點數量,默認 160
            this.replicaNumber = url.getMethodParameter(methodName, HASH_NODES, 160);
            // 默認只對第一個參數進行hash
            String[] index = COMMA_SPLIT_PATTERN.split(url.getMethodParameter(methodName, HASH_ARGUMENTS, "0"));
            argumentIndex = new int[index.length];
            for (int i = 0; i < index.length; i++) {
                argumentIndex[i] = Integer.parseInt(index[i]);
            }
            for (Invoker<T> invoker : invokers) {
                String address = invoker.getUrl().getAddress();
                // 關於這個地方為什麼要除以4,我理解的是md5後為16字節的數組,計算hash值只需要用到四個字節,所以可以用四次
                // 因此除以4,算是一個性能優化點
                for (int i = 0; i < replicaNumber / 4; i++) {
                    // md5, 獲得一個長度為16的字節數組
                    byte[] digest = md5(address + i);
                    for (int h = 0; h < 4; h++) {
                        // 如果h=0,則用第0,1,2,3四個字節進行位運算,得出一個0-2^32-1的值
                        // 如果h=1,則用第4,5,6,7四個字節進行位運算,得出一個0-2^32-1的值
                        // 如果h=2,則用第8,9,10,11四個字節進行位運算,得出一個0-2^32-1的值
                        // 如果h=3,則用第12,13,14,15四個字節進行位運算,得出一個0-2^32-1的值
                        long m = hash(digest, h);
                        virtualInvokers.put(m, invoker);
                    }
                }
            }
        }

        public Invoker<T> select(Invocation invocation) {
            String key = toKey(invocation.getArguments());
            byte[] digest = md5(key);
            return selectForKey(hash(digest, 0));
        }
        // 根據配置生成計算hash值的key
        private String toKey(Object[] args) {
            StringBuilder buf = new StringBuilder();
            for (int i : argumentIndex) {
                if (i >= 0 && i < args.length) {
                    buf.append(args[i]);
                }
            }
            return buf.toString();
        }

        private Invoker<T> selectForKey(long hash) {
            // 找到hash值在hash環上的位置
            // ceilingEntry 方法返回大於或者等於當前key的鍵值對
            Map.Entry<Long, Invoker<T>> entry = virtualInvokers.ceilingEntry(hash);
            // 如果返回為空,說明落在了hash環中2的32次方-1的最後,直接返回第一個
            if (entry == null) {
                entry = virtualInvokers.firstEntry();
            }
            return entry.getValue();
        }
        // 得出一個0-2^32-1的值, 四個字節組成一個長度為32位的二進制数字並轉化為long值
        private long hash(byte[] digest, int number) {
            return (((long) (digest[3 + number * 4] & 0xFF) << 24)
                    | ((long) (digest[2 + number * 4] & 0xFF) << 16)
                    | ((long) (digest[1 + number * 4] & 0xFF) << 8)
                    | (digest[number * 4] & 0xFF))
                    & 0xFFFFFFFFL;
        }

        private byte[] md5(String value) {
            MessageDigest md5;
            try {
                md5 = MessageDigest.getInstance("MD5");
            } catch (NoSuchAlgorithmException e) {
                throw new IllegalStateException(e.getMessage(), e);
            }
            md5.reset();
            byte[] bytes = value.getBytes(StandardCharsets.UTF_8);
            md5.update(bytes);
            return md5.digest();
        }

    }

總結

以上就是dubbo負載均衡源碼的全部解析,如果還是不明白,可以看下官方文檔的解析  
http://dubbo.apache.org/zh-cn/docs/source_code_guide/loadbalance.html

dubbo的負載均衡算法總體來說並不複雜,代碼寫的也很優雅,簡潔,看起來很舒服,而且有很多細節的處理值得稱讚,例如預熱處理,輪訓算法的平滑處理等。

我們平時使用時,可以根據自己的業務場景,選擇適合自己的算法,當然,一般情況下,默認的的隨機算法就能滿足我們的日常需求,而且隨機算法的性能足夠好。

如果覺得dubbo提供的五種算法都不能滿足自己的需求,還可以通過dubbo的SPI機制很方便的擴展自己的負載均衡算法。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

從0到1打造數據可信的數據產品:解析數據治理在過程可信變革中的運作流程

摘要:本文針對“數據牽引改進,工具固化規範”這一思路在業務團隊落地過程中的動作流程進行詳細闡述,並明確了支撐整個流程的關鍵角色定義和組織運作形式。

目的

為實現雲服務開發的過程可信,需要基於數據對各個服務產品部的可信變革動作進行數據採集、進展可視、目標牽引、能力評估,最終用數據反映目標達成。與傳統的“基於數據晾曬驅動業務團隊改進,6+1指標度量”的運作方式有本質的區別,我們是基於統一的作業工具上產生的客觀數據呈現,識別研發過程中基本的流程斷裂點和質量缺失動作,和業務團隊達成一致的目標后,把大部分改進動作固話到作業工具中自動化承載,我們稱這個思路為“數據牽引改進,工具固化規範”,也就是我們不僅告訴業務團隊哪裡有問題,同時也要基於我們的作業工具,輔助業務團隊一起改進完善。

本文針對“數據牽引改進,工具固化規範”這一思路在業務團隊落地過程中的動作流程進行詳細闡述,並明確了支撐整個流程的關鍵角色定義和組織運作形式。

數據牽引改進,是指關注軟件交付過程中各種度量數據的收集、統計、分析和反饋,通過可視化的數據客觀反映整個研發過程的狀態,以全局視角分析系統約束點,並和業務團隊達成共識,提煉出客觀有效的改進目標;工具固化規範,針對識別出來的Gap點和重點問題進行分析,制定出可以在作業工具承載的模板規範,以及需要工程師行為做出改變的能力要求,並在作業工具上對這些規範要求的落地效果進行檢查,用數據度量改進效果。最後,對改進項目進行總結分享,打造學習型組織,不斷驅動持續改進和價值交付,牽引研發團隊模式和文化的轉變。

2020年的研發過程可信圍繞CleanCode、構建、開源、E2E追溯四個領域開展,這也是公司要求的可信變革中最基本、最重要、投入產出比最大的四個點。

整體流程說明

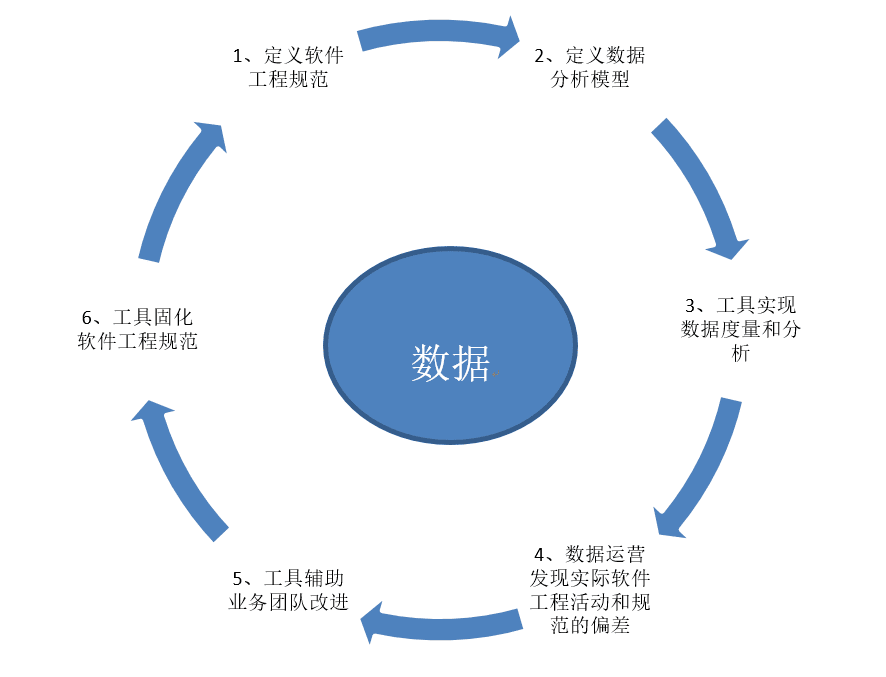
整個運作流程,圍繞數據,按照“定義軟件工程規範->定義數據分析模型->工具實現數據度量和分析->數據運營發現實際軟件工程活動和規範的偏差->工具輔助團隊改進->工具固化軟件工程規範”這個流程進行實施,並對最終效果進行階段性總結。隨着業務團隊能力的提升以及軟件工程規範性、開發模式的改變,對最初定義的軟件工程規範,會階段性的進行完善,循環往複、持續優化,最終讓業務團隊在遵守公司要求的研發過程可信規範的前提下,實現業務成功。

1) 定義軟件工程規範:圍繞公司可信變革的目標,BU對各個服務產品部的研發模式規範和能力要求,COE制定適合BU現狀的軟件工程規範;

2) 定義數據模型:COE針對制定的軟件工程規範,提煉出核心的、有針對性、可用工具度量的數據模型,並且和各個服務產品部達成一致;

3) 工具實現數據度量和分析:根據這幾個數據模型,數據分析工具自動從數據源進行採集、匯總、計算,並把結果呈現在數據看板上;業務團隊可以打開匯總數據,根據明細數據進行動作規範自檢和改進;

4) 數據運營發現實際軟件工程活動和規範的偏差:數據治理小組在實際運營過程中,分析度量指標的數據,識別業務團隊實際的軟件工程活動和要求規範不一致的Gap點和關鍵問題;

5) 工具輔助業務團隊改進:COE針對分析出來的Gap點和關鍵問題,制定相應的改進措施,作業工具承載流程規範模板化整改,並針對業務團隊的不規範行為,制定適合各個服務產品部的公約要求,促使業務團隊人員能力提升;

6) 工具固化軟件工程規範:針對業務團隊的公約要求,在作業工具上進行check,最終作業工具承載了整個軟件工程規範要求,以及融入到作業流程中的規範要求事前檢查。

三層數據分析模型

我們採用了三層數據分析模型,由作業工具自動採集用戶研發過程行為明細數據,數據分析工具進行准實時匯總計算呈現總體目標,三層數據系統性的輔助業務團隊系統性的識別研發過程中的不規範點和能力短板,讓業務團隊“知其然,知其所以然”。這三層數據模型是層層深入,迭代完善,下層支撐上層的關係。

第一層:目標、進展、結果數據分析;和公司可信變革目標牽引對齊,結合BU實際情況,形成BU的整體可信要求,並在數據分析看板上呈現各個服務產品部要達成的過程可信目標、每日的改進進展和最終完成情況;例如,對各個服務產品部要求達成CleanCode的目標。

第二層:詞法/語法分析數據;COE針對第一層的目標牽引,分解出來的具體實施環節的度量指標,只有這些分解的指標都完成,第一層的目標才達成。這一層數據的目的主要是圍繞幫助業務團隊分析自己的能力短板在哪裡,進行有針對性的改進指;通過打開匯總數據的層層下鑽,用明細數據來分析業務團隊在DevSecOps軟件工程規範流程中關鍵動作執行的缺失點,並針對性的制定改進規範要求,牽引作業工具或者業務團隊補齊該部分缺失動作;例如,CleanCode的過程可信目標達成,可以分解成:靜態檢查配置合規率、Committer合入保障率、代碼倉Clean三個目標,只有這三個目標達成,就可以認為CleanCode總體目標達成。

第三層:語義分析數據:COE打開第二層數據,不僅要看這些關鍵動過做沒做,還要看做的效果怎麼樣,最終效果體現在業務團隊的DevSecOps軟件工程規範提升;這一層的數據分析聚焦在防止為了指標而做第二層的數據,而是看業務團隊是否在真正參考BU制定的規範牽引的目標,提升業務交付過程中的效能、可信、質量能力,以及最終產生實際的業務效果。通過打開各個團隊的明細數據分析審視業務團隊執行的關鍵動作是否符合規範,是否在合適的階段點執行,執行效果是否有效;並階段性的總結和提煉經驗,形成知識資產固化到作業工具。例如,針對第二層的靜態檢查配置合規率,可以分解為:靜態檢查配置有效性和靜態檢查執行有效性。靜態檢查配置有效性,包括:檢查靜態檢查工具配置的數量、是否符合BU的配置規範,以及是否在代碼合入主幹master時進行了配置;靜態檢查執行有效性,主要看是否每一次MR提交時都執行靜態檢查、是否發現問題在研發活動的最早階段,攔截的問題的效果怎麼樣。只有第三層的動作度量都達成后,才可以說第二層的目標是達成的。

數據治理過程流程圖

為了實現“數據牽引改進,工具固化規範”這個目標,準確、一致、准實時的數據是核心關鍵,但因為數據採集不完整、業務團隊不規範、數據呈現維度不一致等原因,數據的準確性有一個不斷提升的過程,因此需要對各個層級展示的數據進行治理。整個數據治理過程中,由“業務團隊/作業工具/治理小組/數據分析工具(阿基米德)/COE”五個角色緊密配合,而且以年/半年為目標,不斷總結經驗,循環往複、持續優化的過程。

a) COE:和公司可信變革目標牽引對齊,結合BU能力現狀,形成BU的整體可信要求;

b) COE:針對BU的業務現狀,定義出適合BU現狀的軟件工程規範要求;業務團隊:和BU發布的各個領域的軟件工程規範牽引目標達成一致;

c) COE:針對規範分解出核心的度量指標,並制定度量數據模型;

d) 研發用戶:在使用作業工具進行研發活動;作業工具:承載了BU各個服務產品部在使用過程中沉澱的行為數據;

e) 數據分析(阿基米德):准實時接入作業工具的數據,展示各個服務產品部當前的研發能力現狀;

f) COE:和各個服務產品部達成一致,制定各個服務產品部的年度牽引目標;

g) 數據分析(阿基米德):用數據呈現各個服務產品部的牽引目標和能力現狀,統一數據口徑;呈現月/周/天的明細數據,以及支撐Gap分析和重點問題的數據視圖;

h) COE:根據牽引目標和能力現狀,分析Gap原因和關鍵問題;治理小組:在數據運營過程中,根據數據分析團隊當前的能力現狀是否和數據呈現一致;

i) 研發用戶:可以實時登錄數據工具(阿基米德)進行查看各個層級的明細數據;

j) 治理小組:根據准實時進展數據,分析當前團隊研發過程中的實際問題,並匯總給COE;

k) COE:結合細粒度的分析數據、以及治理小組匯總出來的各個服務產品部的實際問題,制定規範和改進措施,包括作業工具的規範和研發用戶的動作行為公約;

l) 作業工具:承載作業工具上落地的規範要求;治理小組:作為接口人,承接研發工程師的行為規範公約,結合各個服務產品部實際情況來負責落地;

m) 研發用戶:按照規範要求和針對數據的自檢進行研發過程行為規範化;

n) 研發工具:對研發用戶的行為規範是否滿足要求進行自動化檢查;最終目標是讓整個軟件工程規範都固化在工具中進行承載;

o) 數據分析(阿基米德):呈現按照規範改進后的明細數據和匯總目標;研發用戶:自助查看整改后的明細數據;

p) COE:根據數據改進的效果,以及過程中暴露的問題進行總結后形成經驗資產,並持續改進;

數據流圖

過程可信的數據在各個工具系統中採集、流轉、匯聚、分析、呈現,整個數據流圖如下:

其中,識別出6個重要的全量數據源:

a) 代碼庫數據:該數據由伏羲的服務信息樹上配置的代碼庫數據,加上阿基米德上人工配置的代碼庫,構成各個雲服務發布到生產倉的代碼全集;

b) Workitem信息流數據:當前識別vision上的需求、問題、task,加上Gitlab/Codeclub上的issue,構成可識別的Workitem數據全集;

c) SRE現網包數據:包括普羅部署、CCE、CPS、CDK各種類型部署的包數據,構成全量現網包數據;

d) 開源二進制包數據:開源中心倉數據(java、python、go、nodejs四種)語言,加上公司c/c++的數據構成全量開源二進制包數據;

e) 研發過程配置數據:阿基米德上配置的committer數據是全量的committer數據;阿基米德上識別出來的主分支是全量的主分支(邏輯“master”)數據;

f) 伏羲研發過程數據:伏羲三個庫,MongoDB的靜態檢查、門禁數據;MySQL中的測試、發布數據;MySQL中包和多個流水線的對應關係數據;一起構成了以“包”為維度的全量伏羲研發過程數據;

運作組織

數據治理運營團隊

按照過程可信在BU的落地策略,在CleanCode、構建、開源、E2E追溯四個領域設置數據治理運營團隊,由 “數據分析工具(阿基米德)—COE—各個服務產品部接口人組成的治理小組”三個角色組成,以“指標度量為牽引,數據的客觀呈現為落地方式,業務的價值反饋為最終目的”的原則來落地數據治理工作。

COE的職責:

1) 和公司可信變革目標牽引對齊,結合BU能力現狀,形成BU的整體可信要求;定義出適合BU現狀的軟件工程規範要求;針對規範分解出核心的度量指標,並制定度量數據模型;

2) 利用作業工具已經產生的數據,和治理小組一起分析識別數據質量的問題,按照三層數據分析模型,層層打開,識別業務團隊能力Gap點。

3) 分析典型問題,識別作業流的斷裂點進行補齊,和業務團隊的不規範動作,制定規範和公約要求,逐步改善數據質量。

4) 事後歸納總結,識別出流程缺失,組織缺失,責任缺失等機制行問題,並固化到作業工具中。

治理小組:

1) 結合各個服務產品部的實際情況,承接COE的數據治理規範在各個服務產品部的落地;

2) 識別數據治理動作在各個服務產品部落地過程中的實際問題,和COE一起分析,提出系統性的解決思路,最終固化到作業工具中。

3) 跟蹤過程可信在業務團隊落地的過程中的進展,為業務團隊最終達成可信變革目標負責,為改進過程產生實際的業務價值負責;

數據分析工具(阿基米德):

1) 確保接入的數據準確、實時、一致,用數據實時反映BU各個服務產品部的能力現狀,為COE和治理小組的數據運營提供數據支撐;

2) 系統性的落地COE的方案設計,實現整個BU統一標準的數據看板,能夠清晰的通過數據識別出來業務團隊的能力Gap,牽引業務團隊達成整體改進目標;

3) 按照三層數據模型進行數據展示,層層下鑽,讓業務團隊“知其然,知其所以然”,牽引業務團隊中的每一個人都能自己進行改進;

4) 通過數據分析,識別DevSecOps軟件工程規範在BU的業務團隊落地過程中的重點問題,以及該問題背後的流程、制度缺失,促使最終規範固化在作業工具中。

例會設置

“數據驅動DevSecOps能力提升例會”為研發領域數據治理相關問題的求助和裁決例會。

會議分為三個階段:

1) 第一階段,例行議題,形式類似於“體檢報告”,用數據反映業務團隊的現狀和問題;

2) 第二階段,申報議題,形式類似於“專家會診”,討論某一個具體數據治理過程中的問題和Top困難求助;

3) 第三階段,靈活安排議題,形式類似於“問題總結”,針對某一類的具體問題,進行集中討論和歸納總結定義,形成BU的規範流程和章程總結。

主數據承載系統

主數據是指具有高業務價值的、可以在企業內跨越多個業務部門被重複使用的數據,是單一、準確、權威的數據來源。和業務型數據、分析型數據相比,主數據主要有以下幾個特徵:

1) 特徵一致性:也就是能否保證主數據的關鍵特徵在不同應用、不同系統中的高度一致,直接關係了數據治理成敗;

2) 識別唯一性:在一個系統、一個平台,甚至一個企業範圍內,同一主數據實體要求具有唯一的數據標識,即數據編碼;

3) 長期有效性:貫穿該業務對象的整個生命周期甚至更長,當該主數據失去其效果時,系統採取的措施通常為軟刪除,而不是物理刪除;

4) 業務穩定性:在業務過程中其識別信息和關鍵特徵會被業務過程中產生的數據繼承、引用和複製。除非該主數據本身的特徵發生變化,否則該主數據不會隨着業務的過程中被其他系統修改。

主數據源識別原則:

a) 如果有多個數據源構成同類型數據的主數據,兩種處理策略:

1)選取一個源系統逐步收編其他源系統的數據,變成唯一主數據源

2)如果1)不能實現,由阿基米德系統進行封裝后屏蔽多個數據源系統,該類型數據的唯一數據源變成阿基米德,待後續1)實現后,阿基米德該類型主數據源失效。

3)當數據在多個作業系統中進行流轉時,判斷是否作為主數據源的標準是:數據在該系統有實際的業務動作產生,而不是只承載數據的流轉。

b) 如果確定為唯一數據源,其他消費該類型數據的系統不能和數據源產生衝突。

所有數據僅能在數據源產生,其它系統只能讀取不能修改。下游發現的數據源質量問題,應當在數據源頭進行修正。

c) 主數據使用方不得改變原始數據,但可以進行擴展。

數據消費方不得對獲取的數據進行增、刪、改,但可以在數據的基礎上進行屬性擴展。

d) 在滿足信息安全的前提下充分共享,不得拒絕合理的數據共享需求。

數據如果不流轉,不僅不會產生業務價值,還增加存儲成本;只有不斷流轉,對業務團隊產生實際價值時,還能得到使用效果的反饋,促進數據價值的進一步提升。

原則為:核心資產安全優先,非關鍵資產效率優先。

一類主數據源

二類主數據源


點擊關注,第一時間了解華為雲新鮮技術~

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

※別再煩惱如何寫文案,掌握八大原則!

Shader專題:卡通着色(一)控制顏色的藝術

什麼是 Shader?

關於什麼是 Shader ,各種百科各種教程都有說過,但是今天我們就從一個另一個角度去試着理解什麼是 Shader?

我們先看下 Shade 的英文意思,如下:
v.給…遮擋(光線);把…塗暗

其中 把…塗暗 更貼近我們想要的意思。
所以:Shader 這個單詞從字面上理解,就是把什麼東西塗暗。

再強調一次:Shader 從單詞字面上理解,就是把什麼東西塗暗。
再強調一次:把什麼東西塗暗的就是 Shader,就是着色器。

Shader 把什麼塗暗了?

當然是遊戲世界的各個物體,總所周知:有光明就有黑暗,有光照物體就有明暗對比,同時也會有陰影,而 Shader 之所以叫 Shader 是因為起初的時候,Shader 就是用來給物體增加明暗對比的,有了明暗對比,物體在遊戲世界中就會更加立體,從而畫面會更加真實。

所以 Shader 的作用就是給物體添加明暗對比。

Shader 為什麼叫 Shader

當然以上純屬個人推測。現在 Shader 不止可以給物體添加明暗對比,而且還可以做很多濾鏡效果,也可以做很多性能優化(比如減少包大小、減少圖片內存等)的事情。

也許,一開始給 Shader 起名叫 Shader 的時候,Shader 功能非常有限,僅僅只是給物體添加明暗對比(也就是光照計算),後來由於硬件和軟件的發展, 很多離線渲染(電影 CG)的算法都逐步應用在實時渲染(主要是 遊戲 和3D 仿真等),Shader 能做的事情就越來越多,發展到今天,Shader 主要的功能並不只有光照計算。這樣導致,在概念理解上給很多初學者增加了很多阻礙。

教練有一次聽過一位搞圖形學的朋友說:“我們搞實時渲染的都是那些搞視頻(離線渲染)玩剩的”。

Shader 是着色器

什麼是 Shader,中文叫做着色器,也就是給物體上色的意思,也就是說寫 Shader 就是給物體上色的藝術。而這個上色不只是簡單的色彩填充,而是涵蓋了非常多的技巧(幾何計算、顏色計算、貼圖等)

所以中文的着色器,是一個非常精準的翻譯。

群內的笑笑說了一個比較不錯的說法:Shader 主要是光線數據作用在不同數據的物體上產生不同效果。

Shader 學習的順序

不管是 Shader 還是其它某個科目,都有一些最常用、最簡單的知識點。

而這些知識點很容易學以致用,也就是說,這種知識點,我們學習完了就能馬上落地。

所以,教練要做的就是,把 Shader 中的知識點按照是否常用和是否簡單這兩個維度進行排列篩選,然後把它們一個個整理成案例,這樣童鞋們的學習體驗就會大幅上升。

主題式研究第三個階段

  • 第一個階段:確定主題(關鍵字)
  • 第二個階段:搜索資料、搜索信息(搜集情報)
  • 第三個階段:構建知識體系(畫腦圖、寫大綱)

到此,Shader 這個主題,我們目前已經到了第三個階段,也就是構建知識體系的階段。

當然,這一整篇,都再講,我們要怎麼怎麼做,接下來幹嗎,並沒有學習 Shader 的任何一個知識點。

那麼今天就學習一點 Shader 知識意思一下。

顏色的控制

現有一張貼圖,如下:

用來控制顏色的 shader 代碼如下:

float4 frag (v2f i) : SV_Target
{
    // 圖片上每個像素的顏色值
    float4 color = tex2D(_MainTex, i.uv);
                
    // 返回顏色,表示將改像素的顏色值輸出到屏幕上
    return color;
}

我們只看方法中的代碼,先不要在意一些細節。

雖然,我們沒有 Shader 的語法學習經驗,但是憑我們的 C# 經驗,可以將上述代碼推測個大概來。

首先 float4 是一個類型,可以存儲 4 個 float 數值。而顏色一般都是由 r(red 紅色)、g(green,綠色)、b(blue,藍色)、a(alpha,透明度) 四個值控制。所以 float4 可以存儲一個顏色。

現在,我們把圖片中每個像素顏色重的紅色值設置為 0,圖片結果則如下所示:

代碼如下所示:

float4 frag (v2f i) : SV_Target
{
    // 圖片上每個像素的顏色值
    float4 color = tex2D(_MainTex, i.uv);
                
    color.r = 0;

    // 返回顏色,表示將改像素的顏色值輸出到屏幕上
    return color;
}

我們看到,圖片變成了藍綠色。

小結

Shader 是一門控制顏色的藝術,Shader 的核心也是如此。
在此篇,我們學習了 Shader 的兩個重要知識點:

  1. float4 結構體
  2. 顏色的 rgb 控制

這兩個知識點非常簡單,也非常基礎,但是是非常常用的兩個知識點。

這片文章的內容就這些。

知識地圖

相關下載:

轉載請註明地址:liangxiegame.com

更多內容
QFramework 地址:https://github.com/liangxiegame/QFramework
QQ 交流群:623597263
涼鞋的主頁:https://liangxiegame.com/zhuanlan
關注公眾號:liangxiegame 獲取第一時間更新通知及更多的免費內容。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※南投搬家前需注意的眉眉角角,別等搬了再說!

※新北清潔公司,居家、辦公、裝潢細清專業服務

理解C#中的ValueTask

原文:https://devblogs.microsoft.com/dotnet/understanding-the-whys-whats-and-whens-of-valuetask/
作者:Stephen
翻譯:xiaoxiaotank
備註:本文要求讀者對Task有一定的了解,文章文字描述較多,但內容十分充實,相信你認真閱讀後,一定讓你受益匪淺。

前言

Task類是在.NET Framework 4引入的,位於System.Threading.Tasks命名空間下,它與派生的泛型類Task<TResult>已然成為.NET編程的主力,也是以async/await(C# 5引入的)語法糖為代表的異步編程模型的核心。

隨後,我會向大家介紹.NET Core 2.0中的新成員ValueTask/ValueTask<TResult>,來幫助你在日常開發用例中降低內存分配開銷,提升異步性能。

Task

雖然Task的用法有很多,但其最核心的是“承諾(promise)”,用來表示某個操作最終完成。

當你初始化一個操作后,會獲取一個與該操作相關的Task,當這個操作完成時,Task也同樣會完成。這個操作的完成情況可能有以下幾種:

  • 作為初始化操作的一部分同步完成,例如:訪問一些已被緩存的數據
  • 恰好在你獲取到Task實例的時候異步完成,例如:訪問雖然沒被緩存但是訪問速度非常快的數據
  • 你已經獲取到了Task實例,並等待了一段時間后,才異步完成,例如:訪問一些網絡數據

由於操作可能會異步完成,所以當你想要使用最終結果時,你可以通過阻塞來等待結果返回(不過這違背了異步操作的初衷);或者,使用回調方法,它會在操作完成時被調用,.NET 4通過Task.ContinueWith方法顯式實現了這個回調方法,如:

SomeOperationAsync().ContinueWith(task =>
{
    try
    {
        TResult result = task.Result;
        UseResult(result);
    }
    catch(Exception ex)
    {
        HandleException(ex);
    }
})

而在.NET 4.5中,Task通過結合await,大大簡化了對異步操作結果的使用,它能夠優化上面說的所有情況,無論操作是同步完成、快速異步完成還是已經(隱式地)提供回調之後異步完成,都不在話下,寫法如下:

TResult result = await SomeOperationAsync();
UseResult(result);

Task作為一個類(class),非常靈活,並因此帶來了很多好處。例如:

  • 它可以被任意數量的調用者併發await多次
  • 你可以把它存儲到字典中,以便任意數量的後續使用者對其進行await,進而把這個字典當成異步結果的緩存
  • 如果需要的話,你可以通過阻塞等待操作完成
  • 另外,你還可以對Task使用各種各樣的操作(稱為“組合器”,combinators),例如使用Task.WhenAny異步等待任意一個操作率先完成。

不過,在大多數情況下其實用不到這種靈活性,只需要簡單地調用異步操作並await獲取結果就好了:

TResult result = await SomeOperationAsync();
UseResult(result);

在這種用法中,我們不需要多次await task,不需要處理併發await,不需要處理同步阻塞,也不需要編寫組合器,我們只是異步等待操作的結果。這就是我們編寫同步代碼(例如TResult result = SomeOperation())的方式,它很自然地轉換為了async/await的方式。

此外,Task也確實存在潛在缺陷,特別是在需要創建大量Task實例且要求高吞吐量和高性能的場景下。Task 是一個類(class),作為一個類,這意味着每創建一個操作,都需要分配一個對象,而且分配的對象越多,垃圾回收器(GC)的工作量也會越大,我們花在這個上面的資源也就越多,本來這些資源可以用於做其他事情。慶幸的是,運行時(Runtime)和核心庫在許多情況下都可以緩解這種情況。

例如,你寫了如下方法:

public async Task WriteAsync(byte value)
{
    if (_bufferedCount == _buffer.Length)
    {
        await FlushAsync();
    }
    _buffer[_bufferedCount++] = value;
}

一般來說,緩衝區中會有可用空間,也就無需Flush,這樣操作就會同步完成。這時,不需要Task返回任何特殊信息,因為沒有返回值,返回Task與同步方法返回void沒什麼區別。因此,運行時可以簡單地緩存單個非泛型Task,並將其反覆用作任何同步完成的方法的結果(該單例是通過Task.CompletedTask公開的)。

或者,你的方法是這樣的:

public async Task<bool> MoveNextAsync()
{
    if (_bufferedCount == 0)
    {
        // 緩存數據
        await FillBuffer();
    }
    return _bufferedCount > 0;
}

一般來說,我們想的是會有一些緩存數據,這樣_bufferedCount就不會等於0,直接返回true就可以了;只有當沒有緩存數據(即_bufferedCount == 0)時,才需要執行可能異步完成的操作。而且,由於只有true和false這兩種可能的結果,所以只需要兩個Task<bool>對象來分別表示true和false,因此運行時可以將這兩個對象緩存下來,避免內存分配。只有當操作異步完成時,該方法才需要分配新的Task<bool>,因為調用方在知道操作結果之前,就要得到Task<bool>對象,並且要求該對象是唯一的,這樣在操作完成后,就可以將結果存儲到該對象中。

運行時也為其他類型型維護了一個類似的小型緩存,但是想要緩存所有內容是不切實際的。例如下面這個方法:

public async Task<int> ReadNextByteAsync()
{
    if (_bufferedCount == 0)
    {
        await FillBuffer();
    }

    if (_bufferedCount == 0)
    {
        return -1;
    }

    _bufferedCount--;
    return _buffer[_position++];
}

通常情況下,上面的案例也會同步完成。但是與上一個返回Task<bool>的案例不同,該方法返回的Int32的可能值約有40億個結果,如果將它們都緩存下來,大概會消耗數百GB的內存。雖然運行時保留了一個小型緩存,但也只保留了一小部分結果值,因此,如果該方法同步完成(緩衝區中有數據)的返回值是4,它會返回緩存的Task<int>,但是如果它同步完成的返回值是42,那就會分配一個新的Task<int>,相當於調用了Task.FromResult(42)。

許多框架庫的實現也嘗試通過維護自己的緩存來進一步緩解這種情況。例如,.NET Framework 4.5中引入的MemoryStream.ReadAsync重載方法總是會同步完成,因為它只從內存中讀取數據。它返回一個Task<int>對象,其中Int32結果表示讀取的字節數。ReadAsync常常用在循環中,並且每次調用時請求的字節數是相同的(僅讀取到數據末尾時才有可能不同)。因此,重複調用通常會返回同步結果,其結果與上一次調用相同。這樣,可以維護單個Task實例的緩存,即緩存最後一次成功返回的Task實例。然後在後續調用中,如果新結果與其緩存的結果相匹配,它還是返回緩存的Task實例;否則,它會創建一個新的Task實例,並把它作為新的緩存Task,然後將其返回。

即使這樣,在許多操作同步完成的情況下,仍需強制分配Task<TResult>實例並返回。

同步完成時的ValueTask

正因如此,在.NET Core 2.0 中引入了一個新類型——ValueTask<TResult>,用來優化性能。之前的.NET版本可以通過引用NuGet包使用:System.Threading.Tasks.Extensions

ValueTask<TResult>是一個結構體(struct),用來包裝TResult或Task<TResult>,因此它可以從異步方法中返回。並且,如果方法是同步成功完成的,則不需要分配任何東西:我們可以簡單地使用TResult來初始化ValueTask<TResult>並返回它。只有當方法異步完成時,才需要分配一個Task<TResult>實例,並使用ValueTask<TResult>來包裝該實例。另外,為了使ValueTask<TResult>更加輕量化,併為成功情形進行優化,所以拋出未處理異常的異步方法也會分配一個Task<TResult>實例,以方便ValueTask<TResult>包裝Task<TResult>,而不是增加一個附加字段來存儲異常(Exception)。

這樣,像MemoryStream.ReadAsync這類方法將返回ValueTask<int>而不需要關注緩存,現在可以使用以下代碼:

public override ValueTask<int> ReadAsync(byte[] buffer, int offset, int count)
{
    try
    {
        int bytesRead = Read(buffer, offset, count);
        return new ValueTask<int>(bytesRead);
    }
    catch (Exception e)
    {
        return new ValueTask<int>(Task.FromException<int>(e));
    }
}

異步完成時的ValueTask

能夠編寫出在同步完成時無需為結果類型產生額外內存分配的異步方法是一項很大的突破,.NET Core 2.0引入ValueTask<TResult>的目的,就是將頻繁使用的新方法定義為返回ValueTask<TResult>而不是Task<TResult>。

例如,我們在.NET Core 2.1中的Stream類中添加了新的ReadAsync重載方法,以傳遞Memory<byte>來替代byte[],該方法的返回類型就是ValueTask<int>。這樣,Streams(一般都有一種同步完成的ReadAsync方法,如前面的MemoryStream示例中所示)現在可以在使用過程中更少的分配內存。

但是,在處理高吞吐量服務時,我們依舊需要考慮如何盡可能地避免額外內存分配,這就要想辦法減少或消除異步完成時的內存分配。

使用await異步編程模型時,對於任何異步完成的操作,我們都需要返回代表該操作最終完成的對象:調用者需要能夠傳遞在操作完成時調用的回調方法,這就要求在堆上有一個唯一的對象,用作這種特定操作的管道,但是,這並不意味着有關操作完成后能否重用該對象的任何信息。如果對象可以重複使用,則API可以維護一個或多個此類對象的緩存,並將其復用於序列化操作,也就是說,它不能將同一對象用於多個同時進行中的異步操作,但可以復用於非并行訪問下的對象。

在.NET Core 2.1中,為了支持這種池化和復用,ValueTask<TResult>進行了增強,不僅可以包裝TResult和Task<TResult>,還可以包裝新引入的接口IValueTaskSource<TResult>。類似於Task<TResult>,IValueTaskSource<TResult>提供表示異步操作所需的核心支持;

public interface IValueTaskSource<out TResult>
{
    ValueTaskSourceStatus GetStatus(short token);
    void OnCompleted(Action<object> continuation, object state, short token, ValueTaskSourceOnCompletedFlags flags);
    TResult GetResult(short token);
}
  • GetStatus用於實現諸如ValueTask<TResult>.IsCompleted之類的屬性,返回指示異步操作是否仍在掛起或是否已完成以及完成情況(成功或失敗)的指示。
  • OnCompleted用於ValueTask<TResult>的等待者(awaiter),它與調用者提供的回調方法掛鈎,當異步操作完成時,等待者繼續執行回調方法。
  • GetResult用於檢索操作的結果,以便在操作完成后,等待者可以獲取TResult或傳播可能發生的任何異常。

大多數開發人員永遠都不需要用到此接口(指IValueTaskSource<TResult>):方法只是簡單地將包裝該接口實例的ValueTask<TResult>實例返回給調用者,而調用者並不需要知道內部細節。該接口的主要作用是為了讓開發人員在編寫性能敏感的API時可以盡可能地避免額外內存分配。

.NET Core 2.1中有幾個類似的API。最值得關注的是Socket.ReceiveAsync和Socket.SendAsync,添加了新的重載,例如:

public ValueTask<int> ReceiveAsync(Memory<byte> buffer, SocketFlags socketFlags, CancellationToken cancellationToken = default);

此重載返回ValueTask<int>。

如果操作同步完成,則可以簡單地構造具有正確結果的ValueTask<int>,例如:

int result = …;
return new ValueTask<int>(result);

如果它異步完成,則可以使用實現此接口的池對象:

IValueTaskSource<int> vts = …;
return new ValueTask<int>(vts);

該Socket實現維護了兩個這樣的池對象,一個用於Receive,一個用於Send,這樣,每次未完成的對象只要不超過一個,即使這些重載是異步完成的,它們最終也不會額外分配內存。NetworkStream也因此受益。

例如,在.NET Core 2.1中,Stream公開了一個方法:

public virtual ValueTask<int> ReadAsync(Memory<byte> buffer, CancellationToken cancellationToken = default);

NetworkStream的重載方法NetworkStream.ReadAsync,內部實際邏輯只是交給了Socket.ReceiveAsync去處理,所以將優勢從Socket帶到了NetworkStream中,使得NetworkStream.ReadAsync也有效地不進行額外內存分配了。

非泛型的ValueTask

當在.NET Core 2.0中引入ValueTask<TResult>時,它純粹是為了優化異步方法同步完成的情況——避免必須分配一個Task<TResult>實例用於存儲TResult。這也意味着非泛型的ValueTask是不必要的(因為沒有TResult):對於同步完成的情況,返回值為Task的方法可以返回Task.CompletedTask單例,此單例由async Task方法的運行時隱式返回。

然而,隨着即使異步完成也要避免額外內存分配需求的出現,非泛型的ValueTask又變得必不可少。因此,在.NET Core 2.1中,我們還引入了非泛型的ValueTask和IValueTaskSource。它們提供泛型版本對應的非泛型版本,使用方式類似,只是GetResult返回void。

實現IValueTaskSource / IValueTaskSource

大多數開發人員都不需要實現這兩個接口,它們也不是特別容易實現。如果您需要的話,.NET Core 2.1的內部有幾種實現可以用作參考,例如

  • AwaitableSocketAsyncEventArgs
  • AsyncOperation
  • DefaultPipeReader

為了使想要這樣做的開發人員更輕鬆地進行開發,將在.NET Core 3.0中計劃引入ManualResetValueTaskSourceCore<TResult>結構體(譯註:目前已引入),用於實現接口的所有邏輯,並可以被包裝到其他實現了IValueTaskSource和IValueTaskSource<TResult>的包裝器對象中,這個包裝器對象只需要單純地將大部分實現交給該結構體就可以了。

ValueTask的有效消費模式

從表面上看,ValueTask和ValueTask<TResult>的使用限制要比Task和Task<TResult>大得多 。不過沒關係,這甚至就是我們想要的,因為主要的消費方式就是簡單地await它們。

但是,由於ValueTask和ValueTask<TResult>可能包裝可復用的對象,因此,與Task和Task<TResult>相比,如果調用者偏離了僅await它們的設計目的,則它們在使用上實際回受到很大的限制。通常,以下操作絕對不能用在ValueTask/ValueTask<TResult>上:

  • await ValueTask/ValueTask<TResult>多次。

    因為底層對象可能已經被回收了,並已由其他操作使用。而Task/Task<TResult>永遠不會從完成狀態轉換為未完成狀態,因此您可以根據需要等待多次,並且每次都會得到相同的結果。

  • 併發await ValueTask/ValueTask<TResult>。

    底層對象期望一次只有單個調用者的單個回調來使用,並且嘗試同時等待它可能很容易引入競爭條件和細微的程序錯誤。這也是第一個錯誤操作的一個更具體的情況——await ValueTask/ValueTask<TResult>多次。相反,Task/Task<TResult>支持任意數量的併發等待

  • 使用.GetAwaiter().GetResult()時操作尚未完成。

    IValueTaskSource / IValueTaskSource<TResult>接口的實現中,在操作完成前是沒有強制要求支持阻塞的,並且很可能不會支持,所以這種操作本質上是一種競爭狀態,也不可能按照調用方的意願去執行。相反,Task/Task<TResult>支持此功能,可以阻塞調用者,直到任務完成。

如果您使用ValueTask/ValueTask<TResult>,並且您確實需要執行上述任一操作,則應使用.AsTask()獲取Task/Task<TResult>實例,然後對該實例進行操作。並且,在之後的代碼中您再也不應該與該ValueTask/ValueTask<TResult>進行交互。
簡單說就是使用ValueTask/ValueTask<TResult>時,您應該直接await它(可以有選擇地加上.ConfigureAwait(false)),或直接調用AsTask()且再也不要使用它,例如:

// 以這個方法為例
public ValueTask<int> SomeValueTaskReturningMethodAsync();
…
// GOOD
int result = await SomeValueTaskReturningMethodAsync();

// GOOD
int result = await SomeValueTaskReturningMethodAsync().ConfigureAwait(false);

// GOOD
Task<int> t = SomeValueTaskReturningMethodAsync().AsTask();

// WARNING
ValueTask<int> vt = SomeValueTaskReturningMethodAsync();
... // 將實例存儲到本地會使它被濫用的可能性更大,
    // 不過這還好,適當使用沒啥問題

// BAD: await 多次
ValueTask<int> vt = SomeValueTaskReturningMethodAsync();
int result = await vt;
int result2 = await vt;

// BAD: 併發 await (and, by definition then, multiple times)
ValueTask<int> vt = SomeValueTaskReturningMethodAsync();
Task.Run(async () => await vt);

// BAD: 在不清楚操作是否完成的情況下使用 GetAwaiter().GetResult()
ValueTask<int> vt = SomeValueTaskReturningMethodAsync();
int result = vt.GetAwaiter().GetResult();

另外,開發人員可以選擇使用另一種高級模式,最好你在衡量后確定它可以帶來好處之後再使用。具體來說,ValueTask/ValueTask<TResult>確實公開了一些與操作的當前狀態有關的屬性,例如:

  • IsCompleted,如果操作尚未完成,則返回false;如果操作已完成,則返回true(這意味着該操作不再運行,並且可能已經成功完成或以其他方式完成)
  • IsCompletedSuccessfully,當且僅當它已完成並成功完成才返回true(意味着嘗試等待它或訪問其結果不會導致引發異常)

舉個例子,對於一些執行非常頻繁的代碼,想要避免在異步執行時進行額外的性能損耗,並在某個本質上會使ValueTask/ValueTask<TResult>不再使用的操作(如await、.AsTask())時,可以先檢查這些屬性。例如,在 .NET Core 2.1的SocketsHttpHandler實現中,代碼在連接上發出讀操作,並返回一個ValueTask<int>實例。如果該操作同步完成,那麼我們不用關注能否取消該操作。但是,如果它異步完成,在運行時就要發出取消請求,這樣取消請求會將連接斷開。由於這是一個非常常用的代碼,並且通過分析表明這樣做的確有細微差別,因此代碼的結構基本上如下:

int bytesRead;
{
    ValueTask<int> readTask = _connection.ReadAsync(buffer);
    if (readTask.IsCompletedSuccessfully)
    {
        bytesRead = readTask.Result;
    }
    else
    {
        using (_connection.RegisterCancellation())
        {
            bytesRead = await readTask;
        }
    }
}

這種模式是可以接受的,因為在ValueTask<int>的Result被訪問或自身被await之後,不會再被使用了。

新異步API都應返回ValueTask / ValueTask 嗎?

當然不是,Task/Task<TResult>仍然是默認選擇

正如上文所強調的那樣,Task/Task<TResult>比ValueTask/ValueTask<TResult>更加容易正確使用,所以除非對性能的影響大於可用性的影響,否則Task/Task<TResult>仍然是最優的。

此外,返回ValueTask<TResult>會比返回Task<TResult>多一些小開銷,例如,await Task<TResult>比await ValueTask<TResult>會更快一些,所以如果你可以使用緩存的Task實例(例如,你的API返回Task或Task<bool>),你或許應該為了更好地性能而仍使用Task和Task<bool>。而且,ValueTask/ValueTask<TResult>相比Task/Task<TResult>有更多的字段,所以當它們被await、並將它們的字段存儲在調用異步方法的狀態機中時,它們會在該狀態機對象中佔用更多的空間。

但是,如果是以下情況,那你應該使用ValueTask/ValueTask<TResult>:

  1. 你希望API的調用者只能直接await它
  2. 避免額外的內存分配的開銷對API很重要
  3. 你預期該API常常是同步完成的,或者在異步完成時你可以有效地池化對象。

在添加抽象、虛擬或接口方法時,您還需要考慮這些方法的重載/實現是否存在這些情況。

ValueTask和ValueTask 的下一步是什麼?

對於.NET Core庫,我們將依然會看到新的API被添加進來,其返回值是Task/Task<TResult>,但在適當的地方,我們也將看到添加了新的以ValueTask/ValueTask<TResult>為返回值的API。

ValueTask/ValueTask<TResult>的一個關鍵例子就是在.NET Core 3.0添加新的IAsyncEnumerator<T>支持。IEnumerator<T>公開了一個返回bool的MoveNext方法,異步IAsyncEnumerator<T>則會公開一個MoveNextAsync方法。剛開始設計此功能時,我們認為MoveNextAsync 應返回Task<bool>,一般情況下,通過緩存的Task<bool>在同步完成時可以非常高效地執行此操作。但是,考慮到我們期望的異步枚舉的廣泛性,並且考慮到它們基於是基於接口的,其可能有許多不同的實現方式(其中一些可能會非常關注性能和內存分配),並且鑒於絕大多數的消費者將通過await foreach來使用,我們決定MoveNextAsync返回ValueTask<bool>。這樣既可以使同步完成案例變得很快,又可以使用可重用的對象來使異步完成案例的內存分配也減少。實際上,在實現異步迭代器時,C#編譯器會利用此優勢,以使異步迭代器盡可能免於額外內存分配。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

※幫你省時又省力,新北清潔一流服務好口碑

※別再煩惱如何寫文案,掌握八大原則!

東京奧運聖火傳遞福島起點 被查出輻射量異常

摘錄自2019年12月4日自由時報報導

日本東京奧運聖火明年3月底從福島縣的足球國練中心「J-VILLAGE」出發,但日本環境省今(4日)透露,「J-VILLAGE」相鄰的停車場有部分區域空間輻射量較高,當局已要求東京電力公司再次去污。

J-VILLAGE位於福島縣濱通南部,2011年福島核災發生後,由於此處距離福島核一廠僅有20公里,被政府借用為核災事故處理的對應據點,該中心今年4月下旬才全面恢復營運,因具有災區重建的重大象徵意義,所以被選為聖火傳遞的起點。

根據《共同社》報導,環保團體綠色和平組織10月對J-VILLAGE周圍展開調查,發現異常的輻射量,隨後將結果送交環境省。

環境省表示,空間輻射量較高的是與J-VILLAGE相鄰的楢葉町營停車場部分區域,已要求東電對該地區未經鋪設的地面再次去污。東電3日去除了周圍約0.03立方米的土和草,調查放射性物質的種類等。

根據東電的調查,在去污地區1公尺高的位置測得每小時1.79微西弗的輻射量,超過日本政府訂定的0.23微西弗的去污標準。地表輻射量為70.2微西弗。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※教你寫出一流的銷售文案?
北極熊身上遭噴黑字「T-34」 專家震驚:失去保護色恐難覓食

摘錄自2019年12月4日上報報導

隨著全球暖化加劇,近幾個月以來常見北極熊出現在俄羅斯北方。但是近期在社群媒流傳的影片可見,有隻北極熊身體側邊被噴上黑色字母和數字「T-34」,目前專家正在調查這部影片的確切拍攝地點是否位於俄羅斯,並且警告這樣的行為可能會影響北極熊的生活技能,使牠們失去原有的保護色,難以在白雪覆蓋的地區捕獵食物。

《英國廣播公司》(BBC)報導,這部影片被世界自然基金會(World Wildlife Fund,WWF)成員卡夫里(Sergey Kavry)發布在Facebook,之後又被當地媒體廣泛分享。卡夫里說,這部影片被分享在通訊軟體WhatsApp的一個俄羅斯東部楚科奇自治區(Chukotka)當地居民的群組裡,而負責監控野生動物的科學家也不會以噴漆的方式將北極熊進行編號。

由於「T-34」戰車是蘇聯在第二次世界大戰(World War Two)戰勝德國納粹的重要關鍵,卡夫里說:「我不知道這段影片究竟是在哪個區域、地區,或哪裡的附近拍攝。如果這是個傳遞軍事訊息的舉動……某種程度來說是對歷史不尊重。」

俄羅斯北方生態問題研究所(Institute Of The Biological Problems Of The North)科學家科赫涅夫(Anatoly Kochnev)指出,北極熊不太可能在未被麻醉的情況下,任人在牠身上噴字。

科赫涅夫提到,這隻北極熊被噴漆的當下可能無法活動,或是可能靜止不動,因為牠被噴上的字樣均勻,而且大小相同。此外,他認為這可能發生在俄羅斯北部地區新地島(Novaya Zemlya),因為先前有專家團隊將北極熊進行麻醉,阻止牠們在人類居住地遊蕩。

科赫涅夫說,如今要將這隻北極熊的噴漆洗掉可能要花上好幾週的時間,而且這會對牠的白色保護色造成影響,使牠難以在冰雪覆蓋的地方順利捕食獵物。

俄羅斯媒體推測,在北極熊身上噴漆的舉動,可能是基於附近居民對於許多北極熊屢次闖入人類居住地的恐懼與不滿。隨著全球暖化日漸加劇,新地島2月宣布進入緊急狀態,因為有超過50隻北極熊出現在該地區,牠們在人口密集居住的建築物周遭漫步、尋找食物。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

※新北清潔公司,居家、辦公、裝潢細清專業服務

聯合國:反疫苗運動 助長薩摩亞麻疹疫情惡化

摘錄自2019年12月6日中央通訊社綜合報導

聯合國兒童基金會(UNICEF)太平洋島嶼負責人今天(5日)表示,社群媒體巨頭必須嚴厲取締反疫苗接種貼文,這些貼文助長薩摩亞(Samoa)致命麻疹疫情惡化。

UNICEF地區代表耶特(Sheldon Yett)表示,推特(Twitter)、臉書(Facebook)和Instagram(IG)等網路平台上「極不負責任」的反疫苗接種訊息,加劇了薩摩亞爆發的麻疹疫情,自10月中旬以來已造成62人死亡。耶特告訴法新社:「很明顯地它們必需負起企業責任並展開行動,確保那些人民,特別是弱勢族群能獲得正確資訊,讓孩童得以存活。」

在麻疹疫情爆發前,薩摩亞的疫苗接種率降至只剩略超過30%,遠低於公認最佳接種率90%,這也使得該海島國家極易受到感染。世界衛生組織(WHO)把矛頭指向反疫苗宣傳運動。耶特表示,這項運動主要是由海外倡議人士在網路上展開。

「很不幸的是,這項運動在薩摩亞找到願意相信的民眾,那裡有一部分人懷疑醫療保健服務品質,且可能不信任當地(疫苗)供應者。」他說,來自諸如美國和澳洲等富裕已開發國家的運動人士,在網路上張貼反疫苗訊息,他們必須意識到自己的所作所為會對開發中國家帶來衝擊。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※評比南投搬家公司費用收費行情懶人包大公開

※幫你省時又省力,新北清潔一流服務好口碑