特斯拉要求員工 4/29 復工,加州工廠可能提前恢復生產

特斯拉已通知部分員工,要求 4 月 29 日重返工作崗位,雖然加州超級工廠所在地的公共衛生部門還沒有公告解除和放鬆居家隔離。特斯拉要求員工提前復工是為了 5 月 3 日前準備好恢復生產。

特斯拉加州超級工廠所在地 Fremont 的公共衛生部門仍然沒有解除居家隔離,超級工廠屬於非必要生產製造工廠,僅可維持最基本營運,生產線處於停產狀態。特斯拉計劃在 5 月 4 日恢復生產,但在正式復工前主管已通知部分員工,要求 4 月 29 日到工廠報到,主要是沖壓、油漆業務員工。特斯拉沒有透露提前復工的員工數量。

Fremont 所屬 Alameda 郡新聞發言人 Ray Kelly 表示,目前居家隔離沒有任何調整,預期 5 月 3 日前公共衛生部門會說明,可能延長、放鬆或完全解除。

特斯拉加州工廠在 3 月 19 日接到政府部門通知,必須停止生產,特斯拉沒有第一時間配合政府部門調整生產線,繼續生產了 5 天,法務團隊也持續與政府部門溝通,特斯拉認為電動車生產屬於必要業務,不能因居家隔離停產,同時為員工提供必要的健康保障措施。停產前特斯拉會測量進入工廠的員工體溫,並向部分員工發放口罩。

政府部門強制要求停工後,特斯拉通知所有員工,除必要工作外,所有員工在家上班,部分無法在家工作的員工列為休假,降低員工薪水,並停止與外部承包商臨時性員工合作。

儘管員工對復工非常期待,但工廠環境和作業方式將使降低傳染變得困難。截至 4 月 26 日,Alameda 郡共報告 1,468 例武漢肺炎病例,52 例死亡,特斯拉工廠大部分員工都住在這區。

選擇在 4 月 29 日部分員工提前復工,對特斯拉意義不僅是工廠恢復營運,也是 4 月 29 日發表第一季財報的日子,投資者會很樂見工廠恢復生產。加州超級工廠生產 Model Y、Model 3、Model X、Model S 電動車,據 Credit Suisse 的分析師估計,關閉後特斯拉每週至少虧損 3 億美元。

關於汽車製造公司何時恢復營運、保障員工安全仍有許多爭議,豐田、Volkswagen、Hyundai 等汽車廠商都計劃 5 月初恢復生產,但汽車工人聯合會代表認為,過早恢復生產對員工非常危險。

(合作媒體:。首圖來源:)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

如何在 asp.net core 3.x 的 startup.cs 文件中獲取注入的服務

一、前言

從 18 年開始接觸 .NET Core 開始,在私底下、工作中也開始慢慢從傳統的 mvc 前後端一把梭,開始轉向 web api + vue,之前自己有個半成品的 asp.net core 2.2 的項目模板,最近幾個月的時間,私下除了學習 Angular 也在對這個模板基於 asp.net core 3.1 進行慢慢補齊功能

因為涉及到底層框架大版本升級,由於某些 breaking changes 必定會造成之前的某些寫法沒辦法繼續使用,趁着端午節假期,在改造模板時,發現沒辦法通過構造函數注入的形式在 Startup 文件中注入某些我需要的服務了,因此本篇文章主要介紹如何在 asp.net core 3.x 的 startup 文件中獲取注入的服務

二、Step by Step

2.1、問題案例

這個問題的發現源於我需要改造模型驗證失敗時返回的錯誤信息,如果你有嘗試的話,在 3.x 版本中你會發現在 Startup 類中,我們沒辦法通過構造函數注入的方式再注入任何其它的服務了,這裏僅以我的代碼中需要解決的這個問題作為案例

在定義接口時,為了降低後期調整的複雜度,在接收參數時,一般會將參數包裝成一個 dto 對象(data transfer object – 數據傳輸對象),不管是提交數據,還是查詢數據,對於這個 dto 中的某些屬性,都會存在一定的卡控,例如 xxx 字段不能為空了,xxx 字段的長度不能超過 30

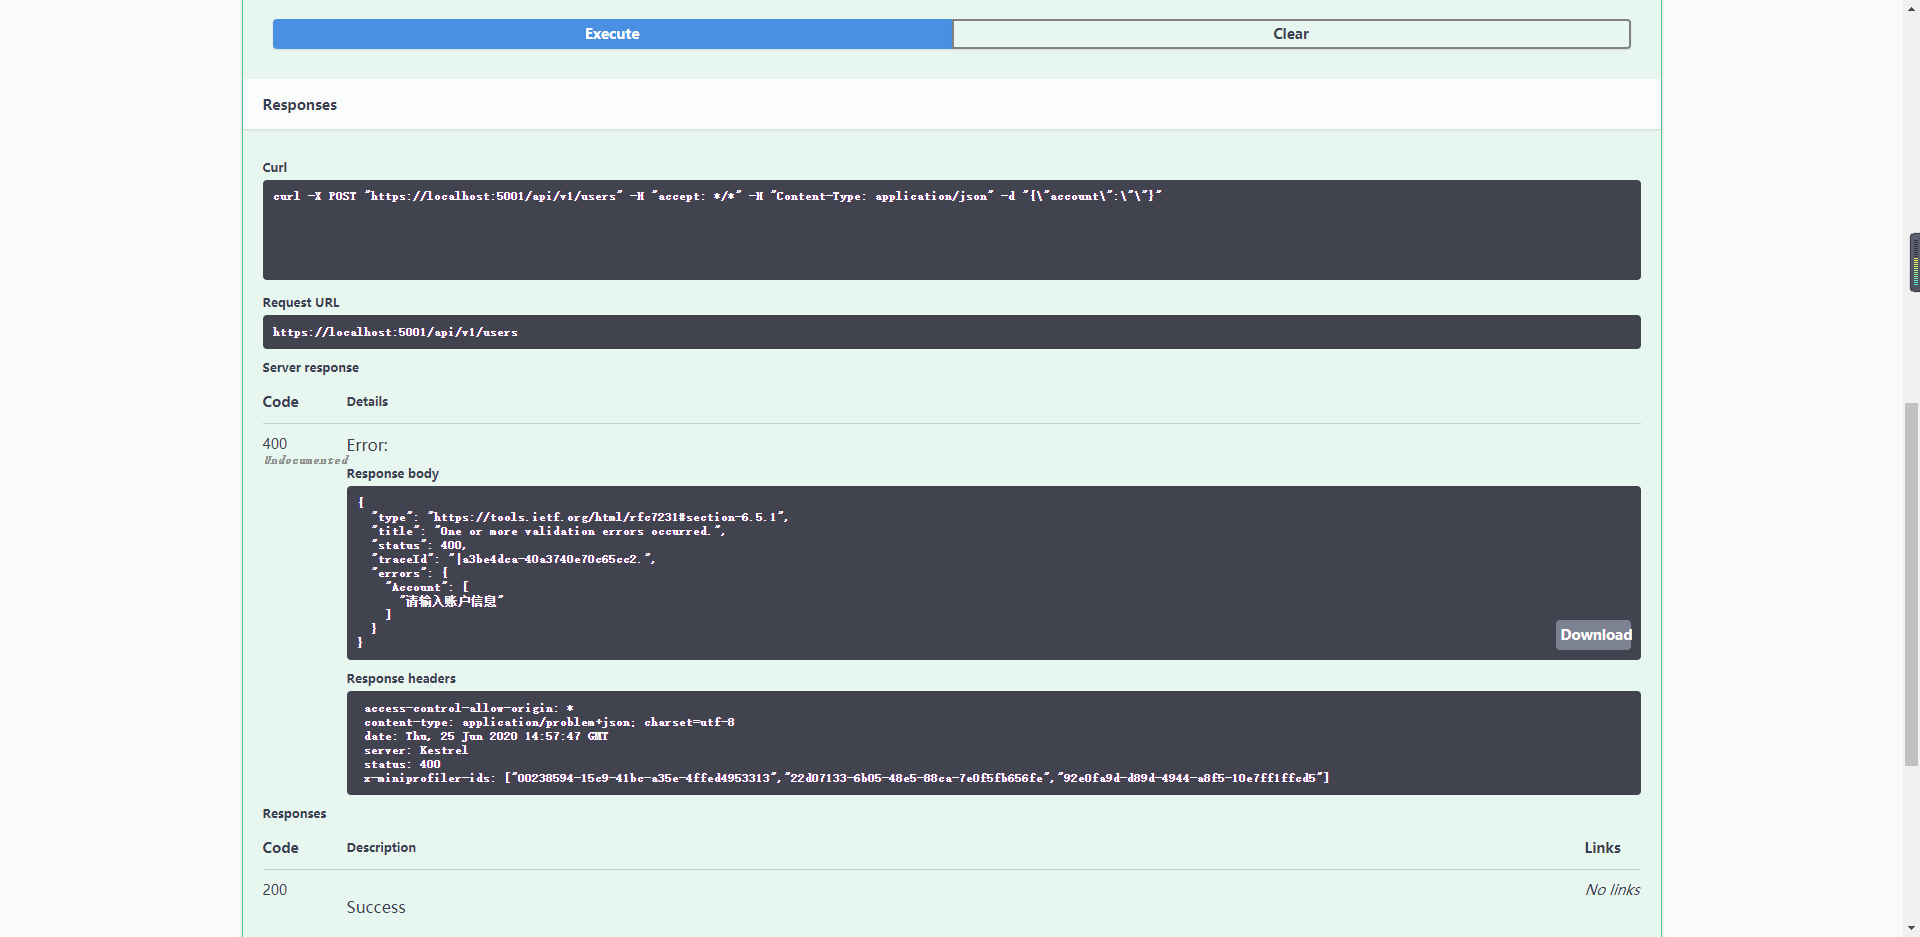
而在 asp.net core 中,因為會自動進行模型驗證,當不符合 dto 中的屬性要求時,接口會自動返回錯誤信息,默認的返回信息如下圖所示

可以看到,因為這裏其實是按照 rfc7231這個 RFC 協議返回的錯誤信息,這個並不符合我的要求,因此這裏我需要改寫這個返回的錯誤信息

自定義 asp.net core 的模型驗證錯誤信息方法有很多種,我的實現方法如下,因為我需要記錄請求的標識 Id 和錯誤日誌,所以這裏我需要將 ILogger 和 IHttpContextAccessor 注入到 Startup 類中

/// <summary>
/// 修改模型驗證錯誤返回信息
/// </summary>
/// <param name="services">服務容器集合</param>
/// <param name="logger">日誌記錄實例</param>
/// <param name="httpContextAccessor"></param>
/// <returns></returns>
public static IServiceCollection AddCustomInvalidModelState(this IServiceCollection services,
    ILogger<Startup> logger, IHttpContextAccessor httpContextAccessor)
{
    services.Configure<ApiBehaviorOptions>(options =>
    {
        options.InvalidModelStateResponseFactory = actionContext =>
        {
            // 獲取驗證不通過的字段信息
            //
            var errors = actionContext.ModelState.Where(e => e.Value.Errors.Count > 0)
                .Select(e => new ApiErrorDto
                {
                    Title = "請求參數不符合字段格式要求",
                    Message = e.Value.Errors.FirstOrDefault()?.ErrorMessage
                }).ToList();

            var result = new ApiReturnDto<object>
            {
                TraceId = httpContextAccessor.HttpContext.TraceIdentifier,
                Status = false,
                Error = errors
            };

            logger.LogError($"接口請求參數格式錯誤: {JsonConvert.SerializeObject(result)}");

            return new BadRequestObjectResult(result);
        };
    });

    return services;
}

在 asp.net core 2.x 版本中,你完全可以像在別的類中採用構造函數注入的方式一樣直接注入使用

public class Startup
{
    /// <summary>
    /// 日誌記錄實例
    /// </summary>
    private readonly ILogger<Startup> _logger;

    /// <summary>
    /// Http 請求實例
    /// </summary>
    private readonly IHttpContextAccessor _httpContextAccessor;

    /// <summary>
    /// ctor
    /// </summary>
    /// <param name="configuration"></param>
    /// <param name="logger"></param>
    /// <param name="httpContextAccessor"></param>
    public Startup(IConfiguration configuration, ILogger<Startup> logger, IHttpContextAccessor httpContextAccessor)
    {
        Configuration = configuration ?? throw new ArgumentNullException(nameof(configuration));
        _logger = logger ?? throw new ArgumentNullException(nameof(logger));
        _httpContextAccessor = httpContextAccessor ?? throw new ArgumentNullException(nameof(httpContextAccessor));
    }

    /// <summary>
    /// 配置實例
    /// </summary>
    public IConfiguration Configuration { get; }

    /// <summary>
    /// This method gets called by the runtime. Use this method to add services to the container.
    /// </summary>
    public void ConfigureServices(IServiceCollection services)
    {
        //注入的其它服務

        // 返回自定義的模型驗證錯誤信息
        services.AddCustomInvalidModelState(_logger, _httpContextAccessor);
    }
}

但是當你直接遷移到 asp.net core 3.x 版本后,你會發現程序會報如下的錯誤,很常見的一個依賴注入的錯誤,源頭直指我們通過構造函數注入的 ILogger、IHttpContextAccessor 接口

2.2、解決方法

根本原因

通過查閱 stackoverflow 發現了這樣的一個問題:How do I write logs from within Startup.cs,在最高贊的回答中提到了在泛型主機(GenericHostBuilder)中,沒辦法注入除 IConfiguration 之外的任何服務到 Startup類中,而泛型主機則是在 asp.net core 3.0 中添加的功能

查了下升級日誌,從中可以看到,在泛型主機中, Startup 類的構造函數注入只支持 IHostEnvironment、 IWebHostEnvironment、IConfiguration ,嗯,不好好看別人文檔的鍋

為什麼使用 WebHostBuilder可以,換成 GenericHostBuilder 就不行了呢

按照正常的邏輯來說,對於一個 asp.net core 應用,原則上來說只有有一個根級(root)的依賴注入容器,但是因為我們在 Startup 類中通過構造函數注入的形式注入服務時,告訴程序了我需要這個服務的實例,從而導致在構建 WebHost 時存在了一個單獨的容器,並且這個容器只包含了我們需要使用到的服務信息,之後,因為會創建了一個包含完整服務的依賴注入容器,這裏就會存在一個服務哪怕是單例的也可能會存在註冊兩次的問題,這無疑有些不太合乎規範

在推行泛型主機之後,嚴格控制了只會存在一個依賴注入容器,而所有的服務都是在 Startup.ConfigureServices 方法執行完成后才會註冊到依賴注入容器中,因此沒辦法像之前一樣在根容器註冊完成之前通過構造函數注入的形式使用

解決方案

如果你需要在 Startup.Configure 方法中使用自定義的服務,因為這裏已經完成了各種服務的註冊,和之前一樣,我們直接在方法簽名中包含需要使用到的服務即可

public void Configure(IApplicationBuilder app, IHostEnvironment env, ILogger<Startup> logger)
{
    logger.LogInformation("在 Configure 中使用自定義的服務");
}

如果你需要在 Startup.ConfigureServices 中使用的話,則需要換一種方法

最簡單的方法,直接替換泛型主機為原來的 WebHostBuilder,這樣就可以直接在 Startup 類中注入各種服務接口了,不過,考慮到這一改動其實是在開倒車,所以這裏不推薦採用這種方法

既然沒辦法正向通過依賴注入容器來自動創建我們需要的服務實例,是不是可以通過服務容器,手動去獲取我們需要的服務,也就是被稱為服務定位(Service Locator)的方式來獲取實例

當然,這似乎與依賴注入的思想相左,對於依賴注入來說,我們將所有需要使用的服務定義好,在應用啟動前完成註冊,之後在使用時由依賴注入容器提供服務的實例即可,而服務定位則是我們已經知道存在這個服務了,從容器中獲取出來然後由自己手動的創建實例

雖然服務定位是一種反模式,但是在某些情況下,我們又不得不採用

這裏對於本篇文章開篇中需要解決的問題,我也是採用服務定位的方式,通過構建一個 ServiceProvider 之後,手動的從容器中獲取需要使用的服務實例,調整后的代碼如下

/// <summary>
/// 添加自定義模型驗證失敗時返回的錯誤信息
/// </summary>
/// <param name="services">服務容器集合</param>
/// <returns></returns>
public static IServiceCollection AddCustomInvalidModelState(this IServiceCollection services)
{
    // 構建一個服務的提供程序
    var provider = services.BuildServiceProvider();

    // 獲取需要使用的服務實例
    //
    var logger = provider.GetRequiredService<ILogger<Startup>>();
    var httpContextAccessor = provider.GetRequiredService<IHttpContextAccessor>();

    services.Configure<ApiBehaviorOptions>(options =>
    {
        options.InvalidModelStateResponseFactory = actionContext =>
        {
            // 獲取失敗信息
            //
            var errors = actionContext.ModelState.Where(e => e.Value.Errors.Count > 0)
                .Select(e => new ApiErrorMessageDto
                {
                    Title = "Request parameters do not meet the field requirements",
                    Message = e.Value.Errors.FirstOrDefault()?.ErrorMessage
                }).ToList();

            var result = new ApiResponseDto<object>
            {
                TraceId = httpContextAccessor.HttpContext.TraceIdentifier,
                Status = false,
                Error = errors
            };

            logger.LogError($"接口請求參數格式錯誤: {JsonSerializer.Serialize(result)}");

            return new BadRequestObjectResult(result);
        };
    });

    return services;
}

對於配置一些需要基於某些服務的服務,這裏也可以通過委託的形式獲取到需要使用的服務實例,示例代碼如下

public void ConfigureServices(IServiceCollection services)
{
    services.AddSingleton<IMyService>((container) =>
    {
        var logger = container.GetRequiredService<ILogger<MyService>>();
        return new MyService
        {
            Logger = logger
        };
    });
}

三、參考資料

  • ASP.NET Core 3.0 的新增功能

  • Generic Host restricts Startup constructor injection

  • 依賴注入模式

  • Avoiding Startup service injection in ASP.NET Core 3

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

dubbo源碼解析之負載均衡

在分佈式系統中,負載均衡是必不可少的一個模塊,dubbo 中提供了五種負載均衡的實現,在閱讀這塊源碼之前,建議先學習負載均衡的基礎知識。把看源碼當做一個印證自己心中所想的過程,這樣會得到事半功倍的效果

以下源碼分析基於 dubbo 2.77 版本

類結構

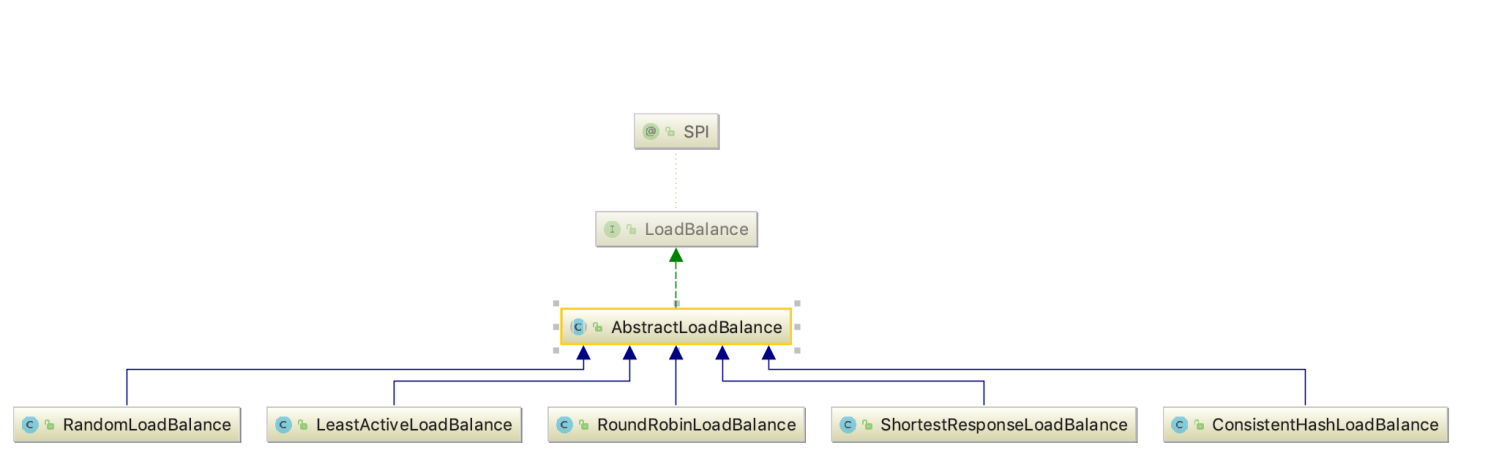
先來看一下這一塊的類結構圖

大部分算法都是在權重比的基礎上進行負載均衡,RandomLoadBalance 是默認的算法

類型 描述 是否默認 是否加權
RandomLoadBalance 隨機 是 是,默認權重相同
RoundRobinLoadBalance 輪訓 否 是,默認權重相同
LeastActiveLoadBalance 最少活躍數調用 否 不完全是,默認權重相同,僅在活躍數相同時按照權重比隨機
ConsistentHashLoadBalance 一致性hash 否 否
ShortestResponseLoadBalance 最短時間調用 否 不完全是,默認權重相同,僅在預估調用相同時按照權重比隨機

AbstractLoadBalance

AbstractLoadBalance 對一些通用的操作做了處理,是一個典型的模板方法模式的實現

select 方法只做一些簡單的範圍校驗,具體的實現有子類通過 doSelect 方法去實現

    @Override
    public <T> Invoker<T> select(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        if (CollectionUtils.isEmpty(invokers)) {
            return null;
        }
        if (invokers.size() == 1) {
            return invokers.get(0);
        }
        return doSelect(invokers, url, invocation);
    }

getWeight方法封裝了獲取一個調用者的權重值的方法,並加入了預熱處理

    int getWeight(Invoker<?> invoker, Invocation invocation) {
        int weight;
        URL url = invoker.getUrl();
        // Multiple registry scenario, load balance among multiple registries.
        // 註冊中心不需要預熱
        if (REGISTRY_SERVICE_REFERENCE_PATH.equals(url.getServiceInterface())) {
            weight = url.getParameter(REGISTRY_KEY + "." + WEIGHT_KEY, DEFAULT_WEIGHT);
        } else {
            // 獲取配置的權重值
            weight = url.getMethodParameter(invocation.getMethodName(), WEIGHT_KEY, DEFAULT_WEIGHT);
            if (weight > 0) {
                // 獲取服務提供者啟動時的時間戳
                long timestamp = invoker.getUrl().getParameter(TIMESTAMP_KEY, 0L);
                if (timestamp > 0L) {
                    //  獲取啟動時長
                    long uptime = System.currentTimeMillis() - timestamp;
                    // 當前時間小於服務提供者啟動時間,直接給一個最小權重1
                    if (uptime < 0) {
                        return 1;
                    }
                    // 獲取預熱時間
                    int warmup = invoker.getUrl().getParameter(WARMUP_KEY, DEFAULT_WARMUP);
                    // 如果小於預熱時間,計算權重
                    if (uptime > 0 && uptime < warmup) {
                        weight = calculateWarmupWeight((int)uptime, warmup, weight);
                    }
                }
            }
        }
        // 取與零比較的最大值,保證不會出現負值權重
        return Math.max(weight, 0);
    }

calculateWarmupWeight 方法用來計算權重,保證隨着預熱時間的增加,權重逐漸達到設置的權重

    static int calculateWarmupWeight(int uptime, int warmup, int weight) {
        // 運行時間/(預熱時間/權重)
        int ww = (int) ( uptime / ((float) warmup / weight));
        // 保證計算的權重最小值是1,並且不能超過設置的權重
        return ww < 1 ? 1 : (Math.min(ww, weight));
    }

RandomLoadBalance

隨機調用是負載均衡算法中最常用的算法之一,也是 dubbo 的默認負載均衡算法,實現起來也較為簡單
隨機調用的缺點是在調用量比較少的情況下,有可能出現不均勻的情況

	@Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // Number of invokers
        int length = invokers.size();
        // Every invoker has the same weight?
        boolean sameWeight = true;
        // the weight of every invokers
        int[] weights = new int[length];
        // the first invoker's weight
        int firstWeight = getWeight(invokers.get(0), invocation);
        weights[0] = firstWeight;
        // The sum of weights
        int totalWeight = firstWeight;
        for (int i = 1; i < length; i++) {
            int weight = getWeight(invokers.get(i), invocation);
            // save for later use
            // 依次把權重放到數組對應的位置
            weights[i] = weight;
            // Sum
            // 累加權重
            totalWeight += weight;
            // 如果出現權重不一樣的,sameWeight 設為false
            if (sameWeight && weight != firstWeight) {
                sameWeight = false;
            }
        }
        if (totalWeight > 0 && !sameWeight) {
            // If (not every invoker has the same weight & at least one invoker's weight>0), select randomly based on totalWeight.
            // 在總權重裏面隨機選擇一個偏移量
            int offset = ThreadLocalRandom.current().nextInt(totalWeight);
            // Return a invoker based on the random value.
            for (int i = 0; i < length; i++) {
                offset -= weights[i];
                // 依次用偏移量減去當前權重,小於0說明選中
                if (offset < 0) {
                    return invokers.get(i);
                }
            }
        }
        // If all invokers have the same weight value or totalWeight=0, return evenly.
        // 如果所有的調用者有同樣的權重或者總權重為0,則隨機選擇一個
        return invokers.get(ThreadLocalRandom.current().nextInt(length));
    }

RoundRobinLoadBalance

輪訓算法避免了隨機算法在小數據量產生的不均勻問題,我個人認為,輪訓算法可以理解為隨機算法的一種特例,在大量請求的情況下,從調用次數看,和隨機並無區別,主要區別在於短時間內的調用分配上

加權輪訓算法給人的直觀感受,實現起來並不複雜,算出一權重總量,依次調用即可
例如A,B,C 三個節點的權重比依次 1,200,1000,如果依次輪訓調用,就會出現先調用A 10 次,再調用B 200次,最後調用 C 1000次,不斷重複前面的過程
但這樣有一個問題,我們可以發現C 被練習調用1000次,會對C瞬間造成很大的壓力

dubbo的新版本採用的是平滑加權輪詢算法,輪訓的過程中節點之間穿插調用,可以避免了上面說的問題,因此這塊源碼看起來會稍有難度

輪訓算法 在dubbo 在升級的過程中,做過多次優化,有興趣的可以去了解下該算法的優化過程,也是件很有意思的事情

public class RoundRobinLoadBalance extends AbstractLoadBalance {
    public static final String NAME = "roundrobin";

    private static final int RECYCLE_PERIOD = 60000;

    protected static class WeightedRoundRobin {
        // 權重值
        private int weight;
        // 當前權重值
        private AtomicLong current = new AtomicLong(0);
        // 最後一次使用該對象時間
        private long lastUpdate;

        public int getWeight() {
            return weight;
        }

        public void setWeight(int weight) {
            this.weight = weight;
            current.set(0);
        }

        // 獲取自增權重基數的當前權重值
        public long increaseCurrent() {
            return current.addAndGet(weight);
        }

        public void sel(int total) {
            current.addAndGet(-1 * total);
        }

        public long getLastUpdate() {
            return lastUpdate;
        }

        // 設置最後一次更新時間戳
        public void setLastUpdate(long lastUpdate) {
            this.lastUpdate = lastUpdate;
        }
    }

    private ConcurrentMap<String, ConcurrentMap<String, WeightedRoundRobin>> methodWeightMap = new ConcurrentHashMap<String, ConcurrentMap<String, WeightedRoundRobin>>();

    /**
     * get invoker addr list cached for specified invocation
     * <p>
     * <b>for unit test only</b>
     *
     * @param invokers
     * @param invocation
     * @return
     */
    protected <T> Collection<String> getInvokerAddrList(List<Invoker<T>> invokers, Invocation invocation) {
        String key = invokers.get(0).getUrl().getServiceKey() + "." + invocation.getMethodName();
        Map<String, WeightedRoundRobin> map = methodWeightMap.get(key);
        if (map != null) {
            return map.keySet();
        }
        return null;
    }

    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // {group}/{interfaceName}:{version} + methoName 獲取當前消費者的唯一標示
        String key = invokers.get(0).getUrl().getServiceKey() + "." + invocation.getMethodName();
        // 獲取對應的 WeightedRoundRobin map,如果不存在,new 一個map放進去
        ConcurrentMap<String, WeightedRoundRobin> map = methodWeightMap.computeIfAbsent(key, k -> new ConcurrentHashMap<>());
        int totalWeight = 0;
        long maxCurrent = Long.MIN_VALUE;
        long now = System.currentTimeMillis();
        Invoker<T> selectedInvoker = null;
        WeightedRoundRobin selectedWRR = null;
        for (Invoker<T> invoker : invokers) {
            // 服務提供者在的唯一標識
            String identifyString = invoker.getUrl().toIdentityString();
            int weight = getWeight(invoker, invocation);
            WeightedRoundRobin weightedRoundRobin = map.computeIfAbsent(identifyString, k -> {
                WeightedRoundRobin wrr = new WeightedRoundRobin();
                wrr.setWeight(weight);
                return wrr;
            });
            // 如果權重改變了,更新 weightedRoundRobin 裏面權重的值
            if (weight != weightedRoundRobin.getWeight()) {
                //weight changed
                weightedRoundRobin.setWeight(weight);
            }
            // 當前權重自增自身權重
            long cur = weightedRoundRobin.increaseCurrent();
            // 設置最後一次更新時間戳
            weightedRoundRobin.setLastUpdate(now);
            // 如果當前權重大於最大當前權重
            if (cur > maxCurrent) {
                // 重置最大當前權重的值
                maxCurrent = cur;
                // 把當前提供者設為選中的提供者
                selectedInvoker = invoker;
                // 把當前輪訓權重實例設為選中
                selectedWRR = weightedRoundRobin;
            }
            // 累計總權重
            totalWeight += weight;
        }
        // 提供者有變化
        if (invokers.size() != map.size()) {
            // 超過60s沒有使用,刪除掉
            map.entrySet().removeIf(item -> now - item.getValue().getLastUpdate() > RECYCLE_PERIOD);
        }
        if (selectedInvoker != null) {
            // 減去總權重
            // 關於這個地方為什麼要減去總權重,是一個很容易造成迷惑的地方
            // 我的理解:每一次調用循環 每個提供者的 當前權重 都會自增自己的權重
            // 因此在選中后(只有一個被選中),再減去總權重,正好保證了所有 WeightedRoundRobin 中當前權重之和永遠等於0
            selectedWRR.sel(totalWeight);
            return selectedInvoker;
        }
        // 理論上不會走到這個地方
        // should not happen here
        return invokers.get(0);
    }

}

LeastActiveLoadBalance

最少活躍數調用算法是指在調用時判斷此時每個服務提供者此時正在處理的請求個數,選取最小的調用

dubbo 在實現該算法時的具體邏輯如下

  1. 選取所有活躍數最少的提供者
  2. 如果只有一個,直接返回
  3. 如果權重不同,加權隨機選擇一個
  4. 如果權重相同,隨機選擇一個
    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // Number of invokers
        int length = invokers.size();
        // The least active value of all invokers
        // 最少活躍數量
        int leastActive = -1;
        // The number of invokers having the same least active value (leastActive)
        // 有同樣活躍值的提供者數量
        int leastCount = 0;
        // The index of invokers having the same least active value (leastActive)
        int[] leastIndexes = new int[length];
        // the weight of every invokers
        // 每一個提供者的權重
        int[] weights = new int[length];
        // The sum of the warmup weights of all the least active invokers
        // 最少活躍提供者的總權重
        int totalWeight = 0;
        // The weight of the first least active invoker
        int firstWeight = 0;
        // Every least active invoker has the same weight value?
        // 所有的最少活躍提供者是否擁有同樣的權重值
        boolean sameWeight = true;


        // Filter out all the least active invokers
        for (int i = 0; i < length; i++) {
            Invoker<T> invoker = invokers.get(i);
            // Get the active number of the invoker
            // 活躍數量
            int active = RpcStatus.getStatus(invoker.getUrl(), invocation.getMethodName()).getActive();
            // Get the weight of the invoker's configuration. The default value is 100.
            // 獲取權重值
            int afterWarmup = getWeight(invoker, invocation);
            // save for later use
            // 保存權重留着後面用
            weights[i] = afterWarmup;
            // If it is the first invoker or the active number of the invoker is less than the current least active number
            // 如果是第一個提供者,或者當前活躍數量比最少的少
            if (leastActive == -1 || active < leastActive) {
                // Reset the active number of the current invoker to the least active number
                // 重置最少活躍數量
                leastActive = active;
                // Reset the number of least active invokers
                // 重置最少活躍提供者的數量
                leastCount = 1;
                // Put the first least active invoker first in leastIndexes
                // 把最少活躍提供者的索引保存起來
                leastIndexes[0] = i;
                // Reset totalWeight
                // 重置總權重
                totalWeight = afterWarmup;
                // Record the weight the first least active invoker
                // 記錄第一個最少活躍提供者的權重
                firstWeight = afterWarmup;
                // Each invoke has the same weight (only one invoker here)
                // 每個最少活躍提供者是否有同樣的權重???
                sameWeight = true;
                // If current invoker's active value equals with leaseActive, then accumulating.
                // 如果當前活躍數量等於最少活躍數量
            } else if (active == leastActive) {
                // Record the index of the least active invoker in leastIndexes order
                // 最少活躍提供者的索引依次放入 leastIndexes
                leastIndexes[leastCount++] = i;
                // Accumulate the total weight of the least active invoker
                // 累計最少活躍提供者的總權重
                totalWeight += afterWarmup;
                // If every invoker has the same weight?
                // 如果當前權重和第一個最少活躍的權重不同,sameWeight 設為false
                if (sameWeight && afterWarmup != firstWeight) {
                    sameWeight = false;
                }
            }
        }
        // Choose an invoker from all the least active invokers
        // 最少活躍提供者只有一個,直接返回
        if (leastCount == 1) {
            // If we got exactly one invoker having the least active value, return this invoker directly.
            return invokers.get(leastIndexes[0]);
        }
        // 如擁有不同的權重,在權重的基礎上隨機選取一個,可以參考 RandomLoadBalance,有同樣的寫法
        if (!sameWeight && totalWeight > 0) {
            // If (not every invoker has the same weight & at least one invoker's weight>0), select randomly based on 
            // totalWeight.
            int offsetWeight = ThreadLocalRandom.current().nextInt(totalWeight);
            // Return a invoker based on the random value.
            for (int i = 0; i < leastCount; i++) {
                int leastIndex = leastIndexes[i];
                offsetWeight -= weights[leastIndex];
                if (offsetWeight < 0) {
                    return invokers.get(leastIndex);
                }
            }
        }
        // 權重相同,隨機選取一個
        // If all invokers have the same weight value or totalWeight=0, return evenly.
        return invokers.get(leastIndexes[ThreadLocalRandom.current().nextInt(leastCount)]);
    }

ShortestResponseLoadBalance

最短時間調用調用算法是指預估出來每個處理完請求的提供者所需時間,然後又選擇最少最短時間的提供者進行調用,整體處理邏輯和最少活躍數算法基本相似

dubbo 在實現該算法時的具體邏輯如下

  1. 選取所有預估處理時間最短的提供者
  2. 如果只有一個,直接返回
  3. 如果權重不同,加權隨機選擇一個
  4. 如果權重相同,隨機選擇一個
    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // Number of invokers
        int length = invokers.size();
        // Estimated shortest response time of all invokers
        // 最少響應時間
        long shortestResponse = Long.MAX_VALUE;
        // The number of invokers having the same estimated shortest response time
        // 最少響應時間的提供者數量
        int shortestCount = 0;
        // The index of invokers having the same estimated shortest response time
        int[] shortestIndexes = new int[length];
        // the weight of every invokers
        int[] weights = new int[length];
        // The sum of the warmup weights of all the shortest response  invokers
        // 最少響應時間的提供者的總權重
        int totalWeight = 0;
        // The weight of the first shortest response invokers
        // 第一個最少響應時間的權重
        int firstWeight = 0;
        // Every shortest response invoker has the same weight value?
        // 所有的最少響應時間提供者是否擁有同樣的權重值
        boolean sameWeight = true;

        // Filter out all the shortest response invokers
        for (int i = 0; i < length; i++) {
            Invoker<T> invoker = invokers.get(i);
            RpcStatus rpcStatus = RpcStatus.getStatus(invoker.getUrl(), invocation.getMethodName());
            // Calculate the estimated response time from the product of active connections and succeeded average elapsed time.
            //  平均響應成功時間
            long succeededAverageElapsed = rpcStatus.getSucceededAverageElapsed();
            // 活躍的連接連接數量
            int active = rpcStatus.getActive();
            // 預估響應時間
            long estimateResponse = succeededAverageElapsed * active;
            // 獲取權重值
            int afterWarmup = getWeight(invoker, invocation);
            // 保存權重留着後面用
            weights[i] = afterWarmup;
            // Same as LeastActiveLoadBalance
            // 如果預估時間小於最少的響應時間
            if (estimateResponse < shortestResponse) {
                // 重置最少響應時間
                shortestResponse = estimateResponse;
                // 最少響應時間的提供者數量設為1
                shortestCount = 1;
                // 保存提供者下標
                shortestIndexes[0] = i;
                // 重置最少響應時間的提供者的總權重
                totalWeight = afterWarmup;
                // 重置第一個最少響應時間的權重
                firstWeight = afterWarmup;
                sameWeight = true;
                // 如果當前最少響應時間等於最少響應時間
            } else if (estimateResponse == shortestResponse) {
                // 最少最少響應時間的下標依次放入 shortestIndexes
                shortestIndexes[shortestCount++] = i;
                // 累計最少響應時間的總權重
                totalWeight += afterWarmup;
                // 如果當前權重和第一個最少響應時間的權重不同,sameWeight 設為false
                if (sameWeight && i > 0
                        && afterWarmup != firstWeight) {
                    sameWeight = false;
                }
            }
        }
        // 最少最少響應時間只有一個,直接返回
        if (shortestCount == 1) {
            return invokers.get(shortestIndexes[0]);
        }
        // 如擁有不同的權重,在權重的基礎上隨機選取一個,可以參考 RandomLoadBalance,有同樣的寫法
        if (!sameWeight && totalWeight > 0) {
            int offsetWeight = ThreadLocalRandom.current().nextInt(totalWeight);
            for (int i = 0; i < shortestCount; i++) {
                int shortestIndex = shortestIndexes[i];
                offsetWeight -= weights[shortestIndex];
                if (offsetWeight < 0) {
                    return invokers.get(shortestIndex);
                }
            }
        }
        // 權重相同,隨機選取一個
        return invokers.get(shortestIndexes[ThreadLocalRandom.current().nextInt(shortestCount)]);
    }

ConsistentHashLoadBalance

一致性hash算法是一種廣泛應用與分佈式緩存中的算法,該算法的優勢在於新增和刪除節點后,只有少量請求發生變動,大部分請求仍舊映射到原來的節點
為了防止節點過少,造成節點分佈不均勻,一般採用虛擬節點的方式,dubbo默認的是160個虛擬節點

網上關於一致性hash算法的文章有很多,這裏就不再多贅述,以下是dubbo中的實現,需要說明的是, 一致性hash算法中權重配置不起作用

    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        String methodName = RpcUtils.getMethodName(invocation);
        // {group}/{interfaceName}:{version} + methoName 獲取當前消費者的唯一標示
        String key = invokers.get(0).getUrl().getServiceKey() + "." + methodName;
        // using the hashcode of list to compute the hash only pay attention to the elements in the list
        int invokersHashCode = invokers.hashCode();
        // 獲取當前消費者的一致性hash選擇器
        ConsistentHashSelector<T> selector = (ConsistentHashSelector<T>) selectors.get(key);
        // 如果 selector 還沒初始化,或者 invokers 已經變化,重新初始化 selector
        if (selector == null || selector.identityHashCode != invokersHashCode) {
            selectors.put(key, new ConsistentHashSelector<T>(invokers, methodName, invokersHashCode));
            selector = (ConsistentHashSelector<T>) selectors.get(key);
        }
        return selector.select(invocation);
    }
    // 一致性hash選擇器
    private static final class ConsistentHashSelector<T> {

        // 存儲hash環的數據結構 節點 -> 提供者
        private final TreeMap<Long, Invoker<T>> virtualInvokers;

        // 虛擬節點數量
        private final int replicaNumber;

        // 用來標示所有提供者是唯一標示
        private final int identityHashCode;
        // 用來存儲計算hash值參數下標的數組,例如計算第一個和第三個參數 該數組為[0,2]
        private final int[] argumentIndex;

        ConsistentHashSelector(List<Invoker<T>> invokers, String methodName, int identityHashCode) {
            this.virtualInvokers = new TreeMap<Long, Invoker<T>>();
            this.identityHashCode = identityHashCode;
            URL url = invokers.get(0).getUrl();
            // 虛擬節點數量,默認 160
            this.replicaNumber = url.getMethodParameter(methodName, HASH_NODES, 160);
            // 默認只對第一個參數進行hash
            String[] index = COMMA_SPLIT_PATTERN.split(url.getMethodParameter(methodName, HASH_ARGUMENTS, "0"));
            argumentIndex = new int[index.length];
            for (int i = 0; i < index.length; i++) {
                argumentIndex[i] = Integer.parseInt(index[i]);
            }
            for (Invoker<T> invoker : invokers) {
                String address = invoker.getUrl().getAddress();
                // 關於這個地方為什麼要除以4,我理解的是md5後為16字節的數組,計算hash值只需要用到四個字節,所以可以用四次
                // 因此除以4,算是一個性能優化點
                for (int i = 0; i < replicaNumber / 4; i++) {
                    // md5, 獲得一個長度為16的字節數組
                    byte[] digest = md5(address + i);
                    for (int h = 0; h < 4; h++) {
                        // 如果h=0,則用第0,1,2,3四個字節進行位運算,得出一個0-2^32-1的值
                        // 如果h=1,則用第4,5,6,7四個字節進行位運算,得出一個0-2^32-1的值
                        // 如果h=2,則用第8,9,10,11四個字節進行位運算,得出一個0-2^32-1的值
                        // 如果h=3,則用第12,13,14,15四個字節進行位運算,得出一個0-2^32-1的值
                        long m = hash(digest, h);
                        virtualInvokers.put(m, invoker);
                    }
                }
            }
        }

        public Invoker<T> select(Invocation invocation) {
            String key = toKey(invocation.getArguments());
            byte[] digest = md5(key);
            return selectForKey(hash(digest, 0));
        }
        // 根據配置生成計算hash值的key
        private String toKey(Object[] args) {
            StringBuilder buf = new StringBuilder();
            for (int i : argumentIndex) {
                if (i >= 0 && i < args.length) {
                    buf.append(args[i]);
                }
            }
            return buf.toString();
        }

        private Invoker<T> selectForKey(long hash) {
            // 找到hash值在hash環上的位置
            // ceilingEntry 方法返回大於或者等於當前key的鍵值對
            Map.Entry<Long, Invoker<T>> entry = virtualInvokers.ceilingEntry(hash);
            // 如果返回為空,說明落在了hash環中2的32次方-1的最後,直接返回第一個
            if (entry == null) {
                entry = virtualInvokers.firstEntry();
            }
            return entry.getValue();
        }
        // 得出一個0-2^32-1的值, 四個字節組成一個長度為32位的二進制数字並轉化為long值
        private long hash(byte[] digest, int number) {
            return (((long) (digest[3 + number * 4] & 0xFF) << 24)
                    | ((long) (digest[2 + number * 4] & 0xFF) << 16)
                    | ((long) (digest[1 + number * 4] & 0xFF) << 8)
                    | (digest[number * 4] & 0xFF))
                    & 0xFFFFFFFFL;
        }

        private byte[] md5(String value) {
            MessageDigest md5;
            try {
                md5 = MessageDigest.getInstance("MD5");
            } catch (NoSuchAlgorithmException e) {
                throw new IllegalStateException(e.getMessage(), e);
            }
            md5.reset();
            byte[] bytes = value.getBytes(StandardCharsets.UTF_8);
            md5.update(bytes);
            return md5.digest();
        }

    }

總結

以上就是dubbo負載均衡源碼的全部解析,如果還是不明白,可以看下官方文檔的解析  
http://dubbo.apache.org/zh-cn/docs/source_code_guide/loadbalance.html

dubbo的負載均衡算法總體來說並不複雜,代碼寫的也很優雅,簡潔,看起來很舒服,而且有很多細節的處理值得稱讚,例如預熱處理,輪訓算法的平滑處理等。

我們平時使用時,可以根據自己的業務場景,選擇適合自己的算法,當然,一般情況下,默認的的隨機算法就能滿足我們的日常需求,而且隨機算法的性能足夠好。

如果覺得dubbo提供的五種算法都不能滿足自己的需求,還可以通過dubbo的SPI機制很方便的擴展自己的負載均衡算法。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?
歐盟2020年環保目標難達陣 生物多樣性挑戰尤多

摘錄自2019年12月4日中央社報導

聯合國氣候變化綱要公約第25次締約方會議(COP25)2日在西班牙馬德里開議,將持續至13日。歐洲環保署在配合會議出版的報告中指出,儘管大部分原定2020年達成的環保目標勢必已無法達成,尤其是在生物多樣性領域,歐盟仍有機會實現為2030年和2050年設定的較長遠目標。

報告強調,有鑑於生物多樣性降低的程度令人憂心、氣候變遷衍生的多方面衝擊日益嚴重,以及天然資源遭過度消耗,歐洲必須在未來10年儘速行動。

報告指出,儘管1990至2017年期間,歐洲的溫室氣體排放量已減少22%,且再生能源的使用比例也提升,歐洲在環保領域仍有進步空間。

根據歐洲環保署,在為2020年設定的13個生物多樣性政策目標中,只有兩個達標:劃設海洋保護區和陸地保護區。然而,物種、天然棲地、水生態系統、溼地和土壤狀況的保護,以及化學物排放與空氣和噪音的污染,仍令人擔憂。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?
德國總理許諾為汽車製造商掃除法律障礙 推動無人車、電動車研發

德國總理安格拉•默克爾稱,自動駕駛汽車很快便能在德國進行上路測試,許諾為汽車製造商們掃除法律障礙。

德國擁有全球最大的幾家汽車製造商。安格拉•默克爾表示,德國汽車行業應該起草一份請願書提交柏林,以加快無人駕駛汽車的研發與推出,請願書中最好附上時間規劃。

目前,全球的汽車製造商都在致力於研發自動駕駛汽車,然而其原型至少將在2020年才能獲得推出。安格拉•默克爾12日在柏林的一次工業活動中透露,德國政府機關將於5月底舉行會議,討論下一步工作計畫,如若待辦事項均已完成,內閣便可開始推進車輛測試相關法律依據的制定工作。她告知戴姆勒集團CEO蔡澈(Dieter Zetsche)等稱,“這一話題在政府內部並不存在爭議。”

德國政府還考慮支持電動車的研發工作,拉動消費者需求。然而德國內政部長朔伊布勒(Wolfgang Schaeuble)上月表示,政府機關會設法支援電動車研發,但可能無法滿足汽車製造商們的所有願望。

德國工業領袖已經向政府施壓,要求推出激勵措施拉動電動車需求增長,並稱如果德國想要保持在汽車製造行業領先,那麼推出激勵措施是必需的。

社會民主黨資深議員Hubertus Heil則對此表示,執政聯盟將在本週三的會議上就相關問題達成一致,“我相信我們能夠說服朔伊布勒。”

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

PCA降維的原理、方法、以及python實現。

參考:菜菜的sklearn教學之降維算法.pdf!!

PCA(主成分分析法)

1. PCA(最大化方差定義或者最小化投影誤差定義)是一種無監督算法,也就是我們不需要標籤也能對數據做降維,這就使得其應用範圍更加廣泛了。那麼PCA的核心思想是什麼呢?

  • 例如D維變量構成的數據集,PCA的目標是將數據投影到維度為K的子空間中,要求K<D且最大化投影數據的方差。這裏的K值既可以指定,也可以利用主成分的信息來確定。
  • PCA其實就是方差與協方差的運用。
  • 降維的優化目標:將一組 N 維向量降為 K 維,其目標是選擇 K 個單位正交基,使得原始數據變換到這組基上后,各變量兩兩間協方差為 0,而變量方差則盡可能大(在正交的約束下,取最大的 K 個方差)。

2. PCA存在的問題:

  • 原來的數據中比如包括了年齡,性別,身高等指標降維后的數據既然維度變小了,那麼每一維都是什麼含義呢?這個就很難解釋了,所以PCA本質來說是無法解釋降維后的數據的物理含義,換句話說就是降維完啦計算機能更好的認識這些數據,但是咱們就很難理解了。
  • PCA對數據有兩個假設:數據必須是連續數值型;數據中沒有缺失值。
  • 過擬合:PCA 保留了主要信息,但這個主要信息只是針對訓練集的,而且這個主要信息未必是重要信息。有可能捨棄了一些看似無用的信息,但是這些看似無用的信息恰好是重要信息,只是在訓練集上沒有很大的表現,所以 PCA 也可能加劇了過擬合;

3. PCA的作用:

  • 緩解維度災難:PCA 算法通過捨去一部分信息之後能使得樣本的採樣密度增大(因為維數降低了),這是緩解維度災難的重要手段;
  • 降噪:當數據受到噪聲影響時,最小特徵值對應的特徵向量往往與噪聲有關,將它們捨棄能在一定程度上起到降噪的效果;
  • 特徵獨立:PCA 不僅將數據壓縮到低維,它也使得降維之後的數據各特徵相互獨立;

4. 方差的作用:咱們可以想象一下,如果一群人都堆疊在一起,我們想區分他們是不是比較困難,但是如果這群人站在馬路兩側,我們就可以很清晰的判斷出來應該這是兩伙人。所以基於方差我們可以做的就是讓方差來去判斷咱們數據的擁擠程度,在這裏我們認為方差大的應該辨識度更高一些,因為分的比較開(一條馬路給隔開啦)。方差可以度量數值型數據的,數據若是想要區分開來,他那他們的離散程度就需要比較大,也就是方差比較大。

5. 協方差的作用:

6. 計算過程:(下圖為採用特徵值分解的計算過程,若採用SVM算法,則無需計算協方差矩陣!)

為什麼我們需要協方差矩陣?我們最主要的目的是希望能把方差和協方差統一到一個矩陣里,方便後面的計算。

  假設我們只有 a 和 b 兩個變量,那麼我們將它們按行組成矩陣 X:(與matlab不同的是,在numpy中每一列表示每個樣本的數據,每一行表示一個變量。比如矩陣X,該矩陣表示的意義為:有m個樣本點,每個樣本點由兩個變量組成!)

  然後:


  Cov(a,a) = E[(a-E(a))(a-E(a))], Cov(b,a) = E[(b-E(b))(a-E(a))],因為E(b)=E(a)=0,所以大大簡化了計算!!!(這就體現了去中心化的作用!)

  我們可以看到這個矩陣對角線上的分別是兩個變量的方差,而其它元素是 a 和 b 的協方差。兩者被統一到了一個矩陣里。

7. 特徵值與特徵向量的計算方法—--特徵值分解與奇異值分解法(SVD)(有關特徵值與奇異值可見我的博文!)

(1) 特徵值分解的求解過程較為簡單,以下圖為例子

(2) 特徵值分解存在的缺點:

  • 特徵值分解中要求協方差矩陣A必須是方陣,即規模必須為n*n。
  • 後期計算最小投影維度K時,計算量過大。
  • 當樣本維度很高時,協方差矩陣計算太慢;

(3) SVD算法(奇異值分解)的提出克服這些缺點,目前幾乎所有封裝好的PCA算法內部採用的都是SVD算法進行特徵值、特徵向量以及K值的求解。

  • 奇異值(每個矩陣都有):設A是一個mXn矩陣,稱正半定矩陣A‘A的特徵值的非負平方根為矩陣A的奇異值,其中A‘表示矩陣A的共扼轉置矩陣(實數矩陣的共軛就是轉置矩陣,複數矩陣的共軛轉置矩陣就是上面所說的行列互換后每個元素取共軛)
  • 只有方陣才有特徵值。

(4) SVD算法的計算過程:(numpy中已經將SVD進行了封裝,所以只需要調用即可)

可以發現,採用SVD算法無需計算協方差矩陣,這樣在數據量非常大的時候可以降低消耗。

  • A為數據矩陣,大小為M*N(2*5)
  • U是一個由與數據點之間具有最小投影誤差的方向向量所構成的矩陣,大小為M*M(2*2),假如想要將數據由M維降至K維,只需要從矩陣U中選擇前K個列向量,得到一個M*K的矩陣,記為Ureduce。按照下面的公式即可計算降維后的新數據:降維后的數據矩陣G = A.T * Ureduce. 
  • sigma為一個列向量,其包含的值為矩陣A的奇異值。
  • VT是一個大小為N*N的矩陣,具體意義我們無需了解。

利用python實現PCA降維(採用SVD的方法):

 1 from numpy import linalg as la
 2 import numpy as np
 3 #1.矩陣A每個變量的均值都為0,所以不用進行“去平均值”處理。倘若矩陣A的每個變量的均值不為0,則首先需要對數據進行預處理
 4 #  才可以進行協方差矩陣的求解。
 5 #2.與matlab不同的是,在numpy中每一列表示每個樣本的數據,每一行表示一個變量。
 6 #  比如矩陣A,該矩陣表示的意義為:有5個樣本點,每個樣本點由兩個變量組成!
 7 #3.np.mat()函數中矩陣的乘積可以使用 * 或 .dot()函數
 8 #  array()函數中矩陣的乘積只能使用 .dot()函數。而星號乘(*)則表示矩陣對應位置元素相乘,與numpy.multiply()函數結果相同。
 9 A = np.mat([[-1, -1, 0, 2, 0], [-2, 0, 0, 1, 1]])
10 # A = np.mat([[-1, -2], [-1, 0], [0, 0], [2, 1], [0, 1]]).T
11 U, sigma, VT = la.svd(A)
12 print("U:")
13 print(U)
14 print("sigma:")
15 print(sigma)
16 print("VT:")
17 print(VT)
18 print("-"*30)
19 print("降維前的數據:")
20 print(A.T)
21 print("降維后的數據:")
22 print(A.T * U[:,0])

運行結果圖:與上文採用特徵值分解所得到的降維結果一致!

8.PCA的重建

 眾所周知,PCA可以將高維數據壓縮為較少維度的數據,由於維度有所減少,所以PCA屬於有損壓縮,也就是,壓縮后的數據沒有保持原來數據的全部信息,根據壓縮數據無法重建原本的高維數據,但是可以看作原本高維數據的一種近似。

 還原的近似數據矩陣Q = 降維后的矩陣G * Ureduce.T

9.採用sklearn封裝好的PCA實現數據降維(採用的是SVD算法):

 1 import numpy as np
 2 from sklearn.decomposition import PCA
 3 # 利用sklearn進行PCA降維處理的時候,數據矩陣A的行數表示數據的個數,數據矩陣A的列數表示每條數據的維度。這與numpy中是相反的!
 4 # A = np.mat([[-1, -1, 0, 2, 0], [-2, 0, 0, 1, 1]]).T
 5 A = np.mat([[-1, -2], [-1, 0], [0, 0], [2, 1], [0, 1]])
 6 pca = PCA(n_components = 1)
 7 pca.fit(A)
 8 # 投影后的特徵維度的方差比例
 9 print(pca.explained_variance_ratio_)
10 # 投影后的特徵維度的方差
11 print(pca.explained_variance_)
12 print(pca.transform(A))

 可以發現,採用sklearn封裝的方法實現PCA與上文的方法達到的結果一致!

10.如何確定主成分數量(針對於Sklearn封裝的PCA方法而言)

PCA算法將D維數據降至K維,顯然K是需要選擇的參數,表示要保持信息的主成分數量。我們希望能夠找到一個K值,既能大幅降低維度,又能最大限度地保持原有數據內部的結構信息。實現的過程是通過SVD方法得到的S矩陣進行操作求解,


11.sklearn中封裝的PCA方法的使用介紹。

PCA的函數原型

 (1)主要參數介紹

n_components

  • 這個參數類型有int型,float型,string型,默認為None。 它的作用是指定PCA降維后的特徵數(也就是降維后的維度)。 
  • 若取默認(None),則n_components==min(n_samples, n_features),即降維后特徵數取樣本數和原有特徵數之間較小的那個;
  • 若n_components}設置為‘mle’並且svd_solver設置為‘full’則使用MLE算法根據特徵的方差分佈自動去選擇一定數量的主成分特徵來降維; 
  • 若0<n_components<1,則n_components的值為主成分方差的閾值; 通過設置該變量,即可調整主成分數量K。
  • 若n_components≥1,則降維后的特徵數為n_components; 

copy

  •  bool (default True) 
  • 在運行算法時,將原始訓練數據複製一份。參數為bool型,默認是True,傳給fit的原始訓練數據X不會被覆蓋;若為False,則傳給fit后,原始訓練數據X會被覆蓋。 

whiten

  • bool, optional (default False)
  • 是否對降維后的數據的每個特徵進行歸一化。參數為bool型,默認是False。

(2)主要方法介紹:

fit(X,y=None) :用訓練數據X訓練模型,由於PCA是無監督降維,因此y=None。 

transform(X,y=None) :對X進行降維。 

fit_transform(X) :用訓練數據X訓練模型,並對X進行降維。相當於先用fit(X),再用transform(X)。 

inverse_transform(X) :將降維后的數據轉換成原始數據。(PCA的重建)

 (3)主要屬性介紹:

components:array, shape (n_components, n_features) ,降維后各主成分方向,並按照各主成分的方差值大小排序。 

explained_variance:array, shape (n_components,) ,降維后各主成分的方差值,方差值越大,越主要。 

explained_variance_ratio:array, shape (n_components,) ,降維后的各主成分的方差值佔總方差值的比例,比例越大,則越主要。 

singular_values:array, shape (n_components,) ,奇異值分解得到的前n_components個最大的奇異值。


 二、LDA

1. 類間距離最大,類內距離最小(核心思想)

2. LDA的原理,公式推導見西瓜書,這裏主要講一下PCA與LDA的異同點!

  • PCA為非監督降維,LDA為有監督降維PCA希望投影后的數據方差盡可能的大(最大可分性),因為其假設方差越多,則所包含的信息越多;而LDA則希望投影后相同類別的組內方差小,而組間方差大。LDA能合理運用標籤信息,使得投影后的維度具有判別性,不同類別的數據盡可能的分開。舉個簡單的例子,在語音識別領域,如果單純用PCA降維,則可能功能僅僅是過濾掉了噪聲,還是無法很好的區別人聲,但如果有標籤識別,用LDA進行降維,則降維后的數據會使得每個人的聲音都具有可分性,同樣的原理也適用於臉部特徵識別。
  • 所以,可以歸納總結為有標籤就盡可能的利用標籤的數據(LDA),而對於純粹的非監督任務,則還是得用PCA進行數據降維。
  • LDA降維最低可以降維到(類別數-1),而PCA沒有限制


參考資料:https://zhuanlan.zhihu.com/p/77151308?utm_source=qq&utm_medium=social&utm_oi=1095998405318430720

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

HtmlSpanner 使用小結 — 安卓解析html

如何利用 HtmlSpanner解析 HTML格式 的字符串:

1. GitHub 下載HtmlSpanner項目 https://github.com/NightWhistler/HtmlSpanner

2. 最好是直接放在java目錄下在,這樣不需要改引用的包路徑

3.  引入需要的依賴包

    implementation 'net.sourceforge.htmlcleaner:htmlcleaner:2.21'
    implementation 'com.osbcp:cssparser:1.7'

  4. 使用方法:

 // 頁面上用於展示 html格式的文本布局
 TextView textView = findViewById(R.id.htmlSpanner);
 // 直接 new一個 HtmlSpanner對象
 HtmlSpanner htmlSpanner = new HtmlSpanner(); // 格式化
 // 解析 html得到 spannable對象
 Spannable spannable1 = htmlSpanner.fromHtml("<span style='color:red'>html格式的文字1</span>");
 // 显示到 TextView上
 textView.setText(spannable1);

 5. 在使用中遇到的問題——當富文本中顏色格式是rgb格式,解析失敗


 解決思路:

  1. 首先我們解析的是style=’color:rgb(0,255,255)’ 這種格式,於是看源碼覺得 CSSCompiler 這個類很有問題

  2. 找與顏色相關的於是就找到了 parseCSSColor( String colorString ) 這個方法,看起來就是轉換顏色用的

  3. 源碼的寫法如下:(是沒有對於rgb格式的算法,所以不能解析就很合理啦)


   4. 想法修改:( 遇到 0rgb格式就先處理成我們的 hex格式,這樣不就完美了嘛 )

  5. 工具類代碼如下:

package com.xxx.xxx.xxx;

public class ColorUtil {

     /**
     * rgb 格式的顏色轉 hex格式顏色
     * @param rgb
     * @return
     */
    public static String rgb2hex(String rgb) {
        int r = 0;
        int g = 0;
        int b = 0;
        int left = rgb.indexOf("(");
        int right = rgb.indexOf(")");
        if (left > -1 && right > -1 && right > left) {
            String substring = rgb.substring(left + 1, right);
            String[] split = substring.split(",");
            if (split.length == 3){
                r = Integer.valueOf(split[0].trim());
                g = Integer.valueOf(split[1].trim());
                b = Integer.valueOf(split[2].trim());
            }
        }
        String rFString, rSString, gFString, gSString,
                bFString, bSString, result;
        int red, green, blue;
        int rred, rgreen, rblue;
        red = r / 16;
        rred = r % 16;
        if (red == 10) rFString = "A";
        else if (red == 11) rFString = "B";
        else if (red == 12) rFString = "C";
        else if (red == 13) rFString = "D";
        else if (red == 14) rFString = "E";
        else if (red == 15) rFString = "F";
        else rFString = String.valueOf(red);

        if (rred == 10) rSString = "A";
        else if (rred == 11) rSString = "B";
        else if (rred == 12) rSString = "C";
        else if (rred == 13) rSString = "D";
        else if (rred == 14) rSString = "E";
        else if (rred == 15) rSString = "F";
        else rSString = String.valueOf(rred);

        rFString = rFString + rSString;

        green = g / 16;
        rgreen = g % 16;

        if (green == 10) gFString = "A";
        else if (green == 11) gFString = "B";
        else if (green == 12) gFString = "C";
        else if (green == 13) gFString = "D";
        else if (green == 14) gFString = "E";
        else if (green == 15) gFString = "F";
        else gFString = String.valueOf(green);

        if (rgreen == 10) gSString = "A";
        else if (rgreen == 11) gSString = "B";
        else if (rgreen == 12) gSString = "C";
        else if (rgreen == 13) gSString = "D";
        else if (rgreen == 14) gSString = "E";
        else if (rgreen == 15) gSString = "F";
        else gSString = String.valueOf(rgreen);

        gFString = gFString + gSString;

        blue = b / 16;
        rblue = b % 16;

        if (blue == 10) bFString = "A";
        else if (blue == 11) bFString = "B";
        else if (blue == 12) bFString = "C";
        else if (blue == 13) bFString = "D";
        else if (blue == 14) bFString = "E";
        else if (blue == 15) bFString = "F";
        else bFString = String.valueOf(blue);

        if (rblue == 10) bSString = "A";
        else if (rblue == 11) bSString = "B";
        else if (rblue == 12) bSString = "C";
        else if (rblue == 13) bSString = "D";
        else if (rblue == 14) bSString = "E";
        else if (rblue == 15) bSString = "F";
        else bSString = String.valueOf(rblue);
        bFString = bFString + bSString;
        result = "#" + rFString + gFString + bFString;
        return result;
    }
}


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?
Redis 的底層數據結構(壓縮列表)

上一篇我們介紹了 redis 中的整數集合這種數據結構的實現,也談到了,引入這種數據結構的一個很大的原因就是,在某些僅有少量整數元素的集合場景,通過整數集合既可以達到字典的效率,也能使用遠少於字典的內存達到同樣的效果。

我們本篇介紹的壓縮列表,相信你從他的名字里應該也能看出來,又是一個為了節約內存而設計的數據結構,它的數據結構相對於整數集合來說會複雜了很多,但是整數集合只能允許存儲少量的整型數據,而我們的壓縮列表可以允許存儲少量的整型數據或字符串。

這是他們之間的一個區別,下面我們來看看這種數據結構。

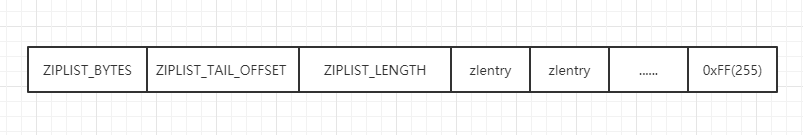
一、基本的結構定義

  • ZIPLIST_BYTES:四個字節,記錄了整個壓縮列表總共佔用了多少字節數
  • ZIPLIST_TAIL_OFFSET:四個字節,記錄了整個壓縮列表第一個節點到最後一個節點跨越了多少個字節,通故這個字段可以迅速定位到列表最後一個節點位置
  • ZIPLIST_LENGTH:兩個字節,記錄了整個壓縮列表中總共包含幾個 zlentry 節點
  • zlentry:非固定字節,記錄的是單個節點,這是一個複合結構,我們等下再說
  • 0xFF:一個字節,十進制的值為 255,標誌壓縮列表的結尾

其中,zlentry 在 redis 中確實有着這樣的結構體定義,但實際上這個結構定義了一堆類似於 length 這樣的字段,記錄前一個節點和自身節點佔用的字節數等等信息,用處不多,而我們更傾向於使用這樣的邏輯結構來描述 zlentry 節點。

這種結構在 redis 中是沒有具體結構體定義的,請知悉,網上的很多博客文章都直接描述 zlentry 節點是這樣的一種結構,其實是不準確的。

簡單解釋一下這三個字段的含義:

  • previous_entry_length:每個節點會使用一個或者五個字節來描述前一個節點佔用的總字節數,如果前一個節點佔用的總字節數小於 254,那麼就用一個字節存儲,反之如果前一個節點佔用的總字節數超過了 254,那麼一個字節就不夠存儲了,這裡會用五個字節存儲並將第一個字節的值存儲為固定值 254 用於區分。
  • encoding:壓縮列表可以存儲 16位、32位、64位的整數以及字符串,encoding 就是用來區分後面的 content 字段中存儲於的到底是哪種內容,分別佔多少字節,這個我們等下細說。
  • content:沒什麼特別的,存儲的就是具體的二進制內容,整數或者字符串。

下面我們細說一個 encoding 具體是怎麼存儲的。

主要分為兩種,一種是字符串的存儲格式:

編碼 編碼長度 content類型
00xxxxxx 一個字節 長度小於 63 的字符串
01xxxxxx xxxxxxxx 兩個字節 長度小於 16383 的字符串
10xxxxxx xxxxxxxx xxxxxxxx xxxxxxxx xxxxxxxx 五個字節 長度小於 4294967295 的字符串

content 的具體長度,由編碼除去高兩位剩餘的二進制位表示。

編碼 編碼長度 content類型
11000000 一個字節 int16_t 類型的整數
11010000 一個字節 int32_t 類型的整數
11100000 一個字節 int64_t 類型的整數
11110000 一個字節 24 位有符號整數
11111110 一個字節 8 位有符號整數

注意,整型數據的編碼是固定 11 開頭的八位二進制,而字符串類型的編碼都是非固定的,因為它還需要通過後面的二進制位得到字符串的長度,稍有區別。

這就是壓縮列表的基本的結構定義情況,下面我們通過節點的增刪改查方法源碼實現來看看 redis 中具體的實現情況。

二、redis 的具體源碼實現

1、ziplistNew

我們先來看看壓縮列表初始化的方法實現:

unsigned char *ziplistNew(void) {
    //bytes=2*4+2
    //分配壓縮列表結構所需要的字節數
    //ZIPLIST_BYTES + ZIPLIST_TAIL_OFFSET + ZIPLIST_LENGTH
    unsigned int bytes = ZIPLIST_HEADER_SIZE+1;
    unsigned char *zl = zmalloc(bytes);
    //初始化 ZIPLIST_BYTES 字段
    ZIPLIST_BYTES(zl) = intrev32ifbe(bytes);
    //初始化 ZIPLIST_TAIL_OFFSET
    ZIPLIST_TAIL_OFFSET(zl) = intrev32ifbe(ZIPLIST_HEADER_SIZE);
    //初始化 ZIPLIST_LENGTH 字段
    ZIPLIST_LENGTH(zl) = 0;
    //為壓縮列表最後一個字節賦值 255
    zl[bytes-1] = ZIP_END;
    return zl;
}

2、ziplistPush

接着我們看新增節點的源碼實現:

unsigned char *ziplistPush(unsigned char *zl, unsigned char *s
        ,unsigned int slen, int where) {
    unsigned char *p;
    //找到待插入的位置,頭部或者尾部
    p = (where == ZIPLIST_HEAD) ? ZIPLIST_ENTRY_HEAD(zl) : ZIPLIST_ENTRY_END(zl);
    return __ziplistInsert(zl,p,s,slen);
}

解釋一下 ziplistPush 的幾個入參的含義。

zl 指向一個壓縮列表的首地址,s 指向一個字符串首地址),slen 指向字符串的長度(如果節點存儲的值是整型,存儲的就是整型值),where 指明新節點的插入方式,頭插亦或尾插。

ziplistPush 方法的核心是 __ziplistInsert:

unsigned char *__ziplistInsert(unsigned char *zl, unsigned char *p, unsigned char *s, unsigned int slen) {
    size_t curlen = intrev32ifbe(ZIPLIST_BYTES(zl)), reqlen;
    unsigned int prevlensize, prevlen = 0;
    size_t offset;
    int nextdiff = 0;
    unsigned char encoding = 0;
    long long value = 123456789; 
    zlentry tail;
    //prevlensize 存儲前一個節點長度,本節點使用了幾個字節 1 or 5
    //prelen  存儲前一個節點實際佔用了幾個字節
    if (p[0] != ZIP_END) {
        ZIP_DECODE_PREVLEN(p, prevlensize, prevlen);
    } else {
        unsigned char *ptail = ZIPLIST_ENTRY_TAIL(zl);
        if (ptail[0] != ZIP_END) {
            prevlen = zipRawEntryLength(ptail);
        }
    }
    if (zipTryEncoding(s,slen,&value,&encoding)) {
        //s 指針指向一個整數,嘗試進行一個轉換並得到存儲這個整數佔用了幾個字節
        reqlen = zipIntSize(encoding);
    } else {
        //s 指針指向一個字符串(字符數組),slen 就是他佔用的字節數
        reqlen = slen;
    }
    //當前節點存儲數據佔用 reqlen 個字節,加上存儲前一個節點長度佔用的字節數
    reqlen += zipStorePrevEntryLength(NULL,prevlen);
    //encoding 字段存儲實際佔用字節數
    reqlen += zipStoreEntryEncoding(NULL,encoding,slen);
    //至此,reqlen 保存了存儲當前節點數據佔用字節數和 encoding 編碼佔用的字節數總和
    int forcelarge = 0;
    //當前節點佔用的總字節減去存儲前一個節點字段佔用的字節
    //記錄的是這一個節點的插入會引起下一個節點佔用字節的變化量
    nextdiff = (p[0] != ZIP_END) ? zipPrevLenByteDiff(p,reqlen) : 0;
    if (nextdiff == -4 && reqlen < 4) {
        nextdiff = 0;
        forcelarge = 1;
    }
    //擴容有可能導致 zl 的起始位置偏移,故記錄 p 與 zl 首地址的相對偏差數,事後還原 p 指針指向
    offset = p-zl;
    zl = ziplistResize(zl,curlen+reqlen+nextdiff);
    p = zl+offset;
    if (p[0] != ZIP_END) {
        memmove(p+reqlen,p-nextdiff,curlen-offset-1+nextdiff);
        //把當前節點佔用的字節數存儲到下一個節點的頭部字段
        if (forcelarge)
            zipStorePrevEntryLengthLarge(p+reqlen,reqlen);
        else
            zipStorePrevEntryLength(p+reqlen,reqlen);

        //更新 tail_offset 字段,讓他保存從頭節點到尾節點之間的距離
        ZIPLIST_TAIL_OFFSET(zl) =
            intrev32ifbe(intrev32ifbe(ZIPLIST_TAIL_OFFSET(zl))+reqlen);
        zipEntry(p+reqlen, &tail);
        if (p[reqlen+tail.headersize+tail.len] != ZIP_END) {
            ZIPLIST_TAIL_OFFSET(zl) =
                intrev32ifbe(intrev32ifbe(ZIPLIST_TAIL_OFFSET(zl))+nextdiff);
        }
    } else {
        ZIPLIST_TAIL_OFFSET(zl) = intrev32ifbe(p-zl);
    }
    //是否觸發連鎖更新
    if (nextdiff != 0) {
        offset = p-zl;
        zl = __ziplistCascadeUpdate(zl,p+reqlen);
        p = zl+offset;
    }
    //將節點寫入指定位置
    p += zipStorePrevEntryLength(p,prevlen);
    p += zipStoreEntryEncoding(p,encoding,slen);
    if (ZIP_IS_STR(encoding)) {
        memcpy(p,s,slen);
    } else {
        zipSaveInteger(p,value,encoding);
    }
    ZIPLIST_INCR_LENGTH(zl,1);
    return zl;
}

具體細節我不再贅述,總結一下整個插入節點的步驟。

  1. 計算並得到前一個節點的總長度,並判斷得到當前待插入節點保存前一個節點長度的 previous_entry_length 佔用字節數
  2. 根據傳入的 s 和 slen,計算並保存 encoding 字段內容
  3. 構建節點並將數據寫入節點添加到壓縮列表中

ps:重點要去理解壓縮列表節點的數據結構定義,previous_entry_length、encoding、content 字段,這樣才能比較容易理解節點新增操作的實現。

三、連鎖更新

談到 redis 的壓縮列表,就必然會談到他的連鎖更新,我們先引一張圖:

假設原本 entry1 節點佔用字節數為 211(小於 254),那麼 entry2 的 previous_entry_length 會使用一個字節存儲 211,現在我們新插入一個節點 NEWEntry,這個節點比較大,佔用了 512 個字節。

那麼,我們知道,NEWEntry 節點插入后,entry2 的 previous_entry_length 存儲不了 512,那麼 redis 就會重分配內存,增加 entry2 的內存分配,並分配給 previous_entry_length 五個字節存儲 NEWEntry 節點長度。

看似沒什麼問題,但是如果極端情況下,entry2 擴容四個字節后,導致自身佔用字節數超過 254,就會又觸發后一個節點的內存佔用空間擴大,非常極端情況下,會導致所有的節點都擴容,這就是連鎖更新,一次更新導致大量甚至全部節點都更新內存的分配。

如果連鎖更新發生的概率很高的話,壓縮列表無疑就會是一個低效的數據結構,但實際上連鎖更新發生的條件是非常苛刻的,其一是需要大量節點長度小於 254 連續串聯連接,其二是我們更新的節點位置恰好也導致后一個節點內存擴充更新。

基於這兩點,且少量的連鎖更新對性能是影響不大的,所以這裏的連鎖更新對壓縮列表的性能是沒有多大的影響的,可以忽略,但需要知曉。

同樣的,如果覺得我寫的對你有點幫助的話,順手點一波關注吧,也歡迎加作者微信深入探討,我們逐漸開始走近 redis 比較實用性的相關內容了,盡請關注。

關注公眾不迷路,一個愛分享的程序員。


公眾號回復「1024」加作者微信一起探討學習!


每篇文章用到的所有案例代碼素材都會上傳我個人 github


歡迎來踩!

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

自己實現 aop 和 spring aop

說到,我們可以在 BeanPostProcessor 中對 bean 的初始化前化做手腳,當時也說了,我完全可以生成一個代理類丟回去。

代理類肯定要為用戶做一些事情,不可能像學設計模式的時候創建個代理類,然後簡單的在前面打印一句話,後面打印一句話,這叫啥事啊,難怪當時聽不懂。最好是這個方法的前後過程可以自戶自己定義。

小明說,這還不好辦,cglib 已經有現成的了,jdk 也可以實現動態代理,看 mybatis 其實也是這麼乾的,不然你想它一個接口怎麼就能找到 xml 的實現呢,可以參照下 mybatis 的代碼。

所以首先學習下 cglib 和 jdk 的動態代理,我們來模擬下 mybatis 是如何通過接口來實現方法調用的

cglib

目標接口:

public interface UserOperator {
    User queryUserByName(String name);
}

代理處理類:

import net.sf.cglib.proxy.MethodInterceptor;
import net.sf.cglib.proxy.MethodProxy;

public class ProxyHandle implements MethodInterceptor{
    // 實現 MethodInterceptor 的代理攔截接口
    public Object intercept(Object obj, Method method, Object[] args, MethodProxy proxy) throws Throwable {
        System.out.println("獲取到 sqlId:"+method);
        System.out.println("獲取到執行參數列表:"+args[0]);
        System.out.println("解析 spel 表達式,並獲取到完整的 sql 語句");
        System.out.println("執行 sql ");
        System.out.println("結果集處理,並返回綁定對象");
        return new User("sanri",1);
    }
}

真正調用處:

Enhancer enhancer = new Enhancer();

enhancer.setSuperclass(UserOperator.class);
enhancer.setCallback(new ProxyHandle());

//可以把這個類添加進 ioc 容器,這就是真正的代理類
UserOperator userOperator = (UserOperator) enhancer.create();

User sanri = userOperator.queryByName("sanri");
System.out.println(sanri);

jdk

import java.lang.reflect.InvocationHandler;
public class ProxyHandler implements InvocationHandler {
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        System.out.println("獲取到 sqlId:"+method);
        System.out.println("獲取到執行參數列表:"+args[0]);
        System.out.println("解析 spel 表達式,並獲取到完整的 sql 語句");
        System.out.println("執行 sql ");
        System.out.println("結果集處理,並返回綁定對象");
        return new User("sanri",1);
    }
}

真正調用處:

UserOperator proxyInstance = (UserOperator)Proxy.newProxyInstance(ClassLoader.getSystemClassLoader(), new Class[]{UserOperator.class}, new ProxyHandler());
User sanri = proxyInstance.queryByName("sanri");
System.out.println(sanri);

注:jdk 只能支持代理接口,但 cglib 是接口和實體類都可以代理; jdk 是使用實現接口方式,可以多實現,但 cglib 是繼承方式,也支持接口方式。

代理模式和裝飾模式的區別:

從這也可以看到代理模式和裝飾模式的區別 ,代理模式的方法簽名一般是不動的,但裝飾模式是為了方法的增強,一般會使用別的更好的方法來代替原方法。

如何織入

回到正文,這時我們已經可以創建一個代理類了,如何把用戶行為給弄進來呢,哎,又只能 回調 了,我們把現場信息給用戶,用戶實現我的接口,然後我找到接口的所有實現類進行順序調用,但這時候小明想到了幾個問題

  • 用戶不一定每個方法都要做代理邏輯,可能只是部分方法需要,我們應該能夠識別出是哪些方法需要做代理邏輯 (Pointcut)
  • 方法加代理邏輯的位置,方法執行前(Before),方法執行后(After),方法返回數據后(AfterReturning),方法出異常后(AfterThrowing),自定義執行(Around)

根據單一職責原則,得寫五個接口,每個接口要包含 getPointCut() 方法和 handler() 方法,或者繞過單一職責原則,在一個接口中定義 6 個方法,用戶不想實現留空即可。總得來說,用戶只需要提交一份規則給我就行,這個規則你不管是用 json,xml ,或者 註解的方式,只要我能夠識別在 這個 pointcut 下,需要有哪些自定義行為,在另一個 pointcut 下又有哪些自定義行為即可。

現拿到用戶行為了和切點了,還需要創建目標類的代理類,並把行為給綁定上去,在什麼時候創建代理類呢,肯定在把 bean 交給容器的時候悄悄的換掉啊, 說到 bean 有一個生命周期是用於做所有 bean 攔截的,並且可以在初始化前和初始化後進行攔截,沒錯,就是 BeanPostProcessor 我們可以在初始化後生成代理類。

這裏需要注意,並不是所有類都需要創建代理。我們可以這樣檢測,讓 pointcut 提供一個方法用於匹配當前方法是否需要代理,當然這也是 pointcut 的職責,如果當前類有一個方法需要代理,那麼當前類是需要代理的,否則認為不需要代理,這麼做需要遍歷所有類的所有方法,如果運氣差的話,看上去很耗費性能 ,但 spring 也是這麼乾的。。。。。。優化的方案可以這麼玩,如果方法需要代理,在類上做一個標識,如果類上存在這個標識,則可以直接創建代理類。

現在我們把用戶行為綁定到代理類,根據上面 jdk 動態代理和 cglib 動態代理的學習,我們發現,它們都有一個共同的傢伙,那就是方法攔截,用於攔截目標類的當前正在執行的方法,並增強其功能,我們可以在創建代理類的時候找到所有的用戶行為並按照順序和類型依次綁定,可以用責任鏈模式。

看一下 spring 是怎麼玩的

spring 也是在 BeanPostProcessor 接口的 postProcessAfterInitialization 生命周期進行攔截,具體的類為 AspectJAwareAdvisorAutoProxyCreator

spring 配置切面有兩種方式,使用註解和使用配置,當然,現在流行註解的方式,更方便,但不管是配置還是註解,最後都會被解析成 Advisor(InstantiationModelAwarePointcutAdvisorImpl),spring 查找了所有實現 Advisor 的類,源代碼在 BeanFactoryAdvisorRetrievalHelper.findAdvisorBeans

advisorNames = BeanFactoryUtils.beanNamesForTypeIncludingAncestors(this.beanFactory, Advisor.class, true, false);

緊接着,spring 會使使用 Advisor 中的 pointcut 來看當前類是否需要創建代理類,跟進方法可以看到 canApply 方法中是遍歷了所有方法一個個匹配來看是否需要創建代理類的,如果有一個需要,則直接返回 true 。當然 spring 更嚴謹一些,它考慮到了可能有接口的方法需要有代理,我上面說在類加標識是不正確的。

然後通過 createProxy 創建了代理類,裏面有區分 cglib 還是 aop ,下面單拿 cglib 來說

在 CglibAopProxy.getProxy 中對類進行增強,主要看 Enhancer 類是如何設置的就好了,有一個 callback 參數 ,我們一般是第 0 個 callback 也即 DynamicAdvisedInterceptor 它是一個 cglib 的 MethodInterceptor

它重寫的是 MethodInterceptor 的 intercept 方法,下面看這個方法,this.advised 是前面傳過來的用戶行為,getInterceptorsAndDynamicInterceptionAdvice 把 Advisor 適配成了 org.aopalliance.intercept.MethodInterceptor 分別對應切面的五種行為

AbstractAspectJAdvice
  |- AspectJAfterReturningAdvice
  |- AspectJAfterAdvice implements org.aopalliance.intercept.MethodInterceptor
  |- AspectJAroundAdvice implements org.aopalliance.intercept.MethodInterceptor
  |- AspectJAfterThrowingAdvice implements org.aopalliance.intercept.MethodInterceptor
  |- AspectJMethodBeforeAdvice

最後它封裝一個執行器,根據順序調用攔截器鏈,也即用戶行為列表,封裝執行的時候是強轉 org.aopalliance.intercept.MethodInterceptor 來執行的,但 AspectJAfterReturningAdvice 和 AspectJMethodBeforeAdvice 沒有實現 org.aopalliance.intercept.MethodInterceptor 怎麼辦,所以 spring 在獲取用戶行為鏈的時候增加了一個適配器,專門用於把這兩種轉換成 MethodInterceptor

其它說明

  • cglib 的 callback 只能寫一個,filter 用於選擇是第幾個 callback ,不要認為也是鏈式的

  • spring aop 中有比較多的設計模式,學設計模式的可以看下這塊的源碼 ,至少責任鏈,適配器,動態代理都可以在這看到
  • 切面類中如果有兩個一樣的行為,比如有兩個 @Before,排序規則為看方法名的 ascii 碼值,只測試過,並沒經過源碼,有興趣的可以自己去看一下。

來個示例更容易理解

我們除了使用 @Aspect 註解把切面規則告訴 spring 外,也可以學本身 aop 的實現,我們自己定義一個 Advisor ,因為 spring 就是掃描這個的,然後實現 pointcut 和 invoke 方法,一樣可以實現 aop 。

聯繫上文: 我們來看看 spring 的 redis-cache 是如何做切面的

文章說到,主要工作的類是 CacheInterceptor 它是一個 org.aopalliance.intercept.MethodInterceptor

Advisor 是 BeanFactoryCacheOperationSourceAdvisor 也就是說創建代理類會掃描到這個類,最後執行會把其轉成 MethodInterceptor,因為它是一個 PointcutAdvisor ,查看 DefaultAdvisorChainFactory.getInterceptorsAndDynamicInterceptionAdvice 方法,第一個就是把 PointcutAdvisor 轉成 MethodInterceptor 繼續進入獲取攔截器的方法,可以知道就是獲取的 advice 屬性 CacheInterceptor

一點小推廣

創作不易,希望可以支持下我的開源軟件,及我的小工具,歡迎來 gitee 點星,fork ,提 bug 。

Excel 通用導入導出,支持 Excel 公式
博客地址:
gitee:

使用模板代碼 ,從數據庫生成代碼 ,及一些項目中經常可以用到的小工具
博客地址:
gitee:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

因應氣候變遷 財政部被賦要角

文:易淇馨(烏特勒支大學國際海洋與環境法碩士生)

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?