[springboot 開發單體web shop] 7. 多種形式提供商品列表

上文回顧

我們實現了仿jd的輪播廣告以及商品分類的功能,並且講解了不同的注入方式,本節我們將繼續實現我們的電商主業務,商品信息的展示。

需求分析

首先,在我們開始本節編碼之前,我們先來分析一下都有哪些地方會對商品進行展示,打開jd首頁,鼠標下拉可以看到如下:

可以看到,在大類型下查詢了部分商品在首頁進行展示(可以是最新的,也可以是網站推薦等等),然後點擊任何一個分類,可以看到如下:

我們一般進到電商網站之後,最常用的一個功能就是搜索, 結果如下:

選擇任意一個商品點擊,都可以進入到詳情頁面,這個是單個商品的信息展示。
綜上,我們可以知道,要實現一個電商平台的商品展示,最基本的包含:

  • 首頁推薦/最新上架商品
  • 分類查詢商品
  • 關鍵詞搜索商品
  • 商品詳情展示
  • …

接下來,我們就可以開始商品相關的業務開發了。

首頁商品列表|IndexProductList

開發梳理

我們首先來實現在首頁展示的推薦商品列表,來看一下都需要展示哪些信息,以及如何進行展示。

  • 商品主鍵(product_id)
  • 展示圖片(image_url)
  • 商品名稱(product_name)
  • 商品價格(product_price)
  • 分類說明(description)
  • 分類名稱(category_name)
  • 分類主鍵(category_id)
  • 其他…

編碼實現

根據一級分類查詢

遵循開發順序,自下而上,如果基礎mapper解決不了,那麼優先編寫SQL mapper,因為我們需要在同一張表中根據parent_id遞歸的實現數據查詢,當然我們這裏使用的是錶鏈接的方式實現。因此,common mapper無法滿足我們的需求,需要自定義mapper實現。

Custom Mapper實現

和根據一級分類查詢子分類一樣,在項目mscx-shop-mapper中添加一個自定義實現接口com.liferunner.custom.ProductCustomMapper,然後在resources\mapper\custom路徑下同步創建xml文件mapper/custom/ProductCustomMapper.xml,此時,因為我們在上節中已經配置了當前文件夾可以被容器掃描到,所以我們添加的新的mapper就會在啟動時被掃描加載,代碼如下:

/**
 * ProductCustomMapper for : 自定義商品Mapper
 */
public interface ProductCustomMapper {

    /***
     * 根據一級分類查詢商品
     *
     * @param paramMap 傳遞一級分類(map傳遞多參數)
     * @return java.util.List<com.liferunner.dto.IndexProductDTO>
     */
    List<IndexProductDTO> getIndexProductDtoList(@Param("paramMap") Map<String, Integer> paramMap);
}
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd">
<mapper namespace="com.liferunner.custom.ProductCustomMapper">
    <resultMap id="IndexProductDTO" type="com.liferunner.dto.IndexProductDTO">
        <id column="rootCategoryId" property="rootCategoryId"/>
        <result column="rootCategoryName" property="rootCategoryName"/>
        <result column="slogan" property="slogan"/>
        <result column="categoryImage" property="categoryImage"/>
        <result column="bgColor" property="bgColor"/>
        <collection property="productItemList" ofType="com.liferunner.dto.IndexProductItemDTO">
            <id column="productId" property="productId"/>
            <result column="productName" property="productName"/>
            <result column="productMainImageUrl" property="productMainImageUrl"/>
            <result column="productCreateTime" property="productCreateTime"/>
        </collection>
    </resultMap>
    <select id="getIndexProductDtoList" resultMap="IndexProductDTO" parameterType="Map">
        SELECT
        c.id as rootCategoryId,
        c.name as rootCategoryName,
        c.slogan as slogan,
        c.category_image as categoryImage,
        c.bg_color as bgColor,
        p.id as productId,
        p.product_name as productName,
        pi.url as productMainImageUrl,
        p.created_time as productCreateTime
        FROM category c
        LEFT JOIN products p
        ON c.id = p.root_category_id
        LEFT JOIN products_img pi
        ON p.id = pi.product_id
        WHERE c.type = 1
        AND p.root_category_id = #{paramMap.rootCategoryId}
        AND pi.is_main = 1
        LIMIT 0,10;
    </select>
</mapper>

Service實現

在serviceproject 創建com.liferunner.service.IProductService接口以及其實現類com.liferunner.service.impl.ProductServiceImpl,添加查詢方法如下:

public interface IProductService {

    /**
     * 根據一級分類id獲取首頁推薦的商品list
     *
     * @param rootCategoryId 一級分類id
     * @return 商品list
     */
    List<IndexProductDTO> getIndexProductDtoList(Integer rootCategoryId);
    ...
}

---
    
@Slf4j
@Service
@RequiredArgsConstructor(onConstructor = @__(@Autowired))
public class ProductServiceImpl implements IProductService {

    // RequiredArgsConstructor 構造器注入
    private final ProductCustomMapper productCustomMapper;

    @Transactional(propagation = Propagation.SUPPORTS)
    @Override
    public List<IndexProductDTO> getIndexProductDtoList(Integer rootCategoryId) {
        log.info("====== ProductServiceImpl#getIndexProductDtoList(rootCategoryId) : {}=======", rootCategoryId);
        Map<String, Integer> map = new HashMap<>();
        map.put("rootCategoryId", rootCategoryId);
        val indexProductDtoList = this.productCustomMapper.getIndexProductDtoList(map);
        if (CollectionUtils.isEmpty(indexProductDtoList)) {
            log.warn("ProductServiceImpl#getIndexProductDtoList未查詢到任何商品信息");
        }
        log.info("查詢結果:{}", indexProductDtoList);
        return indexProductDtoList;
    }
}

Controller實現

接着,在com.liferunner.api.controller.IndexController中實現對外暴露的查詢接口:

@RestController
@RequestMapping("/index")
@Api(value = "首頁信息controller", tags = "首頁信息接口API")
@Slf4j
public class IndexController {
    ...
    @Autowired
    private IProductService productService;

    @GetMapping("/rootCategorys")
    @ApiOperation(value = "查詢一級分類", notes = "查詢一級分類")
    public JsonResponse findAllRootCategorys() {
        log.info("============查詢一級分類==============");
        val categoryResponseDTOS = this.categoryService.getAllRootCategorys();
        if (CollectionUtils.isEmpty(categoryResponseDTOS)) {
            log.info("============未查詢到任何分類==============");
            return JsonResponse.ok(Collections.EMPTY_LIST);
        }
        log.info("============一級分類查詢result:{}==============", categoryResponseDTOS);
        return JsonResponse.ok(categoryResponseDTOS);
    }
    ...
}

Test API

編寫完成之後,我們需要對我們的代碼進行測試驗證,還是通過使用RestService插件來實現,當然,大家也可以通過Postman來測試,結果如下:

商品列表|ProductList

如開文之初我們看到的京東商品列表一樣,我們先分析一下在商品列表頁面都需要哪些元素信息?

開發梳理

商品列表的展示按照我們之前的分析,總共分為2大類:

  • 選擇商品分類之後,展示當前分類下所有商品
  • 輸入搜索關鍵詞后,展示當前搜索到相關的所有商品

在這兩類中展示的商品列表數據,除了數據來源不同以外,其他元素基本都保持一致,那麼我們是否可以使用統一的接口來根據參數實現隔離呢? 理論上不存在問題,完全可以通過傳參判斷的方式進行數據回傳,但是,在我們實現一些可預見的功能需求時,一定要給自己的開發預留後路,也就是我們常說的可拓展性,基於此,我們會分開實現各自的接口,以便於後期的擴展。
接着來分析在列表頁中我們需要展示的元素,首先因為需要分上述兩種情況,因此我們需要在我們API設計的時候分別處理,針對於
1.分類的商品列表展示,需要傳入的參數有:

  • 分類id
  • 排序(在電商列表我們常見的幾種排序(銷量,價格等等))
  • 分頁相關(因為我們不可能把數據庫中所有的商品都取出來)
    • PageNumber(當前第幾頁)
    • PageSize(每頁显示多少條數據)

2.關鍵詞查詢商品列表,需要傳入的參數有:

  • 關鍵詞
  • 排序(在電商列表我們常見的幾種排序(銷量,價格等等))
  • 分頁相關(因為我們不可能把數據庫中所有的商品都取出來)
    • PageNumber(當前第幾頁)
    • PageSize(每頁显示多少條數據)

需要在頁面展示的信息有:

  • 商品id(用於跳轉商品詳情使用)
  • 商品名稱
  • 商品價格
  • 商品銷量
  • 商品圖片
  • 商品優惠
  • …

編碼實現

根據上面我們的分析,接下來開始我們的編碼:

根據商品分類查詢

根據我們的分析,肯定不會在一張表中把所有數據獲取全,因此我們需要進行多表聯查,故我們需要在自定義mapper中實現我們的功能查詢.

ResponseDTO 實現

根據我們前面分析的前端需要展示的信息,我們來定義一個用於展示這些信息的對象com.liferunner.dto.SearchProductDTO,代碼如下:

@Data
@NoArgsConstructor
@AllArgsConstructor
@Builder
public class SearchProductDTO {
    private String productId;
    private String productName;
    private Integer sellCounts;
    private String imgUrl;
    private Integer priceDiscount;
    //商品優惠,我們直接計算之後返回優惠后價格
}

Custom Mapper 實現

在com.liferunner.custom.ProductCustomMapper.java中新增一個方法接口:

    List<SearchProductDTO> searchProductListByCategoryId(@Param("paramMap") Map<String, Object> paramMap);

同時,在mapper/custom/ProductCustomMapper.xml中實現我們的查詢方法:

<select id="searchProductListByCategoryId" resultType="com.liferunner.dto.SearchProductDTO" parameterType="Map">
        SELECT
        p.id as productId,
        p.product_name as productName,
        p.sell_counts as sellCounts,
        pi.url as imgUrl,
        tp.priceDiscount
        FROM products p
        LEFT JOIN products_img pi
        ON p.id = pi.product_id
        LEFT JOIN
        (
        SELECT product_id, MIN(price_discount) as priceDiscount
        FROM products_spec
        GROUP BY product_id
        ) tp
        ON tp.product_id = p.id
        WHERE pi.is_main = 1
        AND p.category_id = #{paramMap.categoryId}
        ORDER BY
        <choose>
            <when test="paramMap.sortby != null and paramMap.sortby == 'sell'">
                p.sell_counts DESC
            </when>
            <when test="paramMap.sortby != null and paramMap.sortby == 'price'">
                tp.priceDiscount ASC
            </when>
            <otherwise>
                p.created_time DESC
            </otherwise>
        </choose>
    </select>

主要來說明一下這裏的<choose>模塊,以及為什麼不使用if標籤。
在有的時候,我們並不希望所有的條件都同時生效,而只是想從多個選項中選擇一個,但是在使用IF標籤時,只要test中的表達式為 true,就會執行IF 標籤中的條件。MyBatis 提供了 choose 元素。IF標籤是與(and)的關係,而 choose 是或(or)的關係。
它的選擇是按照順序自上而下,一旦有任何一個滿足條件,則選擇退出。

Service 實現

然後在servicecom.liferunner.service.IProductService中添加方法接口:

    /**
     * 根據商品分類查詢商品列表
     *
     * @param categoryId 分類id
     * @param sortby     排序方式
     * @param pageNumber 當前頁碼
     * @param pageSize   每頁展示多少條數據
     * @return 通用分頁結果視圖
     */
    CommonPagedResult searchProductList(Integer categoryId, String sortby, Integer pageNumber, Integer pageSize);

在實現類com.liferunner.service.impl.ProductServiceImpl中,實現上述方法:

    // 方法重載
    @Override
    public CommonPagedResult searchProductList(Integer categoryId, String sortby, Integer pageNumber, Integer pageSize) {
        Map<String, Object> paramMap = new HashMap<>();
        paramMap.put("categoryId", categoryId);
        paramMap.put("sortby", sortby);
        // mybatis-pagehelper
        PageHelper.startPage(pageNumber, pageSize);
        val searchProductDTOS = this.productCustomMapper.searchProductListByCategoryId(paramMap);
        // 獲取mybatis插件中獲取到信息
        PageInfo<?> pageInfo = new PageInfo<>(searchProductDTOS);
        // 封裝為返回到前端分頁組件可識別的視圖
        val commonPagedResult = CommonPagedResult.builder()
                .pageNumber(pageNumber)
                .rows(searchProductDTOS)
                .totalPage(pageInfo.getPages())
                .records(pageInfo.getTotal())
                .build();
        return commonPagedResult;
    }

在這裏,我們使用到了一個mybatis-pagehelper插件,會在下面的福利講解中分解。

Controller 實現

繼續在com.liferunner.api.controller.ProductController中添加對外暴露的接口API:

@GetMapping("/searchByCategoryId")
    @ApiOperation(value = "查詢商品信息列表", notes = "根據商品分類查詢商品列表")
    public JsonResponse searchProductListByCategoryId(
        @ApiParam(name = "categoryId", value = "商品分類id", required = true, example = "0")
        @RequestParam Integer categoryId,
        @ApiParam(name = "sortby", value = "排序方式", required = false)
        @RequestParam String sortby,
        @ApiParam(name = "pageNumber", value = "當前頁碼", required = false, example = "1")
        @RequestParam Integer pageNumber,
        @ApiParam(name = "pageSize", value = "每頁展示記錄數", required = false, example = "10")
        @RequestParam Integer pageSize
    ) {
        if (null == categoryId || categoryId == 0) {
            return JsonResponse.errorMsg("分類id錯誤!");
        }
        if (null == pageNumber || 0 == pageNumber) {
            pageNumber = DEFAULT_PAGE_NUMBER;
        }
        if (null == pageSize || 0 == pageSize) {
            pageSize = DEFAULT_PAGE_SIZE;
        }
        log.info("============根據分類:{} 搜索列表==============", categoryId);

        val searchResult = this.productService.searchProductList(categoryId, sortby, pageNumber, pageSize);
        return JsonResponse.ok(searchResult);
    }

因為我們的請求中,只會要求商品分類id是必填項,其餘的調用方都可以不提供,但是如果不提供的話,我們系統就需要給定一些默認的參數來保證我們的系統正常穩定的運行,因此,我定義了com.liferunner.api.controller.BaseController,用於存儲一些公共的配置信息。

/**
 * BaseController for : controller 基類
 */
@Controller
public class BaseController {
    /**
     * 默認展示第1頁
     */
    public final Integer DEFAULT_PAGE_NUMBER = 1;
    /**
     * 默認每頁展示10條數據
     */
    public final Integer DEFAULT_PAGE_SIZE = 10;
}

Test API

測試的參數分別是:categoryId : 51 ,sortby : price,pageNumber : 1,pageSize : 5

可以看到,我們查詢到7條數據,總頁數totalPage為2,並且根據價格從小到大進行了排序,證明我們的編碼是正確的。接下來,通過相同的代碼邏輯,我們繼續實現根據搜索關鍵詞進行查詢。

根據關鍵詞查詢

Response DTO 實現

使用上面實現的com.liferunner.dto.SearchProductDTO.

Custom Mapper 實現

在com.liferunner.custom.ProductCustomMapper中新增方法:

List<SearchProductDTO> searchProductList(@Param("paramMap") Map<String, Object> paramMap);

在mapper/custom/ProductCustomMapper.xml中添加查詢SQL:

<select id="searchProductList" resultType="com.liferunner.dto.SearchProductDTO" parameterType="Map">
        SELECT
        p.id as productId,
        p.product_name as productName,
        p.sell_counts as sellCounts,
        pi.url as imgUrl,
        tp.priceDiscount
        FROM products p
        LEFT JOIN products_img pi
        ON p.id = pi.product_id
        LEFT JOIN
        (
        SELECT product_id, MIN(price_discount) as priceDiscount
        FROM products_spec
        GROUP BY product_id
        ) tp
        ON tp.product_id = p.id
        WHERE pi.is_main = 1
        <if test="paramMap.keyword != null and paramMap.keyword != ''">
            AND p.item_name LIKE "%${paramMap.keyword}%"
        </if>
        ORDER BY
        <choose>
            <when test="paramMap.sortby != null and paramMap.sortby == 'sell'">
                p.sell_counts DESC
            </when>
            <when test="paramMap.sortby != null and paramMap.sortby == 'price'">
                tp.priceDiscount ASC
            </when>
            <otherwise>
                p.created_time DESC
            </otherwise>
        </choose>
    </select>

Service 實現

在com.liferunner.service.IProductService中新增查詢接口:

    /**
     * 查詢商品列表
     *
     * @param keyword    查詢關鍵詞
     * @param sortby     排序方式
     * @param pageNumber 當前頁碼
     * @param pageSize   每頁展示多少條數據
     * @return 通用分頁結果視圖
     */
    CommonPagedResult searchProductList(String keyword, String sortby, Integer pageNumber, Integer pageSize);

在com.liferunner.service.impl.ProductServiceImpl實現上述接口方法:

    @Override
    public CommonPagedResult searchProductList(String keyword, String sortby, Integer pageNumber, Integer pageSize) {
        Map<String, Object> paramMap = new HashMap<>();
        paramMap.put("keyword", keyword);
        paramMap.put("sortby", sortby);
        // mybatis-pagehelper
        PageHelper.startPage(pageNumber, pageSize);
        val searchProductDTOS = this.productCustomMapper.searchProductList(paramMap);
        // 獲取mybatis插件中獲取到信息
        PageInfo<?> pageInfo = new PageInfo<>(searchProductDTOS);
        // 封裝為返回到前端分頁組件可識別的視圖
        val commonPagedResult = CommonPagedResult.builder()
                .pageNumber(pageNumber)
                .rows(searchProductDTOS)
                .totalPage(pageInfo.getPages())
                .records(pageInfo.getTotal())
                .build();
        return commonPagedResult;
    }

上述方法和之前searchProductList(Integer categoryId, String sortby, Integer pageNumber, Integer pageSize)唯一的區別就是它是肯定搜索關鍵詞來進行數據查詢,使用重載的目的是為了我們後續不同類型的業務擴展而考慮的。

Controller 實現

在com.liferunner.api.controller.ProductController中添加關鍵詞搜索API:

    @GetMapping("/search")
    @ApiOperation(value = "查詢商品信息列表", notes = "查詢商品信息列表")
    public JsonResponse searchProductList(
        @ApiParam(name = "keyword", value = "搜索關鍵詞", required = true)
        @RequestParam String keyword,
        @ApiParam(name = "sortby", value = "排序方式", required = false)
        @RequestParam String sortby,
        @ApiParam(name = "pageNumber", value = "當前頁碼", required = false, example = "1")
        @RequestParam Integer pageNumber,
        @ApiParam(name = "pageSize", value = "每頁展示記錄數", required = false, example = "10")
        @RequestParam Integer pageSize
    ) {
        if (StringUtils.isBlank(keyword)) {
            return JsonResponse.errorMsg("搜索關鍵詞不能為空!");
        }
        if (null == pageNumber || 0 == pageNumber) {
            pageNumber = DEFAULT_PAGE_NUMBER;
        }
        if (null == pageSize || 0 == pageSize) {
            pageSize = DEFAULT_PAGE_SIZE;
        }
        log.info("============根據關鍵詞:{} 搜索列表==============", keyword);

        val searchResult = this.productService.searchProductList(keyword, sortby, pageNumber, pageSize);
        return JsonResponse.ok(searchResult);
    }

Test API

測試參數:keyword : 西鳳,sortby : sell,pageNumber : 1,pageSize : 10

根據銷量排序正常,查詢關鍵詞正常,總條數32,每頁10條,總共3頁正常。

福利講解

在本節編碼實現中,我們使用到了一個通用的mybatis分頁插件mybatis-pagehelper,接下來,我們來了解一下這個插件的基本情況。

mybatis-pagehelper

如果各位小夥伴使用過:, 那麼對於這個就很容易理解了,它其實就是基於來實現的,當攔截到原始SQL之後,對SQL進行一次改造處理。
我們來看看我們自己代碼中的實現,根據springboot編碼三部曲:

1.添加依賴

        <!-- 引入mybatis-pagehelper 插件-->
        <dependency>
            <groupId>com.github.pagehelper</groupId>
            <artifactId>pagehelper-spring-boot-starter</artifactId>
            <version>1.2.12</version>
        </dependency>

有同學就要問了,為什麼引入的這個依賴和我原來使用的不同?以前使用的是:

<dependency>
    <groupId>com.github.pagehelper</groupId>
    <artifactId>pagehelper</artifactId>
    <version>5.1.10</version>
</dependency>

答案就在這裏:

我們使用的是springboot進行的項目開發,既然使用的是springboot,那我們完全可以用到它的自動裝配特性,作者幫我們實現了這麼一個,我們只需要參考示例來編寫就ok了。

2.改配置

# mybatis 分頁組件配置
pagehelper:
  helperDialect: mysql #插件支持12種數據庫,選擇類型
  supportMethodsArguments: true

3.改代碼

如下示例代碼:

    @Override
    public CommonPagedResult searchProductList(String keyword, String sortby, Integer pageNumber, Integer pageSize) {
        Map<String, Object> paramMap = new HashMap<>();
        paramMap.put("keyword", keyword);
        paramMap.put("sortby", sortby);
        // mybatis-pagehelper
        PageHelper.startPage(pageNumber, pageSize);
        val searchProductDTOS = this.productCustomMapper.searchProductList(paramMap);
        // 獲取mybatis插件中獲取到信息
        PageInfo<?> pageInfo = new PageInfo<>(searchProductDTOS);
        // 封裝為返回到前端分頁組件可識別的視圖
        val commonPagedResult = CommonPagedResult.builder()
                .pageNumber(pageNumber)
                .rows(searchProductDTOS)
                .totalPage(pageInfo.getPages())
                .records(pageInfo.getTotal())
                .build();
        return commonPagedResult;
    }

在我們查詢數據庫之前,我們引入了一句PageHelper.startPage(pageNumber, pageSize);,告訴mybatis我們要對查詢進行分頁處理,這個時候插件會啟動一個攔截器com.github.pagehelper.PageInterceptor,針對所有的query進行攔截,添加自定義參數和添加查詢數據總數。(後續我們會打印sql來證明。)

當查詢到結果之後,我們需要將我們查詢到的結果通知給插件,也就是PageInfo<?> pageInfo = new PageInfo<>(searchProductDTOS);(com.github.pagehelper.PageInfo是對插件針對分頁做的一個屬性包裝,具體可以查看)。

至此,我們的插件使用就已經結束了。但是為什麼我們在後面又封裝了一個對象來對外進行返回,而不是使用查詢到的PageInfo呢?這是因為我們實際開發過程中,為了數據結構的一致性做的一次結構封裝,你也可不實現該步驟,都是對結果沒有任何影響的。

SQL打印對比

2019-11-21 12:04:21 INFO  ProductController:134 - ============根據關鍵詞:西鳳 搜索列表==============
Creating a new SqlSession
SqlSession [org.apache.ibatis.session.defaults.DefaultSqlSession@4ff449ba] was not registered for synchronization because synchronization is not active
JDBC Connection [HikariProxyConnection@1980420239 wrapping com.mysql.cj.jdbc.ConnectionImpl@563b22b1] will not be managed by Spring
==>  Preparing: SELECT count(0) FROM products p LEFT JOIN products_img pi ON p.id = pi.product_id LEFT JOIN (SELECT product_id, MIN(price_discount) AS priceDiscount FROM products_spec GROUP BY product_id) tp ON tp.product_id = p.id WHERE pi.is_main = 1 AND p.product_name LIKE "%西鳳%" 
==> Parameters: 
<==    Columns: count(0)
<==        Row: 32
<==      Total: 1
==>  Preparing: SELECT p.id as productId, p.product_name as productName, p.sell_counts as sellCounts, pi.url as imgUrl, tp.priceDiscount FROM product p LEFT JOIN products_img pi ON p.id = pi.product_id LEFT JOIN ( SELECT product_id, MIN(price_discount) as priceDiscount FROM products_spec GROUP BY product_id ) tp ON tp.product_id = p.id WHERE pi.is_main = 1 AND p.product_name LIKE "%西鳳%" ORDER BY p.sell_counts DESC LIMIT ? 
==> Parameters: 10(Integer)

我們可以看到,我們的SQL中多了一個SELECT count(0),第二條SQL多了一個LIMIT參數,在代碼中,我們很明確的知道,我們並沒有显示的去搜索總數和查詢條數,可以確定它就是插件幫我們實現的。

源碼下載

下節預告

下一節我們將繼續開發商品詳情展示以及商品評價業務,在過程中使用到的任何開發組件,我都會通過專門的一節來進行介紹的,兄弟們末慌!

gogogo!

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

面向對象和面向過程詳解

1.前言

其實一直對面向過程和面向對象的概念和區別沒有很深入的理解,在自己不斷想完善自己的知識體系中,今天借這個時間,寫一篇博客。來深入的了解面向過程與面向對象!好記性不如爛筆頭!!  

2.面向對象與面向過程的區別

面向過程就是分析出解決問題所需要的步驟,然後用函數把這些步驟一步一步實現,使用的時候一個一個依次調用就可以了;面向對象是把構成問題事務分解成各個對象,建立對象的目的不是為了完成一個步驟,而是為了描敘某個事物在整個解決問題的步驟中的行為。

舉一個下五子棋通俗例子吧 哈哈哈 我感覺這兒例子很容易讓人理解

面向過程的設計思路就是首先分析問題的步驟:

1、開始遊戲,

2、黑子先走,

3、繪製畫面,

4、判斷輸贏,

5、輪到白子,

6、繪製畫面,

7、判斷輸贏,

8、返回步驟2,

9、輸出最後結果。

把上面每個步驟用分別的函數來實現,問題就解決了。

而面向對象的設計則是從另外的思路來解決問題。整個五子棋可以分為

1、黑白雙方,這兩方的行為是一模一樣的,

2、棋盤系統,負責繪製畫面,

3、規則系統,負責判定諸如犯規、輸贏等。第一類對象(玩家對象)負責接受用戶輸入,並告知第二類對象(棋盤對象)棋子布局的變化,

棋盤對象接收到了棋子的i變化就要負責在屏幕上面显示出這種變化,同時利用第三類對象(規則系統)來對棋局進行判定。

可以明顯地看出,面向對象是以功能來劃分問題,而不是步驟。同樣是繪製棋局,這樣的行為在面向過程的設計中分散在了總多步驟中,很可能出現不同的繪製版本,因為通常設計人員會考慮到實際情況進行各種各樣的簡化。而面向對象的設計中,繪圖只可能在棋盤對象中出現,從而保證了繪圖的統一。

功能上的統一保證了面向對象設計的可擴展性。比如要加入悔棋的功能,如果要改動面向過程的設計,那麼從輸入到判斷到显示這一連串的步驟都要改動,甚至步驟之間的循序都要進行大規模調整。如果是面向對象的話,只用改動棋盤對象就行了,棋盤系統保存了黑白雙方的棋譜,簡單回溯就可以了,而显示和規則判斷則不用顧及,同時整個對對象功能的調用順序都沒有變化,改動只是局部的。

再比如我要把這個五子棋遊戲改為圍棋遊戲,如果你是面向過程設計,那麼五子棋的規則就分佈在了你的程序的每一個角落,要改動還不如重寫。但是如果你當初就是面向對象的設計,那麼你只用改動規則對象就可以了,五子棋和圍棋的區別不就是規則嗎?(當然棋盤大小好像也不一樣,但是你會覺得這是一個難題嗎?直接在棋盤對象中進行一番小改動就可以了。)而下棋的大致步驟從面向對象的角度來看沒有任何變化。

當然,要達到改動只是局部的需要設計的人有足夠的經驗,使用對象不能保證你的程序就是面向對象,初學者或者很蹩腳的程序員很可能以面向對象之虛而行面向過程之實,這樣設計出來的所謂面向對象的程序很難有良好的可移植性和可擴展性

三、面向過程與面向對象的優缺點
很多資料上全都是一群很難理解的理論知識,整的我頭都大了,後來發現了一個比較好的文章,寫的真是太棒了,通俗易懂,想要不明白都難!

用面向過程的方法寫出來的程序是一份蛋炒飯,而用面向對象寫出來的程序是一份蓋澆飯。所謂蓋澆飯,北京叫蓋飯,東北叫燴飯,廣東叫碟頭飯,就是在一碗白米飯上面澆上一份蓋菜,你喜歡什麼菜,你就澆上什麼菜。我覺得這個比喻還是比較貼切的。

蛋炒飯製作是把米飯和雞蛋混在一起炒勻。蓋澆飯呢,則是把米飯和蓋菜分別做好,你如果要一份紅燒肉蓋飯呢,就給你澆一份紅燒肉;如果要一份青椒土豆蓋澆飯,就給澆一份青椒土豆絲。

蛋炒飯的好處就是入味均勻,吃起來香。如果恰巧你不愛吃雞蛋,只愛吃青菜的話,那麼唯一的辦法就是全部倒掉,重新做一份青菜炒飯了。蓋澆飯就沒這麼多麻煩,你只需要把上面的蓋菜撥掉,更換一份蓋菜就可以了。蓋澆飯的缺點是入味不均,可能沒有蛋炒飯那麼香。

到底是蛋炒飯好還是蓋澆飯好呢?其實這類問題都很難回答,非要比個上下高低的話,就必須設定一個場景,否則只能說是各有所長。如果大家都不是美食家,沒那麼多講究,那麼從飯館角度來講的話,做蓋澆飯顯然比蛋炒飯更有優勢,他可以組合出來任意多的組合,而且不會浪費。

蓋澆飯的好處就是”菜”“飯”分離,從而提高了製作蓋澆飯的靈活性。飯不滿意就換飯,菜不滿意換菜。用軟件工程的專業術語就是”可維護性“比較好,”飯” 和”菜”的耦合度比較低。蛋炒飯將”蛋”“飯”攪和在一起,想換”蛋”“飯”中任何一種都很困難,耦合度很高,以至於”可維護性”比較差。軟件工程追求的目標之一就是可維護性,可維護性主要表現在3個方面:可理解性、可測試性和可修改性。面向對象的好處之一就是顯著的改善了軟件系統的可維護性。
看了這篇文章,簡單的總結一下!

面向過程

優點:性能比面向對象高,因為類調用時需要實例化,開銷比較大,比較消耗資源;比如嵌入式開發、 Linux/Unix等一般採用面向過程開發,性能是最重要的因素。
缺點:沒有面向對象易維護、易復用、易擴展
面向對象

優點:易維護、易復用、易擴展,由於面向對象有封裝、繼承、多態性的特性,可以設計出低耦合的系統,使系統 更加靈活、更加易於維護

缺點:性能比面向過程低

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

NetCore3.0 文件上傳與大文件上傳的限制

NetCore文件上傳兩種方式

  NetCore官方給出的兩種文件上傳方式分別為“緩衝”、“流式”。我簡單的說說兩種的區別,

  1.緩衝:通過模型綁定先把整個文件保存到內存,然後我們通過IFormFile得到stream,優點是效率高,缺點對內存要求大。文件不宜過大。

  2.流式處理:直接讀取請求體裝載后的Section 對應的stream 直接操作strem即可。無需把整個請求體讀入內存,

以下為官方微軟說法

緩衝

  整個文件讀入 IFormFile,它是文件的 C# 表示形式,用於處理或保存文件。 文件上傳所用的資源(磁盤、內存)取決於併發文件上傳的數量和大小。 如果應用嘗試緩衝過多上傳,站點就會在內存或磁盤空間不足時崩潰。 如果文件上傳的大小或頻率會消耗應用資源,請使用流式傳輸。

流式處理   

  從多部分請求收到文件,然後應用直接處理或保存它。 流式傳輸無法顯著提高性能。 流式傳輸可降低上傳文件時對內存或磁盤空間的需求。

文件大小限制

  說起大小限制,我們得從兩方面入手,1應用服務器Kestrel 2.應用程序(我們的netcore程序),

1.應用服務器Kestre設置

  應用服務器Kestrel對我們的限制主要是對整個請求體大小的限制通過如下配置可以進行設置(Program -> CreateHostBuilder),超出設置範圍會報 BadHttpRequestException: Request body too large 異常信息

public static IHostBuilder CreateHostBuilder(string[] args) =>
           Host.CreateDefaultBuilder(args)
               .ConfigureWebHostDefaults(webBuilder =>
               {
                   webBuilder.ConfigureKestrel((context, options) =>
                   {
                       //設置應用服務器Kestrel請求體最大為50MB
                       options.Limits.MaxRequestBodySize = 52428800;
                   });
                   webBuilder.UseStartup<Startup>();
});

2.應用程序設置

  應用程序設置 (Startup->  ConfigureServices) 超出設置範圍會報InvalidDataException 異常信息

services.Configure<FormOptions>(options =>
 {
             options.MultipartBodyLengthLimit = long.MaxValue;
 });

通過設置即重置文件上傳的大小限制。

源碼分析

  這裏我主要說一下 MultipartBodyLengthLimit  這個參數他主要限制我們使用“緩衝”形式上傳文件時每個的長度。為什麼說是緩衝形式中,是因為我們緩衝形式在讀取上傳文件用的幫助類為 MultipartReaderStream 類下的 Read 方法,此方法在每讀取一次後會更新下讀入的總byte數量,當超過此數量時會拋出  throw new InvalidDataException($“Multipart body length limit {LengthLimit.GetValueOrDefault()} exceeded.“);  主要體現在 UpdatePosition 方法對 _observedLength  的判斷

以下為 MultipartReaderStream 類兩個方法的源代碼,為方便閱讀,我已精簡掉部分代碼

Read

public override int Read(byte[] buffer, int offset, int count)
 {
          
          var bufferedData = _innerStream.BufferedData;
      int read;
      read = _innerStream.Read(buffer, offset, Math.Min(count, bufferedData.Count));
          return UpdatePosition(read);
}

UpdatePosition

private int UpdatePosition(int read)
        {
            _position += read;
            if (_observedLength < _position)
            {
                _observedLength = _position;
                if (LengthLimit.HasValue && _observedLength > LengthLimit.GetValueOrDefault())
                {
                    throw new InvalidDataException($"Multipart body length limit {LengthLimit.GetValueOrDefault()} exceeded.");
                }
            }
            return read;
}

通過代碼我們可以看到 當你做了 MultipartBodyLengthLimit 的限制后,在每次讀取後會累計讀取的總量,當讀取總量超出

 MultipartBodyLengthLimit  設定值會拋出 InvalidDataException 異常,

最終我的文件上傳Controller如下

  需要注意的是我們創建 MultipartReader 時並未設置 BodyLengthLimit  (這參數會傳給 MultipartReaderStream.LengthLimit )也就是我們最終的限制,這裏我未設置值也就無限制,可以通過 UpdatePosition 方法體現出來

using Microsoft.AspNetCore.Http;
using Microsoft.AspNetCore.Mvc;
using Microsoft.AspNetCore.WebUtilities;
using Microsoft.Net.Http.Headers;
using System.IO;
using System.Threading.Tasks;
 
namespace BigFilesUpload.Controllers
{
    [Route("api/[controller]")]
    public class FileController : Controller
    {
        private readonly string _targetFilePath = "C:\\files\\TempDir";
 
        /// <summary>
        /// 流式文件上傳
        /// </summary>
        /// <returns></returns>
        [HttpPost("UploadingStream")]
        public async Task<IActionResult> UploadingStream()
        {
 
            //獲取boundary
            var boundary = HeaderUtilities.RemoveQuotes(MediaTypeHeaderValue.Parse(Request.ContentType).Boundary).Value;
            //得到reader
            var reader = new MultipartReader(boundary, HttpContext.Request.Body);
            //{ BodyLengthLimit = 2000 };//
            var section = await reader.ReadNextSectionAsync();
 
            //讀取section
            while (section != null)
            {
                var hasContentDispositionHeader = ContentDispositionHeaderValue.TryParse(section.ContentDisposition, out var contentDisposition);
                if (hasContentDispositionHeader)
                {
                    var trustedFileNameForFileStorage = Path.GetRandomFileName();
                    await WriteFileAsync(section.Body, Path.Combine(_targetFilePath, trustedFileNameForFileStorage));
                }
                section = await reader.ReadNextSectionAsync();
            }
            return Created(nameof(FileController), null);
        }
 
        /// <summary>
        /// 緩存式文件上傳
        /// </summary>
        /// <param name=""></param>
        /// <returns></returns>
        [HttpPost("UploadingFormFile")]
        public async Task<IActionResult> UploadingFormFile(IFormFile file)
        {
            using (var stream = file.OpenReadStream())
            {
                var trustedFileNameForFileStorage = Path.GetRandomFileName();
                await WriteFileAsync(stream, Path.Combine(_targetFilePath, trustedFileNameForFileStorage));
            }
            return Created(nameof(FileController), null);
        }
 
 
        /// <summary>
        /// 寫文件導到磁盤
        /// </summary>
        /// <param name="stream">流</param>
        /// <param name="path">文件保存路徑</param>
        /// <returns></returns>
        public static async Task<int> WriteFileAsync(System.IO.Stream stream, string path)
        {
            const int FILE_WRITE_SIZE = 84975;//寫出緩衝區大小
            int writeCount = 0;
            using (FileStream fileStream = new FileStream(path, FileMode.Create, FileAccess.Write, FileShare.Write, FILE_WRITE_SIZE, true))
            {
                byte[] byteArr = new byte[FILE_WRITE_SIZE];
                int readCount = 0;
                while ((readCount = await stream.ReadAsync(byteArr, 0, byteArr.Length)) > 0)
                {
                    await fileStream.WriteAsync(byteArr, 0, readCount);
                    writeCount += readCount;
                }
            }
            return writeCount;
        }
 
    }
}


 總結:

如果你部署 在iis上或者Nginx 等其他應用服務器 也是需要注意的事情,因為他們本身也有對請求體的限制,還有值得注意的就是我們在創建文件流對象時 緩衝區的大小盡量不要超過netcore大對象的限制。這樣在併發高的時候很容易觸發二代GC的回收.

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

傳蘋果電動汽車將採用韓國公司的電池技術

根據行業消息,蘋果近期與一家韓國電池開發商簽署了保密協議,聯合為代號為“泰坦”的汽車專案開發電池。從今年初開始,他們一直在韓國做行政工作。一名蘋果員工一直在這家韓國公司進行參觀活動,他屬於與蘋果電動汽車電池開發相關的部門。  
  業界認為,這家韓國公司並不是唯一一家負責蘋果電池開發的公司。不過,有消息稱,儘管蘋果從一開始就從完全不同的設計、功能以及性能角度來開發電池,但是他們仍舊一直在挖掘創新技術。業界相信,蘋果專注于開發出只能存在於蘋果自動駕駛汽車的創新電池技術。   這家韓國電池開發商由大約20名電池專家組成,持有空芯電池的國際專利技術。這些電池是圓柱形鋰離子二次電池,有兩根手指那麼厚,不同於其它空芯電池。蘋果並未選擇當前電動汽車普遍使用的標準圓形或矩形電池,但計畫根據韓國公司的空芯電池技術為其電動汽車開發自主電池。   文章來源:鳳凰科技

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

續航力600公里的特斯拉 即將問世?

續航力是電動車最受關注的性能,而作為全球電動車龍頭廠商的特斯拉(Tesla),似乎也準備好要推出續航力更久的車款了。跟據了解,新的特斯拉電動車可能搭載100kW的電池,續航力最遠可達611公里。

《癮科技》中文版指出,德國監管機關的資料中可查到Model S與Model X的100D與P100D型號的相關資訊;而根據特斯拉為車款型號命名的邏輯,這可能暗示特斯拉將推出搭載100kW電池的車款。

100kW 的電池搭配Model S,預計最高續航里程可來到611公里,比90D的續航里程多了100公里以上。若搭配Model X,續航里程也可來到480 公里之多。這樣的續航力,將能有效減輕美國車主對駕駛特斯拉跨州旅行的疑慮。

(照片來源:Tesla 臉書專頁)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

從零開始搭建前後端分離的NetCore2.2(EF Core CodeFirst+Autofac)+Vue的項目框架之十一Swagger使用一

 一.未使用Swagger狀況

  相信無論是前端開發人員還是後端開發人員,都或多或少都被接口文檔折磨過,前端經常抱怨後端給的接口文檔或與實際情況不一致。後端又覺得編寫及維護接口文檔會耗費不少精力,經常來不及更新。 其實無論是前端調用後端,還是後端調用後端,都期望有一個好的接口文檔。但是這個接口文檔對於程序員來說,就跟註釋一樣,經常會抱怨別人寫的代碼沒有寫註釋,然而自己寫起代碼起來,最討厭的,也是寫註釋。 所以僅僅只通過強制來規範大家是不夠的,隨着時間推移,版本迭代,接口文檔往往很容易就跟不上代碼了

 二.使用Swagger狀況

  Swagger 提供了一個可視化的UI頁面展示描述文件,其中包括接口的調用,接口所需參數(header,body,url.params),接口說明,參數說明等。接口的調用方、測試、項目經理等都可以在該頁面中對相關接口進行查閱和做一些簡單的接口請求。只要在項目框架搭建時,對Swagger 進行了配置,後面持續迭代的時候,只會花很小代價去維護代碼、接口文檔以及Swagger描述文件。因為一旦接口發生改變,程序重新部署,接口文檔會重新生成對應新的文檔。

 三.如何使用?

  在NetCore項目中怎麼去使用Swagger來生成接口文檔呢?

  首先在 webApi 啟動項目 上 右鍵 點擊管理Nuget程序包, 安裝  Swashbuckle.AspNetCore ,然後到  Startup 中添加引用  using Swashbuckle.AspNetCore.Swagger; 

  在ConfigureServices方法中添加以下代碼

            #region Swagger

            services.AddSwaggerGen(options =>
            {
                options.SwaggerDoc("v1", new Info
                {
                    Version = "v1",
                    Title = "API Doc",
                    Description = "作者:Levy_w_Wang",
                    //服務條款
                    TermsOfService = "None",
                    //作者信息
                    Contact = new Contact
                    {
                        Name = "levy",
                        Email = "levy_w_wang@qq.com",
                        Url = "https://www.cnblogs.com/levywang"
                    },
                    //許可證
                    License = new License
                    {
                        Name = "tim",
                        Url = "https://www.cnblogs.com/levywang"
                    }
                });

                #region XmlComments

                var basePath1 = Path.GetDirectoryName(typeof(Program).Assembly.Location);//獲取應用程序所在目錄(絕對,不受工作目錄(平台)影響,建議採用此方法獲取路徑)
                //獲取目錄下的XML文件 显示註釋等信息
                var xmlComments = Directory.GetFiles(basePath1, "*.xml", SearchOption.AllDirectories).ToList();

                foreach (var xmlComment in xmlComments)
                {
                    options.IncludeXmlComments(xmlComment);
                }
                #endregion

                options.DocInclusionPredicate((docName, description) => true);

                options.IgnoreObsoleteProperties();//忽略 有Obsolete 屬性的方法
                options.IgnoreObsoleteActions();
                options.DescribeAllEnumsAsStrings();
            });
            #endregion

上面寫的循環是因為項目中可能有多個控制器類庫,為的是排除這種情況

接下來,再到 Configure 方法中添加:

            #region Swagger

            app.UseSwagger(c => { c.RouteTemplate = "apidoc/{documentName}/swagger.json"; });
            app.UseSwaggerUI(c =>
            {
                c.RoutePrefix = "apidoc";
                c.SwaggerEndpoint("v1/swagger.json", "ContentCenter API V1");
                c.DocExpansion(DocExpansion.Full);//默認文檔展開方式
            });

            #endregion

這裏使用了 RoutePrefix  屬性,為的是改變原始打開接口文檔目錄,原始路徑為 swagger/index.html ,現在為 /apidoc/index.html 

這個時候在需要輸出註釋的控制器類庫的屬性 中設置如下信息,並添加上相關註釋

然後運行起來,打開本地地址加上  /apidoc/index.html  就可以看到效果,

特別提醒:如果打開下面這個界面能正常显示,但是提示  Fetch errorInternal Server Error v1/swagger.json  錯誤,說明有方法未指明請求方式,如 HttpGet HttpPost HttpPut 等,找到並指明,重新運行就正常了


  點擊方法右上角的 Try it out ,試下調用接口,然後點擊Exectue,執行查看結果,能得到後端方法返回結果就說明成功。

特別說明:有接口不需要展示出去的時候,可以在方法上添加屬性 Obsolete ,這樣就不會显示出來。 前提:有前面ConfigureServices中 後面的 忽略 有Obsolete 屬性的方法 設置才行!!!


 最後可以看到接口返回數據正常,並且也能看到接口響應請求嘛等等信息,一個接口應該返回的信息也都有显示。


總結:

本文從為開發人員手寫api文檔的痛楚,從而引申出Swagger根據代碼自動生成出文檔和註釋,

並且還可以將不需要的方法不显示等設置。然後進行了簡單的測試使用 。

但是!!一般後端方法都有token等驗證,需要在header中添加token、sid等字段來驗證用戶,保障安全性,

該設置將在下一章節中寫!

 下一章

以上若有什麼不對或可以改進的地方,望各位指出或提出意見,一起探討學習~

有需要源碼的可通過此 鏈接拉取 覺得還可以的給個 start 和點個 下方的推薦哦~~謝謝!


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

paper sharing :學習特徵演化的數據流

特徵演化的數據流

    數據流學習是近年來機器學習與數據挖掘領域的一個熱門的研究方向,數據流的場景和靜態數據集的場景最大的一個特點就是數據會發生演化,關於演化數據流的研究大多集中於概念漂移檢測(有監督學習),概念/聚類演化分析(無監督學習),然而,人們往往忽略了一個經常出現的演化場景:特徵演化。大多數研究都考慮數據流的特徵空間是固定的,然而,在很多場景下這一假設並不成立:例如,當有限壽命傳感器收集的數據被新的傳感器替代時,這些傳感器對應的特徵將發生變化。

    今天要分享的文章出自周志華的實驗室《Learning with Feature Evolvable Streams》(NIPS 2017),它提出了一個新的場景,即在數據流中會有特徵消亡也會有新特徵出現。當出現新的特徵空間時,我們並不直接拋棄之前學到的模型並在新的數據上重新創建模型,而是嘗試恢復消失的特徵來提升模型的表現。具體來說,通過從恢復的特徵和新的特徵空間中分別學習兩個模型。為了從恢復的特徵中獲得提升,論文中提出了兩種集成策略:第一種方法是合併兩個模型的預測結果;第二種是選擇最佳的預測模型。下面我們具體來理解特徵演化數據流以及論文中提出的一些有趣的方法吧~

paper link:


什麼是特徵演化數據流?

    在很多現實的任務中,數據都是源源不斷收集的,關於數據流學習的研究近年來受到越來越多的關注,雖然已經有很多有效的算法針對特定的場景對數據流進行挖掘,但是它們都基於一個假設就是數據流中數據的特徵空間是穩定的。不幸的是,這一假設在很多場景下都不滿足。針對特徵演化的場景,最直接的想法就是利用新的特徵空間的數據學習一個新的模型,但是這一方法有很多問題:首先,當新的特徵剛出現的時候,只有很少的數據樣本來描述這些信息,訓練樣本並不足夠去學習一個新的模型;其次,包含消失特徵的舊模型被直接丟棄了,其中可能包含對當前數據有用的信息。論文中定義了一種特徵演化數據流的場景:一般情況下,特徵不會任意改變,而在一些重疊時期,新特徵和舊特徵都存在,如下圖所示:

    其中,T1階段,原始特徵集都是有效的,B1階段出現了新的特徵集,T2階段原始特徵集消失,只有新的特徵集。

    論文提出的方法是通過使用重疊(B1)階段來發現新舊特徵之間的關係,嘗試學習新特徵到舊特徵的一個映射,這樣就可以通過重構舊特徵並使用舊模型對新數據進行預測

問題描述

    論文中着重解決的是分類和回歸任務,在每一輪學習過程中,對每一個實例進行預測,結合它的真實標籤會得到一個loss(反映預測和真實標籤的差異),我們將上面提到的T1+B1+T的過程稱為一個周期,每個周期中只包含兩個特徵空間,所以,之後的研究主要關注一個周期內的模型的學習,而且,我們假設一個周期內的舊特徵會同時消失。定義Ω1和Ω2分別表示兩個特徵空間S1和S2上的線性模型,並定義映射,定義第i維特徵在第t輪的預測函數為線性模型,。損失函數是凸的,最直接的方式是使用在線梯度下降來求解w,但是在數據流上不適用。


方法介紹

    上文提到的基本算法的主要限制是在第1,…T1輪學習的模型在T1+1,…T1+T2時候被忽略了,這是因為T1之後數據的特徵空間改變了,我們無法直接應用原來的模型。為了解決這一問題,我們假設新舊特徵空間之間有一種特定的關係:,我們嘗試通過重疊階段B1來學習這種關係。學習兩組特徵之間的關係的方法很多,如多元回歸,數據流多標籤學習等。但是在當前的場景下,由於重疊階段特別短,學習一個複雜的關係模型是不現實的。所以我們採用線性映射來近似。定義線性映射的係數矩陣為M,那麼在B1階段,M的估計可以基於如下的目標方程:

M的最優解可以解得:

    然後,當我觀測到S2空間得數據,就可以通過M將其轉化到S1空間,並應用舊模型對其進行預測。

除了學習這個關係映射之外,我們得算法主要包括兩個部分:

  1. 在T1-B1+1,…T1階段,我們學習兩個特徵空間之間得關係;

  2. 在T1之後,我們使用新特徵空間的數據轉化后的原特徵空間數據,持續更新舊模型以提升它的預測效果,然後集成兩個模型進行預測。


預測結果集成

    論文中提出兩種集成方法,第一種是加權組合,即將兩個模型的預測結果求加權平均,權重是基於exponential of the cumulative loss。

其中

    這種權重的更新規則表明,如果上一輪模型的損失較大,下一輪模型的權值將以指數速度下降,這是合理的,可以得到很好的理論結果。

    第二種集成方法是動態選擇。

    上面提到的組合的方法結合了幾個模型來提升整體性能,通常來說,組合多個分類器的表現會比單分類器的效果要好,但是,這基於一個重要的假設就是每個基分類器的表現不能太差(如,在Adaboost中,基分類器的預測精度不應低於0.5)。然而在這個問題中,由於新特徵空間剛出現的時候訓練集較小,訓練的模型不好,因此可能並不適合用組合的方法來預測,相反,用動態選擇最優模型的方法反而能獲得好的效果。

有趣的靈魂在等你長按二維碼識別

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

【併發編程】Java中的原子操作

什麼是原子操作

原子操作是指一個或者多個不可再分割的操作。這些操作的執行順序不能被打亂,這些步驟也不可以被切割而只執行其中的一部分(不可中斷性)。舉個列子:

//就是一個原子操作
int i = 1;

//非原子操作,i++是一個多步操作,而且是可以被中斷的。
//i++可以被分割成3步,第一步讀取i的值,第二步計算i+1;第三部將最終值賦值給i
i++;

Java中的原子操作

在Java中,我們可以通過同步鎖或者CAS操作來實現原子操作。

CAS操作

CAS是Compare and swap的簡稱,這個操作是硬件級別的操作,在硬件層面保證了操作的原子性。CAS有3個操作數,內存值V,舊的預期值A,要修改的新值B。當且僅當預期值A和內存值V相同時,將內存值V修改為B,否則什麼都不做。Java中的sun.misc.Unsafe類提供了compareAndSwapInt和compareAndSwapLong等幾個方法實現CAS。

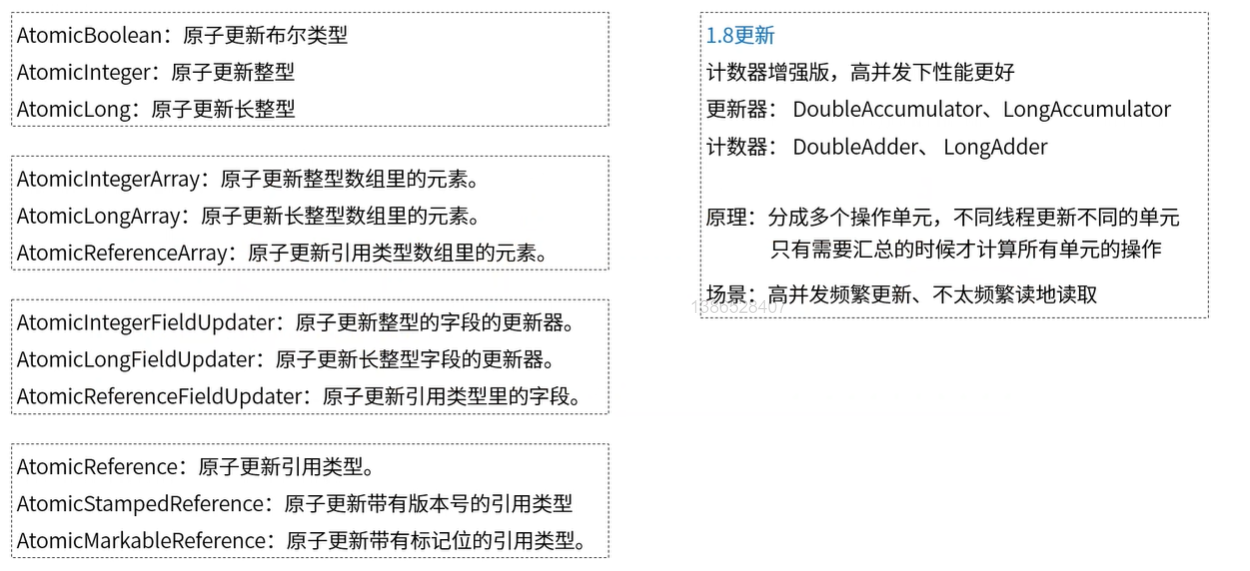
另外,在jdk的atomic包下面提供了很多基於CAS實現的原子操作類,見下圖:

下面我們就使用其中的AtomicInteger來看看怎麼使用這些原子操作類。

package com.csx.demo.spring.boot.concurrent.atomic;

import java.util.ArrayList;
import java.util.List;
import java.util.concurrent.atomic.AtomicInteger;

public class AtomicIntegerDemo {

    private static int THREAD_COUNT = 100;

    public static void main(String[] args) throws InterruptedException {


        NormalCounter normalCounter = new NormalCounter("normalCounter",0);
        SafeCounter safeCounter = new SafeCounter("safeCounter",0);
        List<Thread> threadList = new ArrayList<>();

        for (int i = 0; i < THREAD_COUNT ; i++) {
            Thread thread = new Thread(new Runnable() {
                @Override
                public void run() {
                    for (int j = 0; j < 10000; j++) {
                        normalCounter.add(1);
                        safeCounter.add(1);
                    }
                }
            });
            threadList.add(thread);
        }

        for (Thread thread : threadList) {
            thread.start();
        }
        for (Thread thread : threadList) {
            thread.join();
        }
        System.out.println("normalCounter:"+normalCounter.getCount());
        System.out.println("safeCounter:"+safeCounter.getCount());
    }


    public static class NormalCounter{
        private String name;
        private Integer count;

        public NormalCounter(String name, Integer count) {
            this.name = name;
            this.count = count;
        }

        public void add(int delta){
            this.count = count+delta;
        }

        public String getName() {
            return name;
        }

        public void setName(String name) {
            this.name = name;
        }

        public Integer getCount() {
            return count;
        }

        public void setCount(Integer count) {
            this.count = count;
        }
    }

    public static class SafeCounter{
        private String name;
        private AtomicInteger count;

        public SafeCounter(String name, Integer count) {
            this.name = name;
            this.count = new AtomicInteger(count);
        }

        public void add(int delta){
            count.addAndGet(delta);
        }

        public String getName() {
            return name;
        }

        public void setName(String name) {
            this.name = name;
        }

        public int getCount() {
            return count.get();
        }

        public void setCount(Integer count) {
            this.count.set(count);
        }
    }

}

上面的代碼中,我們分別創建了一個普通的計數器和一個原子操作的計數器(使用AtomicInteger進行計數)。然後創建了100個線程,每個線程進行10000次計數。理論上線程執行完之後,計數器的值都是1000000,但是結果如下:

normalCounter:496527
safeCounter:1000000

每次執行,普通計數器的值都是不一樣的,而使用AtomicInteger進行計數的計數器都是1000000。

CAS操作存在的問題

  • ABA問題:因為CAS需要在操作值的時候檢查下值有沒有發生變化,如果沒有發生變化則更新,但是如果一個值原來是A,變成了B,又變成了A,那麼使用CAS進行檢查時會發現它的值沒有發生變化,但是實際上卻變化了。ABA問題的解決思路就是使用版本號。在變量前面追加上版本號,每次變量更新的時候把版本號加一,那麼A-B-A 就會變成1A-2B-3A。

從Java1.5開始JDK的atomic包里提供了一個類AtomicStampedReference來解決ABA問題。這個類的compareAndSet方法作用是首先檢查當前引用是否等於預期引用,並且當前標誌是否等於預期標誌,如果全部相等,則以原子方式將該引用和該標誌的值設置為給定的更新值。

  • 循環時間長開銷大:自旋CAS如果長時間不成功,會給CPU帶來非常大的執行開銷。如果JVM能支持處理器提供的pause指令那麼效率會有一定的提升,pause指令有兩個作用,第一它可以延遲流水線執行指令(de-pipeline),使CPU不會消耗過多的執行資源,延遲的時間取決於具體實現的版本,在一些處理器上延遲時間是零。第二它可以避免在退出循環的時候因內存順序衝突(memory order violation)而引起CPU流水線被清空(CPU pipeline flush),從而提高CPU的執行效率。

  • 只能保證一個共享變量的原子操作:當對一個共享變量執行操作時,我們可以使用循環CAS的方式來保證原子操作,但是對多個共享變量操作時,循環CAS就無法保證操作的原子性,這個時候就可以用鎖,或者有一個取巧的辦法,就是把多個共享變量合併成一個共享變量來操作。比如有兩個共享變量i=2,j=a,合併一下ij=2a,然後用CAS來操作ij。從Java1.5開始JDK提供了AtomicReference類來保證引用對象之間的原子性,你可以把多個變量放在一個對象里來進行CAS操作。

使用鎖來保證原子操作

還是以上面的列子為列,普通的計數器我們只需要在計數方法上加鎖就行了:

public synchronized void  add(int delta){
  this.count = count+delta;
}

執行結果如下:

normalCounter:1000000
safeCounter:1000000

兩個計數器都能拿到正確的結果

CPU是怎麼實現原子操作的

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

三個月(敏捷)項目收穫


項目背景

客戶已有運行多年的官網老站(PC端),想在今年對老站進行一次UI全面更新、功能全部平移的升級,對接新的運營後端,然後建立官網小程序端且與官網PC端進行聯動,使得品牌自有渠道能夠更加全面化。


挑戰

  • 時間緊。五月份進行Inception Workshop,確定項目交付範圍與架構方案。官網六月初開始開發,小程序八月份開始開發,整個項目九月中旬必須上線。
  • 系統集成和數據遷移。系統需要對接客戶的CRM,對接3個服務商,需要對老官網歷史數據(訂單、會員等)進行遷移。
  • 多團隊溝通。小程序設計稿由第三方提供,因此多出了溝通、確認的時間,以及把控第三方交付的時間,以避免交付進度的影響。


迭代計劃

Inception Workshop一結束,差不多就開始整理整個項目涉及的故事和技術卡,按照兩周一迭代進行迭代計劃安排並與客戶確認,每個迭代第一周周三安排跟客戶showcase上一周的預定的交付結果,得到反饋並安排進行改進。官網項目比較順利,改造自定義了一下SSR框架就能開始進行開發,並且因為歷史原因,還能享受到上一個項目遺留的一些福利,當然也少不了一些坑。

小程序的時間比較緊,相當於整個複製了一遍官網的功能,主要是前端任務,後端可以復用官網後端,因此一開始就給團隊同學同步到整個項目的情況,讓大家有一個大概的心理準備。然後就是與官網類似的處理,整個交付內容進行迭代排期並與客戶確認,前期盡量能多做一些,避免後期怎麼努力都無法完成的囧鏡。


項目進行時

整個項目的過程中,PM會根據迭代完成情況靈活的找外援加入項目進行支援,以免交付延期。每日的站會(Standup Meeting)更新,讓團隊能對當前進度有一個大概的了解以及同步一些突發信息。定期的回顧會議(Retrospective Meeting)能暴露團隊內部問題,將風險扼殺於苗頭,鼓勵能為團隊帶來正向幫助的行為,及時停止不好的做法。

迭代會議(IPM)能讓團隊對下一個迭代具體要做的事情有一個詳細的了解,進行大致的估點,以便check開發進度情況。技術人員定期的CodeReview成為一個大家交流的時段,發現風險,指出問題,互相提高,還可以幫助新人快速的融入團隊。

根據團隊內部人員情況,可以定期進行一對一溝通,了解個人訴求或是給與近況反饋都是一個不錯的渠道。TL應考慮團隊內部人員提升自己的訴求,在一些安排上給與傾斜和鼓勵,發現問題也需要提前制止。


不足之處

  • 後期對卡牆(Jira)的管理鬆懈。導致有些問題反覆修改,且丟失context
  • 項目對運營後台有一些的定製化配置,沒有提前準備運營需要了解的後台操作資料和培訓,導致後期花費大量精力幫助運營進行後台配置與更新
  • 人員(QA)變動頻繁。公司處於高速發展階段,項目經歷了4個QA,因此有些context可能丟失,測試不到位,導致項目上線出了一些低級問題。比如上線后發現部分瀏覽器有支付兼容問題
  • 甲乙方定位太角色化,不能站在專業角度評估客戶需求(項目做完感覺都一樣,客戶是爸爸)
  • 與第三方合作交付產物管控不到位,導致第三方設計稿的延遲影響到我們的交付計劃
  • 與客戶溝通的需求,後面有一些沒有進行郵件確認,導致交付驗收階段因一些需求上的問題產生不愉快(這個完全沒必要的)
  • 對第三方系統的了解不充分和集成系統的需求整理不清晰導致後續一系列的開發、測試都不到位,以致上線出了不可控的問題


項目總結

  • 提前評估項目的風險點,且在項目進行過程中持續維護,後期安排足夠的時間進行調研與分析
  • 與第三方合作一定要有自己的規劃,並且將定好的規劃提前與第三方確認時間,然後派人提前專門細緻的了解第三方需求詳細點,確定好具體的業務場景,再來規劃己方與第三方的具體集成的點。此外,在進行的過程中,還應注意定時檢查合作進度,管控風險
  • 與客戶溝通的所有需求都要進行郵件的二次確認,一個是能夠對所有需求來源有所記錄,另一個是能避免後面的不必要的消耗
  • 開發管理不能鬆懈,盡量做到所有的改動都能有卡,能夠進行追溯
  • 對後期交付時所需要的資料提前準備,對需要進行培訓的人員提前約好時間進行溝通培訓

在前端這塊的管理上,做的還不夠。前期經常codereview,然後效果都還不錯,讓我有了一些錯覺就是當前團隊趨於穩定,中後期即便是加班比較多,大家氣氛這塊我覺得都還好。不過在項目後期的時候,有些疏於管理,然後大家有些人也被分配到了其他項目,和同事們的交流不夠,沒有及時的顧及到一些個人情緒,這塊是可以加強的。

作為一個Lead,不論同事是否還在一個項目都應該及時的去了解近況,給與自己力所能及的幫助,這樣才能產生向心力,以幫助一些比較迷茫的同學找到方向,看見燈塔。

整個項目時間不長,得失還是挺多的,不論是管理還是技術上,都會有一些心得。然後項目的ROI還不錯,得到公司領導的肯定,最後客戶那邊的反饋也還不錯,算是對大家努力的一種認可。

ps: 及時總結,靜心沉澱;如風少年,砥礪前行。

如想了解更多,請移步

歡迎關注我的公眾號 “和F君一起xx”

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

微服務框架 – Jimu(積木) 升級 1.0.0 支持 .Net Core 3.0

如果不知道 Jimu(積木) 是啥,請移步
這次升級除了支持 .Net Core 3.0 還新增部分功能,如 REST, 鏈路跟蹤等,以下為詳細;

一、功能列表

功能 說明 Jimu 1.0.0 Jimu 0.6.0
平台 .Net Core 2.1 ○ ●
.Net Core 3.0 ● ○
服務註冊與發現 consul ● ●
網關 Asp.Net Core Web ● ●
RPC DotNetty ● ●
鑒權 JWT ● ●
負載均衡 輪訓 ● ●
容錯策略 重試 ● ●
容器 docker ● ●
路由配置 Attribute註解 ● ●
日誌記錄 log4net ● ●
nlog ● ●
文檔 swagger ● ●
鏈路跟蹤 skywalking ● ○
REST Attribute註解 ● ○
健康監測 心跳 ● ●
文件上存下載 多文件上存,單文件下載 ● ●
跳轉 在服務端跳轉到指定url ● ○
ORM Dapper ● ●
DDD MiniDDD ● ●

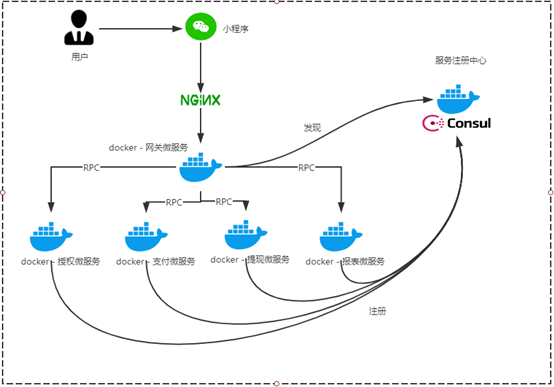
二、建議用積木結合 docker 搭建分佈式架構

三、swagger

四、skywalking

拓撲圖: user -> jimu_apigateway -> jimu_order -> jimu_user

Trace 跟蹤

五、網關

服務器

微服務

微服務詳細

六、源碼

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!